
Cupio fieri naturae. sed me uxor insanum.
Tokyo
Joined April 2007
- Tweets4.8K
- Following411
- Followers213
- Likes9.1K



(1965年生まれ) 中国の農村の最も裕福な層の家庭に男の子として生まれた。
いちばん幸せだった年は17歳、学びの節目を越えた年だった。
引退したあと、102歳のとき心筋梗塞などの虚血性心疾患で世を去った。
あなたの一度きりの人生は、どこで始まるだろう? #80億分の1 1in8b.life/ja/s/d-CHN-102-M-…
OHASHI Takeshi retweeted

さくらがレンタルサーバとかの新規加入止めた理由これらしい。Linuxの脆弱性(AI使って見つけたらしい)が見つかって、VPSとかのゲストVMからホストマシンのメモリが読み取れちゃうらしい。なんならホストのroot奪取できるとか。ヤバそう。Linuxの問題だからさくらだけじゃなくて全業者がやばそう。こんなやばい脆弱性、一通り対応が終わるまで公開するのもうちょっと待てやと思うんだけど、すでに外部にバレてたとかでもう公開しちゃったらしい

コンゴ民主共和国・ゴマのごく普通の家庭に女の子として生まれた。
孫4人、ひ孫10人に恵まれた。
引退したあと、93歳のとき心筋梗塞などの虚血性心疾患で世を去った。
同じ年に生まれた子どものうち3%は、わたしより長く生きる。
あなたはどこに生まれると思う? #80億分の1 1in8b.life/ja/s/d-COD-93-F-u…
OHASHI Takeshi retweeted

Perdí mi teléfono en la oficina y pasé 50 minutos revolviendo todo el lugar buscándolo. La función “Encontrar” estaba desactivada por el sistema MDM.
Sin más ideas, le pregunté a Claude cómo podía encontrarlo. Me sugirió rastrear la intensidad de la señal Bluetooth y, en aproximadamente un minuto, me creó un medidor.
Caminé por la oficina observando cómo aumentaba el número. Lo encontré.
Al parecer, ahora simplemente puedes crear la herramienta que necesitas.

Readers added context they thought people might want to know
La anécdota descrita fue publicada originalmente por @un1c0rnioz, quien también es el autor del código. x.com/un1c0rnioz/sta… github.com/ben-z/findphone
OHASHI Takeshi retweeted

MIXIの26新卒向け「AI技術研修」の講義動画がYouTubeで無料公開されてるんだけど、これ全エンジニアが絶対に見た方がいいレベルの神コンテンツだった。というか、MIXIの新卒者、これ、理解できるの?レベル高すぎだろ。合計約5時間、AIの基礎からLLMアプリの現場実装まで、実務目線のノウハウが惜しげもなく公開されてます。これ無料で観れるのバグでしょ…。
動画はDay1とDay2に分かれていて、内容がとにかく濃くて実践的、生きたコンテンツ。Day1でまずは実践、そのあとにDay2で理論と「逆引き学習」や「アジャイル学習」で構成されている👇
🟩 【Day1:AI・機械学習の基礎と実運用】 ・従来のプログラミングと機械学習の決定的な違い ・教師あり/なし/強化学習の仕組み ・Claude Codeを使ったAIコーディング支援の実践 ・モデルのデプロイやデータドリフトなど「運用」の生々しい課題
🟩 【Day2:LLMの仕組みとAIエージェント】 ・自然言語処理と分散表現(単語のベクトル化)の基礎 ・LLMの学習コストや裏側の仕組み ・Function Callingやマルチモーダルの活用 ・プロンプト評価、ベースライン作成から始めるLLMアプリ開発
ここがすごいのが単なるAIの教科書的な授業ではなく、「実際の開発現場でどうやってAIを活用・運用しているのか」「評価やデプロイの壁をどう乗り越えるか」という事業会社ならではのリアルな知見が詰まっています。特にMLOpsの話や、Reactを使った検証用UIの爆速構築などの現場感ある話は超実践的。
「AIツールを使える」状態から「AIをプロダクトに組み込める」エンジニアにステップアップしたい人は必見です。
週末のインプット教材としてこれ以上のものはないと思う。まとまった時間が取れる時に観るのがおすすめなので、忘れないようにブックマーク推奨🔖!
▼ Day1:AI研修(Day1)【MIXI 26新卒技術研修】 youtube.com/watch?v=da7hWlcc…
▼ Day2:AI研修(Day2)【MIXI 26新卒技術研修】 youtube.com/watch?v=F0OVgcgi…

OHASHI Takeshi retweeted

Kimi K3は、フロンティアモデルに匹敵する性能を持つオープンウェイトモデルである。Technical Reportが公開されたので、重要な点をまとめる。
Kimi K3は、総パラメータ数2.8T、活性パラメータ数104BのMoEモデルである。アーキテクチャ、データ、ハイパーパラメータ、学習手法を総合的に改善し、Kimi K2と比べて、同じvalidation lossに到達するために必要な学習計算量を約2.5分の1にしたと主張している。
* アーキテクチャ
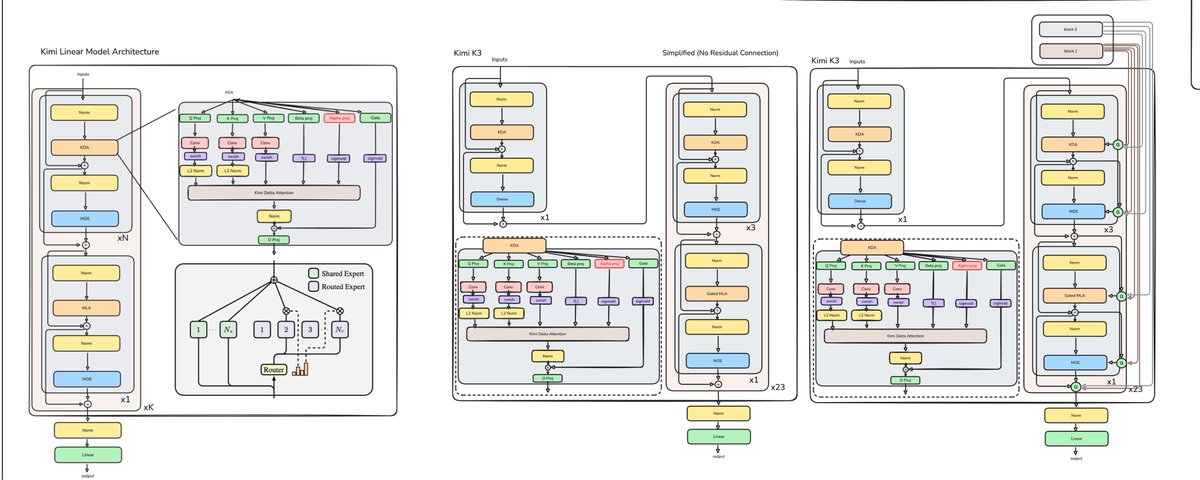
Kimi K3のアーキテクチャは、系列方向、深さ方向、幅方向という三つの情報流を、それぞれ拡張するように設計されている。
系列方向では、Kimi Delta Attention(KDA)とMulti-head Latent Attention(MLA)を組み合わせる。モデル全体は93層からなり、基本的には3層のKDAと1層のGated MLAを一つのブロックとして繰り返す。
KDAは、過去の履歴を固定サイズの状態行列へ圧縮する線形アテンションである。従来のDeltaNet系の構造を拡張し、過去の情報をどの程度保持するかをチャネルごとに調整できる。
KDAの基になったKimi Linearでは、忘却率が極端に小さくなる可能性があり、チャンク並列計算において累積減衰の逆数が過大になり、オーバーフローなどの数値不安定性を引き起こす問題があった。Kimi K3では、対数減衰に下限を設けている。
この変更により、以前は特殊なposition-pair計算が必要だった対角タイルも、Tensor Core上の密行列積として処理できるようになった。数式上は小さな変更だが、GPUカーネルを単純化し、学習速度を改善する重要な工夫である。
MLA層では、RoPEなどの明示的な位置符号化を使っていない。Kimi Linearでも示されていたように、位置や順序に関する情報は主にKDA側が担い、MLAは主として内容に基づくグローバルな情報検索を担当する。
この役割分担によって、コンテキスト長を拡張する際に、RoPEの周波数調整や補間を行う必要がない。
ただし、位置符号化の変更が不要だからといって、学習なしで100万トークンを利用できるわけではなく、Kimi K3は、8K、64K、256K、1Mと段階的にコンテキスト長を伸ばして学習している。
技術報告では、8Kから64Kまでをpre-training中に実行し、学習の最終段階であるcooldownにおいて256K、1Mに拡張したとしている。
次に特徴的なのが、深さ方向の情報流を改善するAttention Residualsである。
通常のTransformerでは、過去の層の情報が残差接続によって順番に加算され、一つのhidden stateへ集約される。深さ方向で見ると、過去の情報を単一の状態へ圧縮していくRNNのような構造になっている。
Attention Residualsでは、各層が過去の層やブロックの表現に対してattentionを行い、必要な深さの表現を選択的に取得する。
この実現にあたり、各層は、学習可能なpseudo-queryベクトルを持つ。このqueryは入力から計算されるのではなく、層ごとに保持される学習可能なパラメータである。一方、keyとvalueには、各入力トークンに対する過去の層出力が使われる。
pseudo-queryは、「この層がどのような種類の表現を必要としているか」を表す検索テンプレートとみなせる。query自体は入力に依存しないが、keyは入力に依存するため、実際のattention weightはトークンごとに変化する。
独立した学習可能ベクトルをqueryとして使うことで、各トークン、各層について大きなquery projectionを計算する必要がなくなる。また、Attention Residualsによって作られる現在層への入力からqueryを生成しようとした場合に生じる循環依存も避けられ、実装が単純になる。
Kimi K3では、全93層をおおむね12層ずつのブロックに分け、過去の全層ではなく、主としてブロック単位の表現にattentionするBlock Attention Residualsを用いている。これにより、過去の全層出力を保持するためのメモリと、pipeline parallelism時の通信量を削減している。
幅方向では、Stable LatentMoEを用いる。
Kimi K3には896個のrouted expertがあり、各トークンについて16個が選ばれる。ただし、各expertへ7168次元のhidden stateをそのまま送るわけではなく、expertへ入る前に3584次元のlatent空間へ圧縮し、expert処理後に元の幅へ戻す。一方、全トークンに共通して使われる2個のshared expertは、元の全幅で動作する。
Kimi K2では384個のrouted expertから8個を選択していたのに対し、Kimi K3ではexpert候補数が約2.3倍、同時に活性化するexpert数が2倍になっている。sparsity ratioはKimi K2の48に対してKimi K3は56であり、似たレベルである。より多くの専門的なexpertを組み合わせながら、latent空間を使うことで計算量と通信量を抑えている。
さらに、routed expertの集約後にRMSNormを挿入し、SwiGLUの代わりにSiTU-GLUを導入している。SiTU-GLUは、SwiGLUの原点付近における性質を保ちながら、大きな入力をtanhによって滑らかに飽和させる。Kimi K3の設定では、各出力座標の絶対値が最大100に抑えられる。大規模かつ極端に疎なMoEにおけるactivation explosionを防ぐための設計である。
また、expert負荷の均衡にはQuantile Balancingを使う。
従来方式では、過剰に使われたexpertのbiasを少し下げ、使われていないexpertのbiasを少し上げる更新を繰り返していた。しかし、896個のexpertを扱う場合、このような固定幅の更新では追従が遅く、負荷が振動しやすい。
Quantile Balancingでは、各expertが目標数のトークンを受け取るように、router scoreのmarginの分位点から次のbiasを直接推定する。
実際には、全marginを一箇所へ集めるのではなく、expertごとのhistogramをall-reduceし、全体の分位点を近似する。
さらに、Kimi K3は画像と動画を事前学習の段階から統合している。画像・動画のencoderには、約4億パラメータ、27層のMoonViT-V2を用いる。Kimi K3では、SigLIPなどで事前学習したvision encoderを接続するのではなく、vision encoderも言語モデルと同時にscratchから学習している。
技術報告では、SigLIPで初期化したencoderよりも、next-token predictionによってscratchから学習したMoonViT-V2の方がgradient normが安定し、最終的なvision評価も同等だったと報告している。
事前学習
===
事前学習は8K contextから始まり、その後64Kへ拡張される。さらに、学習の最終段階であるcooldownにおいて、256K、1Mへ伸ばしている。
一般的には4K~8Kなのに対し、64Kまでが事前学習の範囲とされているのが興味深い。どの規模でされたかの証明は示されていない。
自然な長文や動画には、重複、壊れたファイル、無効なlog、途中で切れたデータ、類似したframeの連続などが多く含まれる。そのため、長文専用のcleaning pipelineを用いて、重複除去、品質判定、構造検証を行う。
また、本当に長く一貫した文書や動画は短いデータに比べて少ないため、cooldownでは長文データを相対的にupsampleする。
ただし、長いsequenceを見せるだけでは、モデルが近くの情報だけを利用し、遠距離の情報を無視する可能性がある。そこで、複数の文書やsub-taskを並べ替えて連結し、100万トークンの中に分散した情報を集めなければ解けないような合成課題も作っている。
事後学習
===
事後学習は、SFT、RL、Multi-Teacher On-Policy Distillationの三段階で行う。
まずSFTによって、tool callingやagent trajectoryの基礎を学習する。
次に、general tasks、general agents、coding agentsという三領域について、それぞれlow、high、maxの三段階のreasoning effortを学習する。これにより、合計9個の専門policyが作られる。
まず、特定のエージェント実装への過学習を防ぐため、ツール、system prompt、memory、context management、subagentなどを交換可能な部品として構成する。Kimi CodeやClaude Code、Codexに近い形式だけでなく、未知の構成でも学習させることで、特定のハーネスに依存しない能力を目指している。
RL課題の生成には、自己拡張する知識グラフを利用する。数学、物理、化学、コンピュータ科学などの大分類から始め、エージェントがWeb検索を行いながら、より細かな概念へ分解する。そこから論文、ブログ、コードリポジトリなどを収集し、知識問題、コーディング、視覚推論などの課題を合成する。
学習対象は多岐にわたる。検索や法律、金融、データ分析などの専門業務に加え、画像をPythonでcrop、zoom、変換しながら解く視覚課題、CUDAやTritonを用いたGPUカーネル最適化なども含まれる。
また、Gmail、Slack、Notionなどを模した環境を構築し、複数日にわたるpersonal assistant課題も学習する。一つのrolloutが数千回のtool call、数百万context tokensに達することもある。
Autonomous Execution Tasksでは、正解手順を与えず、初期状態、目標、制約、ツール、実行予算だけを与える。モデルは自ら計画し、ツールを使い、失敗から回復し、最終状態を外部verifierに評価させる。公開verifierだけに過適合することを防ぐため、モデルには見えないhidden verifierも用いる。
Web開発では、Webサイト、ゲーム、3D、データ可視化、full-stack applicationなどを生成する。buildの成否、実行時error、機能、見た目、操作結果を評価し、画像を貼り付けただけの偽装などは報酬をゼロにする。
その後、9個の専門モデルを一つに統合するため、Multi-Teacher On-Policy Distillation(MOPD)を行う。
RL学習環境
===
長期エージェントRLでは、一つのtrajectoryが数百から数千回のtool callを含み、累積context tokensが数百万に達することもある。
すべてのtrajectoryの終了を待つと、一部の非常に長いtrajectoryが学習全体を待たせる。そのため、一定割合のrolloutが完了した時点でpolicy updateへ進み、未完了trajectoryは次のiterationで再開するpartial rolloutを使う。
未完了trajectoryを再開するには、モデル側のKV cacheと、外部環境側のsandbox stateの両方を保持する必要がある。
Kimi K3では、GPUからevictされた長いprefixをCPU DRAM上のexternal KV cache poolへ保存する。また、Firecrackerを用いたmicroVM sandboxであるAgentENVを使い、sandboxをpause、resume、fork、snapshotできるようにしている。
報告では、checkpointが最短133ミリ秒、resumeが最短49ミリ秒であり、学習と評価全体で約5122万個のsandboxが作成されたとしている。
学習基盤
===
KDAでは、各sequence segmentの作用を、入力状態に作用するtransitionと、zero stateから生成される局所状態に分解する。
これらの変換は結合可能であるため、prefix scanによって各GPUに必要な初期状態を計算できる。
MoE学習にはMoonEPを用いる。必要に応じてexpertを別rankへ動的に複製し、すべてのexpert parallel rankが正確に同数のトークンを処理するようにする。技術報告では、各rankに最大E/R個のredundant expert slotを確保すれば、完全に均衡した割り当てが常に存在することを示している。ここでEはexpert数、Rはexpert parallel rank数である。
完全に負荷を均衡できれば、遅いrankを待つ時間がなくなるだけでなく、通信bufferや計算shapeを固定でき、各層でhost側へ同期してtoken数を確認する処理も不要になる。
推論
==
推論時には、KDAの固定サイズ状態と、MLAの系列長に比例するKV cacheを、同じpaged cache managerで管理する。
MLAは細かいtoken境界でprefixを再利用する一方、KDA stateは大きいため、conversation turnなどの限られた境界でcheckpointする。
投機的デコーディングでは、draft tokenごとに巨大なKDA stateを保存せず、小さなprojection inputだけを保存する。
draft tokenの一部がrejectされた場合は、acceptされた部分についてKDA stateをGPU上で再計算し、正しい状態へ戻す。
性能評価
===
性能評価では、Kimi K3は総合的にClaude Fable 5とGPT-5.6 Solの直下に位置し、技術報告で比較された多くのオープンモデルおよびプロプライエタリモデルを上回っている。
特に、コーディング、検索、調査、長期ツール利用を必要とする課題で強い。
一方、Humanity’s Last ExamやCritPtのような研究レベルの推論、OSWorld 2.0のような難しいcomputer use、長期的な行動規律や複雑な協調では、最上位モデルとの差が残っている。
なお、技術報告では、以下の情報は公開されていない。
総事前学習トークン数、最終的なデータ配分、総学習FLOPs、使用GPU数、学習期間、実測MFU、各context lengthでの学習トークン数である。
コメント
===
Kimi K3は、現時点で最も強力なオープンウェイトモデルの一つであり、そのアーキテクチャ、学習方法、システム実装をまとめた重要な資料である。
新技術があるというよりも、必要な技術を幅広く取り込み、それぞれを大規模モデルで実際に動作するまで作り込んでいるという印象が強い。
モデル開発をしている立場から、特に印象的だった点は次の二つである。
・Kimi K2に引き続き、事後学習におけるエージェントRL環境へ非常に大きな投資をしている。テキスト、画像、コード、Web、業務アプリケーション、GPU kernelなどを含む多様なエージェント課題を合成し、長期間にわたるtool useと試行錯誤を学習させている。この部分については、改めて詳しく紹介したい。
・十分なablation studyが提供されていないため、それぞれの技術選択が、どのような比較や判断に基づいて行われたのかは分からない部分が多い。KDA、Attention Residuals、Stable LatentMoE、SiTU-GLU、Quantile Balancing、Per-Head Muonなどの個別技術が、最終性能や学習効率改善にどの程度寄与したのかは分解されていない。
実際には、内部実験の結果、学習安定性、GPUカーネルの効率、分散学習時の通信、メモリ制約など、さまざまな要因を総合して選択したと考えられる。
OHASHI Takeshi retweeted

知能指数が低い人は、有名人に対して病的な崇拝示す傾向があります。
いわゆる「推し活」は、低IQほどハマりやすい。
KPOP・ジャニーズはじめとしたアイドルのコアファンに、知能的に危ない人が多い理由はこれ。
アイドルビジネスの基本戦略は、まず知能指数の低いコアファンを集める。
それを「ファンクラブ会員数」「楽曲DL数」などの中身のわからないキレイな数字に変換して人気者を演出し、一般人に認知を広げていく。
人気者だから人気になる理論。
これがSNSならフォロワー数や各種エンゲージメント数です。
「やばいファンを単なる数字に変換して、人気を演出する」は、あらゆるファンビジネスに通用する方法論です。


OHASHI Takeshi retweeted

山田五郎さんがお亡くなりになった。
享年67歳。
🙏合掌🙏
YouTube「大人の教養ちゃんねる」での芸術談義はpandemicの鬱々としていた期間、救いでした。
僕の京都,京セラミュージアムでの個展の時に、トークショーに出席していただいて、お話をして頂いた。
数日前にアップされた最新のYouTubeを観ると、最新刊が出版されたとのこと。
最後まで歴史を紡がれて御立派でした。
本当にお疲れ様でした。
youtu.be/LLTLVdXcRnQ?si=aBVc…


OHASHI Takeshi retweeted
東京メトロの地下の3Dマップが完成しました!!
tokyo-danmenzu.pages.dev/
地表面との高低差も可視化しており、ぐりぐり動かせます!🚇
※アナログ・デジタル両方で既往事例がありますが、各駅の深さから擬似的に補間されたものが多く、建設図面(縦断面図)から各区間を詳細に読み取り作成しました。
NUROモバイルを申し込みしようとしたらミドルネームが入らなくて、マイナンバーカードを使って認証ができなくて詰んだ。ahamoだと対応しているのに。faq.ahamo.com/faq/show/417?c…
OHASHI Takeshi retweeted

無申請・無許可で建てられた川越モスク。しかも開所式には駐日🇵🇰大使まで出席していたことに驚く。
しかしまぁ、この広大な敷地にミナレットまで携えた立派なモスクが易々と違法建築されてしまう日本って、一体いつからこうなってしまったんだ。
完全に舐められてるんだよ。行政は仕事しろマジで。
Claude MythosやOpenAI Cyberが優秀ならば、そのうち六法全書や判例を全部読み込んで法の穴を見つけることも簡単な気がする。つまるところ、人間よりもAIの方が部分的に勝るようになってきた。そのうち全敗するのかも。

OHASHI Takeshi retweeted

なんでもオープンソースになっていくな...
Claude Design → Open CoDesign
CapCut →OpenCut
Notion → AFFiNE
Slack → Mattermost
Figma → OpenPencil
Screen Studio → OpenScreen
Loom → Cap
リプにGithubリンクまとめておきました👇
SQLiteをDBサーバーにした、libSQLという軽量DBサーバーもありますね。Tursoで提供。

这种牛人几乎不可能复制吧!
真正的软件传奇,从来不是谁赚得最多,而是谁让全世界都离不开他,却一分钱都没收过。
2000年,D. Richard Hipp在为美国海军一艘导弹驱逐舰的损伤控制系统工作时,受合同委托开发了SQLite。
他当时烦透了那些又笨又重、服务器一挂就全完蛋的数据库。
于是直接搞出了一个单文件、零配置、零服务器的数据库引擎,专门解决军舰上服务器故障时的可靠性问题。
他把全部代码扔进公共领域,永久免费。
25年后,这玩意儿已经跑在全球超过1万亿个数据库里:每台iPhone、Android、Mac、Windows、Chrome、WhatsApp、特斯拉、商用飞机……
无处不在。
而他呢?
至今只带3个人全职维护,还承诺免费支持到2050年。
这才是真正的Database GOAT。
你觉得SQLite算不算软件史上最被低估的奇迹?
