
Cupio fieri naturae. sed me uxor insanum.
Tokyo
Joined April 2007
- Tweets4.8K
- Following411
- Followers213
- Likes9.1K



OHASHI Takeshi retweeted

さくらがレンタルサーバとかの新規加入止めた理由これらしい。Linuxの脆弱性(AI使って見つけたらしい)が見つかって、VPSとかのゲストVMからホストマシンのメモリが読み取れちゃうらしい。なんならホストのroot奪取できるとか。ヤバそう。Linuxの問題だからさくらだけじゃなくて全業者がやばそう。こんなやばい脆弱性、一通り対応が終わるまで公開するのもうちょっと待てやと思うんだけど、すでに外部にバレてたとかでもう公開しちゃったらしい

OHASHI Takeshi retweeted

Perdí mi teléfono en la oficina y pasé 50 minutos revolviendo todo el lugar buscándolo. La función “Encontrar” estaba desactivada por el sistema MDM.
Sin más ideas, le pregunté a Claude cómo podía encontrarlo. Me sugirió rastrear la intensidad de la señal Bluetooth y, en aproximadamente un minuto, me creó un medidor.
Caminé por la oficina observando cómo aumentaba el número. Lo encontré.
Al parecer, ahora simplemente puedes crear la herramienta que necesitas.

Readers added context they thought people might want to know
La anécdota descrita fue publicada originalmente por @un1c0rnioz, quien también es el autor del código. x.com/un1c0rnioz/sta… github.com/ben-z/findphone
OHASHI Takeshi retweeted

MIXIの26新卒向け「AI技術研修」の講義動画がYouTubeで無料公開されてるんだけど、これ全エンジニアが絶対に見た方がいいレベルの神コンテンツだった。というか、MIXIの新卒者、これ、理解できるの?レベル高すぎだろ。合計約5時間、AIの基礎からLLMアプリの現場実装まで、実務目線のノウハウが惜しげもなく公開されてます。これ無料で観れるのバグでしょ…。
動画はDay1とDay2に分かれていて、内容がとにかく濃くて実践的、生きたコンテンツ。Day1でまずは実践、そのあとにDay2で理論と「逆引き学習」や「アジャイル学習」で構成されている👇
🟩 【Day1:AI・機械学習の基礎と実運用】 ・従来のプログラミングと機械学習の決定的な違い ・教師あり/なし/強化学習の仕組み ・Claude Codeを使ったAIコーディング支援の実践 ・モデルのデプロイやデータドリフトなど「運用」の生々しい課題
🟩 【Day2:LLMの仕組みとAIエージェント】 ・自然言語処理と分散表現(単語のベクトル化)の基礎 ・LLMの学習コストや裏側の仕組み ・Function Callingやマルチモーダルの活用 ・プロンプト評価、ベースライン作成から始めるLLMアプリ開発
ここがすごいのが単なるAIの教科書的な授業ではなく、「実際の開発現場でどうやってAIを活用・運用しているのか」「評価やデプロイの壁をどう乗り越えるか」という事業会社ならではのリアルな知見が詰まっています。特にMLOpsの話や、Reactを使った検証用UIの爆速構築などの現場感ある話は超実践的。
「AIツールを使える」状態から「AIをプロダクトに組み込める」エンジニアにステップアップしたい人は必見です。
週末のインプット教材としてこれ以上のものはないと思う。まとまった時間が取れる時に観るのがおすすめなので、忘れないようにブックマーク推奨🔖!
▼ Day1:AI研修(Day1)【MIXI 26新卒技術研修】 youtube.com/watch?v=da7hWlcc…
▼ Day2:AI研修(Day2)【MIXI 26新卒技術研修】 youtube.com/watch?v=F0OVgcgi…

OHASHI Takeshi retweeted

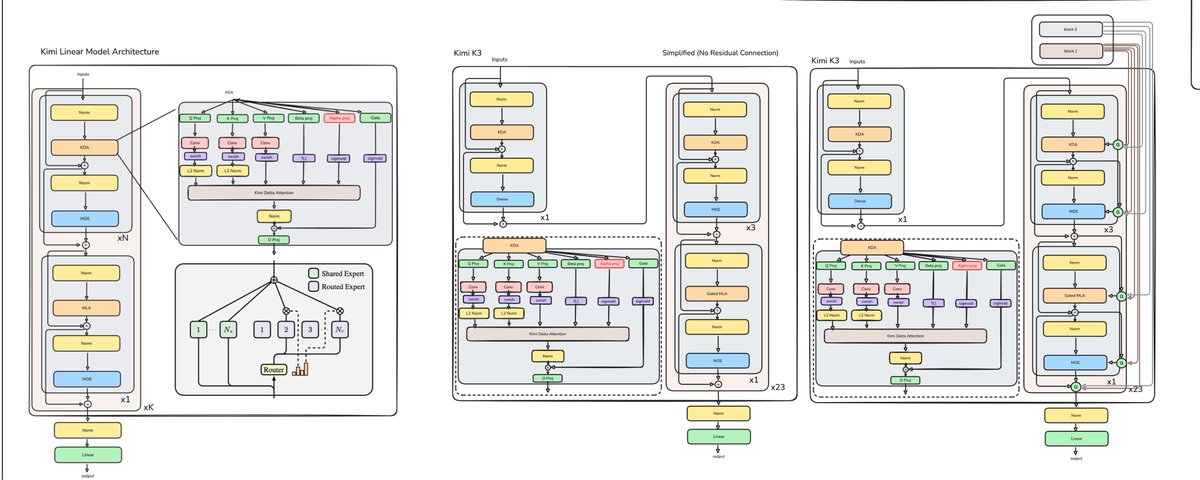
Kimi K3は、フロンティアモデルに匹敵する性能を持つオープンウェイトモデルである。Technical Reportが公開されたので、重要な点をまとめる。
Kimi K3は、総パラメータ数2.8T、活性パラメータ数104BのMoEモデルである。アーキテクチャ、データ、ハイパーパラメータ、学習手法を総合的に改善し、Kimi K2と比べて、同じvalidation lossに到達するために必要な学習計算量を約2.5分の1にしたと主張している。
* アーキテクチャ
Kimi K3のアーキテクチャは、系列方向、深さ方向、幅方向という三つの情報流を、それぞれ拡張するように設計されている。
系列方向では、Kimi Delta Attention(KDA)とMulti-head Latent Attention(MLA)を組み合わせる。モデル全体は93層からなり、基本的には3層のKDAと1層のGated MLAを一つのブロックとして繰り返す。
KDAは、過去の履歴を固定サイズの状態行列へ圧縮する線形アテンションである。従来のDeltaNet系の構造を拡張し、過去の情報をどの程度保持するかをチャネルごとに調整できる。
KDAの基になったKimi Linearでは、忘却率が極端に小さくなる可能性があり、チャンク並列計算において累積減衰の逆数が過大になり、オーバーフローなどの数値不安定性を引き起こす問題があった。Kimi K3では、対数減衰に下限を設けている。
この変更により、以前は特殊なposition-pair計算が必要だった対角タイルも、Tensor Core上の密行列積として処理できるようになった。数式上は小さな変更だが、GPUカーネルを単純化し、学習速度を改善する重要な工夫である。
MLA層では、RoPEなどの明示的な位置符号化を使っていない。Kimi Linearでも示されていたように、位置や順序に関する情報は主にKDA側が担い、MLAは主として内容に基づくグローバルな情報検索を担当する。
この役割分担によって、コンテキスト長を拡張する際に、RoPEの周波数調整や補間を行う必要がない。
ただし、位置符号化の変更が不要だからといって、学習なしで100万トークンを利用できるわけではなく、Kimi K3は、8K、64K、256K、1Mと段階的にコンテキスト長を伸ばして学習している。
技術報告では、8Kから64Kまでをpre-training中に実行し、学習の最終段階であるcooldownにおいて256K、1Mに拡張したとしている。
次に特徴的なのが、深さ方向の情報流を改善するAttention Residualsである。
通常のTransformerでは、過去の層の情報が残差接続によって順番に加算され、一つのhidden stateへ集約される。深さ方向で見ると、過去の情報を単一の状態へ圧縮していくRNNのような構造になっている。
Attention Residualsでは、各層が過去の層やブロックの表現に対してattentionを行い、必要な深さの表現を選択的に取得する。
この実現にあたり、各層は、学習可能なpseudo-queryベクトルを持つ。このqueryは入力から計算されるのではなく、層ごとに保持される学習可能なパラメータである。一方、keyとvalueには、各入力トークンに対する過去の層出力が使われる。
pseudo-queryは、「この層がどのような種類の表現を必要としているか」を表す検索テンプレートとみなせる。query自体は入力に依存しないが、keyは入力に依存するため、実際のattention weightはトークンごとに変化する。
独立した学習可能ベクトルをqueryとして使うことで、各トークン、各層について大きなquery projectionを計算する必要がなくなる。また、Attention Residualsによって作られる現在層への入力からqueryを生成しようとした場合に生じる循環依存も避けられ、実装が単純になる。
Kimi K3では、全93層をおおむね12層ずつのブロックに分け、過去の全層ではなく、主としてブロック単位の表現にattentionするBlock Attention Residualsを用いている。これにより、過去の全層出力を保持するためのメモリと、pipeline parallelism時の通信量を削減している。
幅方向では、Stable LatentMoEを用いる。
Kimi K3には896個のrouted expertがあり、各トークンについて16個が選ばれる。ただし、各expertへ7168次元のhidden stateをそのまま送るわけではなく、expertへ入る前に3584次元のlatent空間へ圧縮し、expert処理後に元の幅へ戻す。一方、全トークンに共通して使われる2個のshared expertは、元の全幅で動作する。
Kimi K2では384個のrouted expertから8個を選択していたのに対し、Kimi K3ではexpert候補数が約2.3倍、同時に活性化するexpert数が2倍になっている。sparsity ratioはKimi K2の48に対してKimi K3は56であり、似たレベルである。より多くの専門的なexpertを組み合わせながら、latent空間を使うことで計算量と通信量を抑えている。
さらに、routed expertの集約後にRMSNormを挿入し、SwiGLUの代わりにSiTU-GLUを導入している。SiTU-GLUは、SwiGLUの原点付近における性質を保ちながら、大きな入力をtanhによって滑らかに飽和させる。Kimi K3の設定では、各出力座標の絶対値が最大100に抑えられる。大規模かつ極端に疎なMoEにおけるactivation explosionを防ぐための設計である。
また、expert負荷の均衡にはQuantile Balancingを使う。
従来方式では、過剰に使われたexpertのbiasを少し下げ、使われていないexpertのbiasを少し上げる更新を繰り返していた。しかし、896個のexpertを扱う場合、このような固定幅の更新では追従が遅く、負荷が振動しやすい。
Quantile Balancingでは、各expertが目標数のトークンを受け取るように、router scoreのmarginの分位点から次のbiasを直接推定する。
実際には、全marginを一箇所へ集めるのではなく、expertごとのhistogramをall-reduceし、全体の分位点を近似する。
さらに、Kimi K3は画像と動画を事前学習の段階から統合している。画像・動画のencoderには、約4億パラメータ、27層のMoonViT-V2を用いる。Kimi K3では、SigLIPなどで事前学習したvision encoderを接続するのではなく、vision encoderも言語モデルと同時にscratchから学習している。
技術報告では、SigLIPで初期化したencoderよりも、next-token predictionによってscratchから学習したMoonViT-V2の方がgradient normが安定し、最終的なvision評価も同等だったと報告している。
事前学習
===
事前学習は8K contextから始まり、その後64Kへ拡張される。さらに、学習の最終段階であるcooldownにおいて、256K、1Mへ伸ばしている。
一般的には4K~8Kなのに対し、64Kまでが事前学習の範囲とされているのが興味深い。どの規模でされたかの証明は示されていない。
自然な長文や動画には、重複、壊れたファイル、無効なlog、途中で切れたデータ、類似したframeの連続などが多く含まれる。そのため、長文専用のcleaning pipelineを用いて、重複除去、品質判定、構造検証を行う。
また、本当に長く一貫した文書や動画は短いデータに比べて少ないため、cooldownでは長文データを相対的にupsampleする。
ただし、長いsequenceを見せるだけでは、モデルが近くの情報だけを利用し、遠距離の情報を無視する可能性がある。そこで、複数の文書やsub-taskを並べ替えて連結し、100万トークンの中に分散した情報を集めなければ解けないような合成課題も作っている。
事後学習
===
事後学習は、SFT、RL、Multi-Teacher On-Policy Distillationの三段階で行う。
まずSFTによって、tool callingやagent trajectoryの基礎を学習する。
次に、general tasks、general agents、coding agentsという三領域について、それぞれlow、high、maxの三段階のreasoning effortを学習する。これにより、合計9個の専門policyが作られる。
まず、特定のエージェント実装への過学習を防ぐため、ツール、system prompt、memory、context management、subagentなどを交換可能な部品として構成する。Kimi CodeやClaude Code、Codexに近い形式だけでなく、未知の構成でも学習させることで、特定のハーネスに依存しない能力を目指している。
RL課題の生成には、自己拡張する知識グラフを利用する。数学、物理、化学、コンピュータ科学などの大分類から始め、エージェントがWeb検索を行いながら、より細かな概念へ分解する。そこから論文、ブログ、コードリポジトリなどを収集し、知識問題、コーディング、視覚推論などの課題を合成する。
学習対象は多岐にわたる。検索や法律、金融、データ分析などの専門業務に加え、画像をPythonでcrop、zoom、変換しながら解く視覚課題、CUDAやTritonを用いたGPUカーネル最適化なども含まれる。
また、Gmail、Slack、Notionなどを模した環境を構築し、複数日にわたるpersonal assistant課題も学習する。一つのrolloutが数千回のtool call、数百万context tokensに達することもある。
Autonomous Execution Tasksでは、正解手順を与えず、初期状態、目標、制約、ツール、実行予算だけを与える。モデルは自ら計画し、ツールを使い、失敗から回復し、最終状態を外部verifierに評価させる。公開verifierだけに過適合することを防ぐため、モデルには見えないhidden verifierも用いる。
Web開発では、Webサイト、ゲーム、3D、データ可視化、full-stack applicationなどを生成する。buildの成否、実行時error、機能、見た目、操作結果を評価し、画像を貼り付けただけの偽装などは報酬をゼロにする。
その後、9個の専門モデルを一つに統合するため、Multi-Teacher On-Policy Distillation(MOPD)を行う。
RL学習環境
===
長期エージェントRLでは、一つのtrajectoryが数百から数千回のtool callを含み、累積context tokensが数百万に達することもある。
すべてのtrajectoryの終了を待つと、一部の非常に長いtrajectoryが学習全体を待たせる。そのため、一定割合のrolloutが完了した時点でpolicy updateへ進み、未完了trajectoryは次のiterationで再開するpartial rolloutを使う。
未完了trajectoryを再開するには、モデル側のKV cacheと、外部環境側のsandbox stateの両方を保持する必要がある。
Kimi K3では、GPUからevictされた長いprefixをCPU DRAM上のexternal KV cache poolへ保存する。また、Firecrackerを用いたmicroVM sandboxであるAgentENVを使い、sandboxをpause、resume、fork、snapshotできるようにしている。
報告では、checkpointが最短133ミリ秒、resumeが最短49ミリ秒であり、学習と評価全体で約5122万個のsandboxが作成されたとしている。
学習基盤
===
KDAでは、各sequence segmentの作用を、入力状態に作用するtransitionと、zero stateから生成される局所状態に分解する。
これらの変換は結合可能であるため、prefix scanによって各GPUに必要な初期状態を計算できる。
MoE学習にはMoonEPを用いる。必要に応じてexpertを別rankへ動的に複製し、すべてのexpert parallel rankが正確に同数のトークンを処理するようにする。技術報告では、各rankに最大E/R個のredundant expert slotを確保すれば、完全に均衡した割り当てが常に存在することを示している。ここでEはexpert数、Rはexpert parallel rank数である。
完全に負荷を均衡できれば、遅いrankを待つ時間がなくなるだけでなく、通信bufferや計算shapeを固定でき、各層でhost側へ同期してtoken数を確認する処理も不要になる。
推論
==
推論時には、KDAの固定サイズ状態と、MLAの系列長に比例するKV cacheを、同じpaged cache managerで管理する。
MLAは細かいtoken境界でprefixを再利用する一方、KDA stateは大きいため、conversation turnなどの限られた境界でcheckpointする。
投機的デコーディングでは、draft tokenごとに巨大なKDA stateを保存せず、小さなprojection inputだけを保存する。
draft tokenの一部がrejectされた場合は、acceptされた部分についてKDA stateをGPU上で再計算し、正しい状態へ戻す。
性能評価
===
性能評価では、Kimi K3は総合的にClaude Fable 5とGPT-5.6 Solの直下に位置し、技術報告で比較された多くのオープンモデルおよびプロプライエタリモデルを上回っている。
特に、コーディング、検索、調査、長期ツール利用を必要とする課題で強い。
一方、Humanity’s Last ExamやCritPtのような研究レベルの推論、OSWorld 2.0のような難しいcomputer use、長期的な行動規律や複雑な協調では、最上位モデルとの差が残っている。
なお、技術報告では、以下の情報は公開されていない。
総事前学習トークン数、最終的なデータ配分、総学習FLOPs、使用GPU数、学習期間、実測MFU、各context lengthでの学習トークン数である。
コメント
===
Kimi K3は、現時点で最も強力なオープンウェイトモデルの一つであり、そのアーキテクチャ、学習方法、システム実装をまとめた重要な資料である。
新技術があるというよりも、必要な技術を幅広く取り込み、それぞれを大規模モデルで実際に動作するまで作り込んでいるという印象が強い。
モデル開発をしている立場から、特に印象的だった点は次の二つである。
・Kimi K2に引き続き、事後学習におけるエージェントRL環境へ非常に大きな投資をしている。テキスト、画像、コード、Web、業務アプリケーション、GPU kernelなどを含む多様なエージェント課題を合成し、長期間にわたるtool useと試行錯誤を学習させている。この部分については、改めて詳しく紹介したい。
・十分なablation studyが提供されていないため、それぞれの技術選択が、どのような比較や判断に基づいて行われたのかは分からない部分が多い。KDA、Attention Residuals、Stable LatentMoE、SiTU-GLU、Quantile Balancing、Per-Head Muonなどの個別技術が、最終性能や学習効率改善にどの程度寄与したのかは分解されていない。
実際には、内部実験の結果、学習安定性、GPUカーネルの効率、分散学習時の通信、メモリ制約など、さまざまな要因を総合して選択したと考えられる。
OHASHI Takeshi retweeted

知能指数が低い人は、有名人に対して病的な崇拝示す傾向があります。
いわゆる「推し活」は、低IQほどハマりやすい。
KPOP・ジャニーズはじめとしたアイドルのコアファンに、知能的に危ない人が多い理由はこれ。
アイドルビジネスの基本戦略は、まず知能指数の低いコアファンを集める。
それを「ファンクラブ会員数」「楽曲DL数」などの中身のわからないキレイな数字に変換して人気者を演出し、一般人に認知を広げていく。
人気者だから人気になる理論。
これがSNSならフォロワー数や各種エンゲージメント数です。
「やばいファンを単なる数字に変換して、人気を演出する」は、あらゆるファンビジネスに通用する方法論です。


OHASHI Takeshi retweeted

山田五郎さんがお亡くなりになった。
享年67歳。
🙏合掌🙏
YouTube「大人の教養ちゃんねる」での芸術談義はpandemicの鬱々としていた期間、救いでした。
僕の京都,京セラミュージアムでの個展の時に、トークショーに出席していただいて、お話をして頂いた。
数日前にアップされた最新のYouTubeを観ると、最新刊が出版されたとのこと。
最後まで歴史を紡がれて御立派でした。
本当にお疲れ様でした。
youtu.be/LLTLVdXcRnQ?si=aBVc…


OHASHI Takeshi retweeted
東京メトロの地下の3Dマップが完成しました!!
tokyo-danmenzu.pages.dev/
地表面との高低差も可視化しており、ぐりぐり動かせます!🚇
※アナログ・デジタル両方で既往事例がありますが、各駅の深さから擬似的に補間されたものが多く、建設図面(縦断面図)から各区間を詳細に読み取り作成しました。
OHASHI Takeshi retweeted

無申請・無許可で建てられた川越モスク。しかも開所式には駐日🇵🇰大使まで出席していたことに驚く。
しかしまぁ、この広大な敷地にミナレットまで携えた立派なモスクが易々と違法建築されてしまう日本って、一体いつからこうなってしまったんだ。
完全に舐められてるんだよ。行政は仕事しろマジで。

OHASHI Takeshi retweeted

なんでもオープンソースになっていくな...
Claude Design → Open CoDesign
CapCut →OpenCut
Notion → AFFiNE
Slack → Mattermost
Figma → OpenPencil
Screen Studio → OpenScreen
Loom → Cap
リプにGithubリンクまとめておきました👇


OHASHI Takeshi retweeted

Stripeが、自社の2500万行(現在は4200万行)規模のRubyコードベース全体に、自動フォーマッタ「rubyfmt」を一晩で適用した経緯を公開。RubyにはGoのgofmtのような「ゼロ設定・高速・強制的に統一する」タイプのフォーマッタが長年存在せず、巨大コードベースではPRレビュー時のスタイル議論やrubocop調整が大きな負担になっていたという。
rubyfmtは2018年に個人OSSとして始まり、最初はRuby製だったが、100ms以内で動かすという目標のためにRustへ移植。さらにRuby VM内部のparse treeをRust側から直接たどるという、かなり異様な実装に進化していく。Rubyのripper parserが返す内部データをJSON経由でRustに渡していたが、最終的にはRubyオブジェクト(VALUE)を直接serdeでデシリアライズするところまで到達したという話がかなり濃い。
Stripeでは以前prettier-rubyも試したが、大規模ファイルでクラッシュし、速度面も問題だった。そこでDeveloper Productivityチームがrubyfmtを本格採用。まずはファイル単位で段階的に適用し、ripper tree比較や巨大テストスイートで安全性を検証。その後、土曜日を選んで「全コードベース一括フォーマット」を実施した。
面白いのは、導入後の感想が「誰も話題にしなくなった」という点。特にGoやPythonなど他言語出身エンジニアにとって、Ruby特有の「どう書くべきか分からない問題」が消え、レビューでの細かなフォーマット指摘も激減。開発体験そのものを変えたという。
また最近は、Ruby公式の新parser「Prism」への移行も進み、Ruby VMをリンクせずにparse tree生成が可能になったことで、バイナリサイズ削減とさらなる高速化も実現したとのこと。
・巨大モノレポでは「コードを書く」より「コードの見た目を揃える」コストが無視できなくなる
・gofmt文化をRubyにも持ち込みたかった、という思想が一貫している
・Rust + Ruby VM + serde + parser internalsという、かなり変態的な実装話でもある
・「誰も話題にしないほど自然に定着した」がDeveloper Productivity系ツールの理想形かもしれない
stripe.dev/blog/formatting-a…

OHASHI Takeshi retweeted

AIによるコード生成がもたらす無謀な誘惑、という記事
infoworld.com/article/415458…
・AIがエンジニアを代替できるという幻想を信じて開発チームを削減する経営者が増えている
・エンジニアを少数の監視役に置き換える考えは先見的ではなく無謀な行為である
・AIがコードを書けるのは事実だが、熟練のエンジニアやアーキテクトが不要な支出になるという考えは現場では通用しない
・デモや初期の機能開発は成功するように見えるが、システムをスケールさせるとクラウド利用料が月額1万ドルから30万ドル以上に跳ね上がるような事態が起きる
・AIは一見正しそうなコードを出力するが、コスト効率の良いアーキテクチャや無駄な処理を避ける判断ができない
・後で最適化すればいいという主張があるが、複雑なシステムを理解していた専門家を解雇することで、AIが生成したコードを誰も修正できなくなる
・これはイノベーションではなく、産業規模の自己加害的な技術的負債を生み出していると言える
・AIが思考の速度を超えてコードを量産することで、数年分の技術的負債をわずか数ヶ月で蓄積してしまう
・AIは開発チームの作業を速める強力なアクセラレータとして機能するが、代替品ではない
・エンジニアの真の価値はタイピングの速さではなく、システム全体のトレードオフや運用上の痛み、複雑なコストモデルを理解している点にある
・AIはシステムの断片を模倣するだけで、設計上の重要な選択が将来どのような悪影響を及ぼすかまでは判断できない
・市場はコスト削減やAIによる変革という言葉を好むため、経営陣は株価を一時的に上げるインセンティブに動かされやすい
・しかし短期的な成果の裏で、企業の基盤となるエンジニアリング能力が中身のないものになっている
・AIで構築された高額で脆弱かつ不透明なシステムを再構築するには、膨大な費用と再雇用という困難が伴うようになる
・今後数年でAIの誇大広告を信じた企業が、システムを管理できなくなり大きな代償を払うケースが増えると予想される
・破滅を避けるには、エンジニアを維持しながらAIを能力向上のためのツールとして使い、経験豊富なアーキテクトにガバナンスとコスト管理を任せるべきだ
・AIを人間の判断の代わりにするのではなく、あくまで道具として扱うことが現実的な解決策となる

OHASHI Takeshi retweeted

Every programming language exists because something was broken.
Fix the problem → create a language:
• C → OS development was too slow
• C++ → C had no structure for large systems
• Java → Software couldn’t run across machines
• Python → Coding was too complex for humans
• JavaScript → Websites were static
• C# → Microsoft needed its own ecosystem
• Go → Backend systems became too messy to scale
• Rust → Memory bugs were destroying systems
• Swift → Objective-C was outdated
• Kotlin → Android dev was painful
• PHP → Web pages needed to be dynamic
• Ruby → Developers were miserable
• TypeScript → JavaScript errors were unpredictable
• SQL → Data was impossible to query cleanly
• R → Statistics needed better tools
• MATLAB → Engineers needed faster computation
• Dart → One codebase for all platforms
• Solidity → Trustless digital agreements
• Assembly → Direct control over machines
• Objective-C → Early Apple app development
Languages don’t win because they’re “cool.”
They win because they solve pain.



OHASHI Takeshi retweeted
東大が授業英語化を発表した翌週にGoogle Meet のリアルタイム自動翻訳が発表されるというのは、実に皮肉なことだな。グローバルに追いつこうとして、置いていかれてる。
OHASHI Takeshi retweeted

Pokémon GOの開発者、野村達雄の著作が無料公開されました。この本は日本の義務教育の教材になるべき本だと思ってます。結構マジで。先生読んで。
本人は周りのおかげだ、と言うだろうから代わりに僕がいいますが、Pokémon GOの最大の功労者は間違いなく野村達雄です。
(もちろん、ポケモンの関係者及び、Nianticのメンバーを軽視するわけではありません。)
@nomtats
またいつかなんかやろうねー!
tatsuo.me/pokemongo/ja?fbcli…

OHASHI Takeshi retweeted

元OpenAI社員のレオポルド・アッシェンブレナーがAGI、超知能、知能爆発、再帰的自己改善などについて解説していました。非常に刺激的な内容となっています。以下にまとめます。
---
【知能爆発】
・AIの進歩は人間レベルで止まらない
・⭐️数億体のAGIがAI研究を自動化し、10年分のアルゴリズム的進歩を1年以内に圧縮する可能性がある
・人間レベルから、あっという間にはるかに超人的なAIシステムへと移行する
・超知能の力――そして危険――は劇的なものになる
・超知能マシンは、いかに優秀な人間であっても行うあらゆる知的活動をはるかに凌駕できるマシンと定義される
・⭐️マシンを設計するという行為もその知的活動の一つである以上、その超知能マシンはより優れたマシンを設計できる
・⭐️その結果、疑いなく“知能爆発”が起こり、人間の知能ははるか後方に置き去りにされる
・⭐️最初の超知能マシンは、人類が作る必要のある最後の発明である
・⭐️私やあなたよりもはるかに賢くなる、質的にまったく違うレベルの知能になる可能性がある
【再帰的自己改善】
・⭐️AGIを獲得したら、1つのAGIだけを持つのではない
・⭐️何千万ものAGIを同時に稼働させることができる可能性がある
・おそらく1億人分に相当する人的知能をもつAGIを動かし、すぐにその10倍以上の速度で動作させることも可能かもしれない
・それらはまだオフィスを歩き回ったりコーヒーを淹れたりできないかもしれないが、コンピュータ上で機械学習の研究を行うことは十分可能
・先進的なAI研究所で働く研究者やエンジニアが数百人いるのとは桁違いで、10万倍以上もの「研究者」が昼夜を問わずアルゴリズム上の画期的発見を目指して猛スピードで取り組むことになる
・⭐️これは「再帰的自己改善(recursive self-improvement)」である
・⭐️空想科学小説のような話である必要はなく、既存のアルゴリズム的進歩(現状で年間0.5 OOMsほどと言われるトレンド)を加速すればよいだけ
・自動化されたAI研究はアルゴリズムの進歩を加速させ、1年で5オーダー(5+ OOMs)以上の有効計算量の増大をもたらす可能性がある
・そうなれば、知能爆発の終わりまでに手にするAIシステムは、人間をはるかに凌駕するものになる
・⭐️自動化されたAI研究は、人間10年分のアルゴリズム的進歩を1年以内に圧縮できるかもしれない
・そしてそれは控えめな推測にも思える
・⭐️そうしたAIが数十億もの規模で“ひとつの小さな文明”のように存在する状態になるかもしれない
・⭐️超知能を他の研究開発領域に応用すれば、爆発的進歩は機械学習(ML)の研究にとどまらず広範囲に及ぶ
・⭐️ロボティクスをあっという間に解決し、他の科学技術分野もわずか数年で劇的に飛躍させ、産業的な爆発も起こる
・⭐️超知能は決定的な軍事的優位をもたらし、破壊力においても計り知れないものを解き放つはず
・⭐️人類史上でも最も激しく不安定な瞬間に直面することになる
【AI研究の自動化】
・⭐️すべてを自動化する必要はない。必要なのはAI研究の自動化だけ
・AGIの変革的インパクトを疑う際のよくある反論は「AIは何でもこなすのは難しい」というもの
・たとえばロボティクスでは、博士号レベルの認知力があっても現実世界での作業は厄介だという指摘がある
・バイオの研究開発(R&D)の自動化でも、物理的なラボ作業や人体実験などが多く必要になる場合がある
・⭐️しかしAI研究を自動化するためにはロボティクスは必要なく、ほかに多くの要素も必須ではない
・リーディングラボのAI研究者やエンジニアの業務は完全に仮想空間だけで行うことが可能で、現実世界の制約にそれほど左右されない
・研究者の仕事は、ML論文を読み、新しい疑問やアイデアを出し、そのアイデアを検証するための実験を実装し、結果を解釈して次へ進むという一連の流れに集約される
・この流れは、現在のAI能力の延長で2027年頃までには人間のトップレベルの研究者を追い越せる可能性が十分にある
・過去10年で起きた大きな機械学習のブレークスルーは、振り返れば非常に単純かつ泥臭い発想によるものが少なくない
・⭐️AI研究は自動化できるし、AI研究さえ自動化すれば、驚異的なフィードバックループを起動させるにはそれで十分
・⭐️自動化されたAI研究者を数百万単位で(しかも近い将来には人間の10倍や100倍の速度で)稼働させられるようになる可能性がある
・⭐️2027年までには数千万台規模のGPUを用いた運用が可能になると想定される
・トレーニング専用のクラスタだけでも3オーダー程度の拡大が見込まれ、すでに1,000万台を超えるA100相当のGPUが使われる計算になる
・推論専用のフリートはさらに大きくなるはず
・⭐️そうなれば、AI研究者を自動化して生み出された「研究者」を何百万も――場合によっては1億人分相当――昼夜を問わず稼働させられる
・重要なのは、自動化されたAI研究者がまっ先に取り組むアルゴリズム的イノベーションが「10倍や100倍の速度向上」をもたらすこと
・たとえばGemini 1.5 Flashは、当初リリースされたGPT-4と比較してわずか1年で推論が約10倍速くなっていて、しかも初期版GPT-4と同程度の推論能力を保持している
・この程度のアルゴリズム的高速化ですら、数百人の人間研究者が1年かけて達成したもの
・自動化されたAI研究者集団なら、こうしたブレークスルーを極めて短期間で何度も手にすることができる
・⭐️つまり、AI研究を自動化できるようになってからそう遠くないうちに、「1億体のAI研究者それぞれが人間の100倍の速度で動く」という事態が起こり得る
【進歩の圧縮】
・⭐️このような状況になれば、すでに存在しているアルゴリズム的進歩のトレンドを大幅に加速させ、10年分の進歩を1年に圧縮することも不思議ではない
・自動化された「AI研究者」は本当に優秀な存在になる
・⭐️ML分野で書かれたすべての論文を読み込み、ラボでこれまで行われてきたあらゆる実験を深く検討し、コピー同士で学習を共有しながらあっという間に数千年分の経験値を蓄積できる
・人間の誰よりもはるかに深いMLの直感を身につける可能性がある
・⭐️膨大な行数の複雑なコードを書き、その全コードベースを常に頭(=コンテクスト)に入れつつ、何十年分にも相当するチェック作業を行いバグや最適化ポイントを洗い出すことも容易
・仕事のあらゆる工程で完璧に近い能力を発揮できる
・⭐️1体の自動化されたAI研究者を「訓練」して「オンボーディング」すれば、それをコピーするだけで済む。100万人、1億人の新規雇用を人間で賄うような手間は不要(政治的な駆け引きや企業文化への順応も不要)
・彼らは常に最大限の集中力とエネルギーで昼夜働き続けられる
・⭐️膨大な数の自動化されたAI研究者同士がコンテクストを共有し合える(場合によってはお互いの潜在表現に直接アクセスし合えるかもしれない)ため、人間研究者同士よりもはるかに効率的かつ緊密なコラボレーションと連携が可能
・⭐️最初の自動化されたAI研究者がどれほど優秀でも、すぐにさらなるオーダーの飛躍によってより優秀な新モデルを作り出し、それをAI研究に投入できる
・⭐️たとえば「アレック・ラドフォード(元OpenAIの天才研究者)の自動化版」を想像してみる――しかも、それが1億体
・OpenAIの研究者ならほぼ全員が「もし“アレック・ラドフォード”が10人いれば、いや100人や1,000人、100万体が人間の10倍や100倍の速度で働いてくれれば、大抵の問題はあっという間に解決できる」と同意する
・⭐️10年分のアルゴリズム的進歩を1年で成し遂げるのは十分にあり得る(数百万倍の研究リソース増加による10倍の加速、という程度ならむしろ控えめなくらい)
・⭐️こうしたシナリオを考えると、AGIから超知能に至るまでがあっという間――1年もかからない可能性すらある――というのは非常に説得力のある話に思える
【量と質】
・⭐️量的に「超人的」で、10年の終わり頃には数億台のGPUが稼働していると想定すれば、数十億体ものAIを動かすことができ、彼らは人間より何桁も速く「思考」できる
・どんな領域でもあっという間に習熟し、1兆行ものコードを書き、ありとあらゆる分野の論文を読み込んで(しかも完全に学際的な理解を身につけ)、普通の人間がアブストラクトを読み終わる前に新しい論文をどんどん量産してしまう
・互いのコピーから平行して学び、新しい発明を導入してからわずか数週間で数十億年分の人間労働に相当する経験を積むこともできる
・24時間休むことなく集中力を最大化したまま働き続け、足を引っぱるチームメイトなど存在しない――そういった姿は容易に想定できる
・⭐️しかしもっとイメージしづらいのは、そうしたAIが質的にも「超人的」になるということ
・⭐️狭い例としては、大規模な強化学習によって、人間にはまったく理解できない独自の戦略や動きを獲得したAlphaGoの「イ・セドル戦における37手目(神の一手)」のようなクリエイティブなアイデアがすでに生まれている
・超知能では、こうした現象があらゆる領域で起こる
・人間にはまったく見抜けないような形で、人間社会やシステムの“抜け道”を巧妙に突くかもしれない
・モデルが数十年かけて解説しようとしても人間には理解不能なほど複雑なコードを生み出すかもしれない
・人間が何十年も行き詰まるような難題が、彼らにとってはあまりにも簡単であっという間に解き明かしてしまう可能性がある
・⭐️私たちは高校生がニュートン力学で四苦八苦しているうちに、彼らは量子力学の先のさらに先を探究するような状態かもしれない
【ロボティクス】
・⭐️知能爆発においては、まず自動化されたAI研究という狭い領域で爆発的な進歩が起こる
・⭐️しかし、超知能を手にし、それを数十億体(しかもすでに超知能化した)エージェントとして多方面の研究開発(R&D)に応用しはじめれば、爆発的な進歩は一気に広範囲へと拡大する
・最初のAGIには他の領域(AI研究以外)を完全自動化するには不十分な制限が残っているかもしれない
・しかし、自動化されたAI研究によって、そうした制限を素早く解消するアルゴリズム上のブレークスルーが起こり、あらゆる認知労働の自動化を可能にする
・ロボット工学をしっかり機能させる上で最大のカギとなるのは、ハードウェア面よりもML(機械学習)のアルゴリズム面
・⭐️自動化されたAI研究者たちが、ロボット工学の問題を解決することになるはず
・⭐️工場は、人間の管理や肉体労働に頼る体制から、ロボット群だけで完全に運営される体制へと移行していく
・⭐️こうした10億体の超知能は、人類の研究者が今後1世紀をかけて成し遂げるはずの研究開発の労力を、わずか数年に圧縮しかねない
【経済成長】
・⭐️極端に加速された技術進歩と、あらゆる人間の労働を自動化できる能力が組み合わされれば、経済成長は飛躍的に高まる
・⭐️成長率が年2%から2.5%に上がる程度ではなく、産業革命のように根本的な成長モードの変化が起こりうる
・⭐️年30%を超える成長率や、年に複数回のGDP倍増すら考えられる
【軍事】
・⭐️初期段階の「認知面での超知能」だけでも、軍事において十分大きなアドバンテージとなる
・⭐️超人的なハッキング手法によって、相手国の軍事システムを無力化する可能性がある
・ドローンの大群やロボット軍がまず注目されるが、それは始まりに過ぎない
・新種の大量破壊兵器や無敵のレーザー式ミサイル防衛システム、人間の想像を超えた何かが次々と登場する
・21世紀の軍隊が、19世紀の騎馬や銃剣を装備した部隊と戦うようなものになる
・米国政府を転覆できるほどの力をもつ超知能を操る存在が、プリ・超知能(超知能以前)の権力層から統治権を奪い取る可能性がある
・無防備な軍事システムや選挙システム、テレビ放送などをハッキングすることが可能
・将軍や有権者を巧みに説得できるかもしれない
・国家を経済的に凌駕するビジネスを展開することもできる
・新たな合成生物兵器を設計し、ビットコインで雇った人間にその合成を依頼するなど、あらゆる手段が考えられる
【人類史上でも最も不安定で危険かつ異常な時期】
・2030年代にこうした変化がどのように進展するかは予測が困難
・⭐️少なくとも、人類がこれまで経験したことのない極限状態へ、極めて短期間のうちに突入するのは確実
・人間レベルのAI(AGI)が登場するだけでも極めて大きなインパクトがある
・⭐️しかし、AGI登場からわずか1年足らずで、人類全体を合わせた知能さえ上回る理解力や能力――いわば“生の力”をもつ存在に移行する可能性が大いにある
・⭐️この急激な移行期に、多くの判断や実務をAIシステムに任さざるを得なくなり、制御を失うリスクが現実味を帯びる
・あらゆる出来事がものすごい速度で進み始め、世界が“狂気”に陥るようになる
・⭐️20世紀の地政学的緊張や人為的危機が、わずか数年に圧縮して起こるような事態を想像せざるを得ない
・⭐️知能爆発と、その直後の超知能期は、人類史上でも最も不安定で危険かつ異常な時期になる
・⭐️今の10年が終わる頃には、私たちはおそらくその真っただ中にいる
【超知能と原子爆弾】
・⭐️「超知能」出現の可能性――知能爆発の可能性――は、核連鎖反応と原子爆弾の可能性を初期に議論した状況を想起させる
・H.G.ウェルズは1914年の小説で原子爆弾を予言
・1933年にレオ・シラードが連鎖反応のアイデアを思いついたが、当初は信用されず理論上の話と思われていた
・1938年に核分裂が実験的に発見されると、シラードは再び恐怖を覚え、情報統制を強く主張
・少数の人々がようやく原子爆弾の可能性を認識しはじめた
・アインシュタインは当初、連鎖反応を考えていなかったが、シラードに問い詰められるとすぐに理解し、必要な行動を取る意志を示した
・フェルミやボーアなど多くの科学者は「慎重派」で、連鎖反応の非常識な帰結を正面から受け止めず、過小評価していた
・⭐️連鎖反応の話が“荒唐無稽”に感じられたため、情報秘匿や全力投球はばかげていると思われた
・⭐️実際には、爆弾が現実化するまでわずか5年ほどしかなかった
・私たちは今、再び「連鎖反応」という可能性に直面している
・⭐️これが投機的に聞こえるなら、AIラボのシニア研究者の多くが「急激な知能爆発のシナリオは十分にありうる」と考えていることを思い出すべき
・⭐️彼らにはその未来が見えており、超知能は実現可能だ