
SEO, search marketing, web analytics, social media, optimisation de la conversion... https://xitter.cf/t.co/qIQxNRQk3r
Paris
Joined October 2009
- Tweets6.2K
- Following1.9K
- Followers3.7K
- Likes3.8K



Seg retweeted

How Gemini searches and chooses its citations (based on analyzing 222,753 Google searches across 76,450 public conversations)
*Gemini assigns categories to your question
*Gemini expands your question before searching
*Wikipedia and news sites lead the citations, YouTube is read but rarely cited
*Gemini can search without displaying sources
think.resoneo.com/gemini-con… via @5eg


Seg retweeted

On parle beaucoup de GEO. Mais là, on commence vraiment à voir comment Gemini choisit ses sources.
RESONEO a analysé 76 450 conversations Gemini publiques et 222 753 recherches Google.
Et certains résultats sont assez dingues.
🔎 Gemini ne cherche pas simplement votre question dans Google.
Il la transforme.
Quand la question n’est pas en anglais, 55 % des échanges avec recherche comportent au moins une requête en anglais.
37 % des requêtes ajoutent même une année que l’utilisateur n’avait jamais indiquée.
Et environ 1 requête sur 4 peut faire apparaître une marque, une personne, un produit ou une organisation absente de la question initiale.
C’est exactement le principe du Query Fan-Out : votre mot-clé n’est plus vraiment votre mot-clé.
Mais le plus intéressant concerne les citations.
👉 33 % des passages cités commencent dans les premiers 10 % du contenu.
👉 80 % se trouvent dans la première moitié.
Donc les introductions interminables avant de répondre au sujet deviennent encore moins intéressantes.
Autre donnée importante :
Gemini consulte beaucoup plus de pages qu’il n’en cite.
En moyenne, seulement environ 3 pages consultées sur 10 finissent citées.
YouTube est par exemple consulté dans 18 % des réponses étudiées… mais cité dans seulement 5 %.
Être crawlable ou “lu par l’IA” n’est donc clairement pas suffisant.
Et bonne nouvelle pour les petits sites :
51 % des réponses sourcées comportent au moins un domaine situé au-delà du millionième rang mondial ou absent du classement utilisé dans l’étude.
➡️ Il n’est donc pas obligatoire d’être Wikipédia, Forbes ou Le Monde pour entrer dans une réponse IA.
Le signal que je trouve peut-être le plus intéressant :
Dans 54 % des cas, le passage retenu est celui qui ressemble le plus à la phrase écrite par Gemini.
Seulement 10 % correspondent davantage à la requête Google lancée en amont.
Cela suggère un fonctionnement très intéressant : Gemini construit son affirmation, puis cherche dans la page le passage capable de l’étayer.
Pour le GEO, la conséquence est assez claire.
Il faut arrêter de penser uniquement “mot-clé”.
Il faut produire des blocs d’information facilement réutilisables :
→ réponse immédiatement identifiable
→ phrases compréhensibles hors contexte
→ faits précis
→ passages courts et autonomes
→ informations importantes placées tôt dans la page
→ couverture des différentes reformulations possibles d’une question
Le SEO cherchait surtout à gagner une position.
Le GEO ajoute une nouvelle bataille :
devenir le meilleur passage qu’une IA puisse rattacher à ce qu’elle veut dire.
Et ce n’est pas exactement le même jeu.


Seg retweeted

Posez la même question à une IA deux jours de suite : à peine 4 sources sur 10 seront les mêmes 🎲
C'est l'un des 17 sujets GEO de 2026 passés au crible dans notre Livre Blanc Exclusif : 47 études et 26 prises de parole d'experts FR & internationaux dont @5eg @davidgroult ou encore @rochdaniel
Article 👉 abondance.com/20261015-30068…
Livre blanc 👉 abondance.com/guides/livre-b…
Merci notamment à @resoneo dont les tests nourrissent plusieurs chapitres 🫰

Seg retweeted

I tested Google's new decision model for the browser, MediaPipe Decision Maker (Chrome's own Decisions API has no engine yet). On its own it gets 75%: below Gemini Nano (88%), OpenAI's Decisions API (83%) and Jev (92%).
Psss... it sends usage data back to Google 👀


Seg retweeted

Y'SERP, nouvelle extension SEO #homemade : paramètres d'URL Google, lecture de la SERP et de l'AI Overview, journal de vos positions, résultats et sources copiés en un clic, capture de la page entière, analyse SEA, etc. --> chromewebstore.google.com/de…


Seg retweeted

My GEO & LLM experiment escaped the sandbox.
Literally.
Every experiment needs walls.
Mine were simple. One brand-new domain. 50,000 statistics, generated in a single day. Every number fake, on purpose. The plan was to watch from the outside: which bots show up, what they fetch, whether AI search picks any of it up. Write it up. Move on.
A controlled GEO experiment. A sandbox.
It didn’t stay in the sandbox.
Seven months later, I checked on it ++

Seg retweeted

Google ne cache pas ses mécaniques. Il les expose depuis des années : dans Discover, dans le Knowledge Graph, dans le code de Chrome, dans les brevets et les fuites... Ce sont les mêmes briques partout : entités, embeddings, modèles à deux tours qui apparient un utilisateur et un contenu. Elles font tourner Discover, YouTube, Insta et TikTok, et elles dessinent depuis longtemps le Google d'après, celui de la sélection, de la citation et du paiement au fait cité.
Le 15 Octobre à Disneyland Paris, à l'occasion du @seosummitevent , @SylvainDeaure vous raconte tout ça :
À partir de deux ans de captures réelles et de nos études publiées (scores de prédiction, entités auteurs, profils de recherche), on montre ce que la tour visible, l'index et sa police, doit à la tour cachée, les modèles. Et ce qu'un grand compte doit changer dans ses métriques et sa gouvernance quand le classement, tout comme comme le contenu, ne coûtent plus rien.
Ce avec quoi vous repartirez :
- une lecture des deux tours de Google et des briques communes à Discover, YouTube et aux réponses IA ;
- des preuves mesurées, pas des estimations : scores de prédiction, affinité lecteur-source, entités auteurs, profils de recherche ;
- une grille de mesure de la visibilité IA en cinq niveaux, avec ce qui se mesure déjà, ce qui s'estime, et ce qu'on a encore du mal à mesurer.
Vous y serez ?

Seg retweeted
🚨 RESONEO vient de disséquer Google Ads… et la découverte est assez dingue.
On pensait encore Google Ads comme :
Mot-clé → annonce → landing page → enchère
En réalité, la mécanique ressemble désormais beaucoup plus à un RAG publicitaire alimenté par votre site. 🤯
Google Ads :
→ crawle vos pages
→ découpe titres, sections, snippets, images et données structurées
→ extrait les passages importants
→ génère plusieurs représentations de la page
→ produit des résumés
→ transforme même les pages en Markdown pour les LLM
→ rapproche ces contenus des requêtes
→ génère les annonces
→ vérifie que les promesses sont réellement présentes sur le site
Et ce n’est pas tout.
Resoneo a trouvé 88 types de scores servant à évaluer les créations : pertinence, pCTR, fidélité à la landing page, grounding, qualité, contradiction, diversité…
Encore plus intéressant pour les SEO 👀
Des briques comme NavBoost et QBST apparaissent également dans cette mécanique côté Ads pour relier requêtes, documents et comportements.
⚠️ Ça ne veut PAS dire qu’un « score SEO » est injecté dans l’Ad Rank.
Mais cela montre à quel point Google construit désormais ses systèmes autour d’une même logique :
comprendre l’entreprise + comprendre ses pages + comprendre l’intention + générer la meilleure réponse/annonce possible.
Et avec AI Max, ça devient encore plus évident :
requête → intention → contenu du site → génération → évaluation → sélection → landing page
Même les AI Overviews entrent dans l’équation : une annonce peut devoir être pertinente non seulement pour la requête… mais également pour la réponse générée par l’IA de Google.
👉 La frontière SEO / SEA / GEO devient de plus en plus fine.
La conséquence est assez simple :
Votre site n’est plus seulement la destination de vos campagnes Google Ads.
Il devient la base de connaissances utilisée par Google pour comprendre votre business et fabriquer vos publicités.
À lire : think.resoneo.com/google-ads…


Seg retweeted

Profound says its Index is powered by 1.9 billion real user conversations. But what does that actually mean?
Back on July 28 I publicly asked 31 methodology questions of the major prompt-tracking platforms.
They covered what AI visibility actually measures, prompt representativeness and weighting, effective sample size, statistical uncertainty, personalization and conversation context, external validation, business outcomes, and what evidence would falsify the methodology.
They were not rhetorical questions.
Several platforms responded, and substantive responses were added to the original article. None of the major named platforms responded. They have also now had plenty of time to publish additional methodology or clarification.
So I've started doing the next part myself: documenting what can be established from each platform's own public disclosures.
Published today is the first piece of that work:
Research into Profound's conversation dataset, Prompt Volumes and Index methodology.
The research uses first-party material only. Profound's own product pages, Help Center, engineering posts, research, press releases and public statements.
The aim here is not to prove Profound wrong, it's to establish as carefully as possible:
- what is directly observed
- what is modelled or extrapolated
- what the headline dataset numbers actually refer to
- how the Profound Index is constructed
- what its rankings actually measure
- and which methodological questions remain unresolved in the public record.
I’ve deliberately kept the research itself dry (a page turner it is not). Where Profound's methodology is defensible, I say so. Where something can't be established from the available material, the answer is generally "we don't know."
The research also went through two explicit falsification passes, where I searched for first-party evidence that would contradict, weaken or materially change the findings rather than looking for more evidence to support them.
It's still possible of course that I've missed a public disclosure somewhere. If Profound provides evidence that materially changes any part of the record, I'll update it.
Read the research here: queryburst.com/research/prof…

Seg retweeted

ChatGPT’s retrieval system consists of 70% search engines tagged as internal 💥
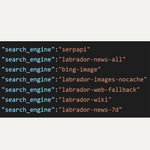
Following our analysis of the leaked ChatGPT retrieval system, we identified 69 search engines that can be used across its search and retrieval infrastructure 👉 48 of them are tagged as internal.
And that doesn’t even include ChatGPT’s Shopping system, which runs on a separate set of engines.
I pulled the full engine registry behind ChatGPT's retrieval layer and mapped every engine to the source it routes through.
The breakdown by source:
🔵 labrador: 42 engines, internal
The in-house index, and by far the deepest. It carries dedicated engines for news windows (1 day, 7 days, all time), wiki, arxiv, aixiv, STEM, legal, finance, four separate medical and legal knowledge engines, Reddit, YouTube, PDFs, images, places, and even synthetic content.
🔵 labrador-web: 6 engines, internal
General web retrieval, including the Google redirect fallbacks.
🟠 serpapi: 9 engines, external
Split across three sources: serpapi_auto_news (5), serpapi_auto_web (2), and serpapi_auto_image (2).
🟠 mai_grounding: 5 engines, external
Two on mai_grounding for webpages, three on mai_grounding_news, all flagged mai-news-beta.
🟠 The rest: 7 engines, external
Bing (2), Fortis (1), Fortis Barebone (1), Getty (1), Yelp (1), Foursquare (1).
👉 The external sources cover almost nothing but web, news, and images. Every specialist vertical — arxiv, medical knowledge, legal documents, Reddit, PDFs, places — exists only internally.
👉 There is also a visible tiering: the same engine often exists three times — once as default, once prefixed system1, once system2. Different routing paths, same underlying source.

Seg retweeted

🆕On a publié un article sur @abondance_com : l'app Google Dreambeans avec @5eg
On a regardé comme cela fonctionnait et on était pas au bout de nos surprises quand :
Derrière nos stories. Google n’écrit pas "tu aimes le sport". Il écrit ça :
Google Calendar records confirm recurring 'Fitness' … via Google Meet, avec l’invité nommé.
Billing logs show strict vegan… + la facture Mon Epicerie du 11 août (5kg de soja).
User resides in "la ville" — le jour même de la Fête de la Diane.
TGV Aix → Paris, resto déjà vérifiés avant le voyage.
Mails Gemini du 22 mars encore là en septembre.
La personnalisation : les mails, l'agenda Google, les factures, le lieu, recollés en phrases pour décider ce qu'il affiche aujourd’hui comme stories.

Google ouvre Dreambeans à tous les comptes US (18+, iOS/Android).
@AndellDam et @5eg ont plongé dans les profondeurs de l'appli : recherches, emails, Photos, Gemini... tout est croisé pour deviner "ce qui mérite votre attention maintenant".
Le détail ici 👉 abondance.com/20260911-29070…

Seg retweeted

Grosse annonce venez!
xitter.cf/i/broadcasts/1AxRnZXqO…

Seg retweeted
ChatGPT retrieval system LEAK alert 💥
I found "something huge" in ChatGPT's server-sent events over the weekend.
Inside the stream is a detailed debug view of ChatGPT's web retrieval system. Which queries it wrote, which engines it called, what came back, scoring objects,what it fetched, how it split each page, and what finally made it into the answer.
I have been pulling this data for a few days. On Saturday I started getting rate limits, so I was probably the most active user of that stream this weekend :)
A few things I can share today:
One question is never one search. Yes, we know there are fanouts. But actually more fanouts behind the scenes!
For a single "best AI visibility tools" prompt, ChatGPT ran 5 search rounds, wrote 18 different queries(hidden queries), made 50 engine calls, pulled 228 results, fetched 223 URLs with selected chunks, and cited 16. You see 16 links.
✍ Let's start today with renderer. How actually ChatGPT uses your page for retrieval.
Your meta tags travel with every result.
There is a separate og_data object in the payload and it is empty on every single result. The raw meta_tags list is what is actually kept.
The page body is not HTML. It is a markdown-like text render. I compared its fingerprints against the common HTML to text parsers. Two-space "* bullet", "* * " for horizontal rules, "# heading" and "--- | ---" table separators with no outer pipes all match the Python html2text library. Turndown, markdownify and Trafilatura each match only one or two of those. So html2text is the strongest candidate, but it is not a stock build.
That render is what gets cut into blocks of roughly 170 words and scored. The model does not see your full page. It sees one to three of those blocks per source.
The images below is not a mockup. Every code block is copied from the stream as is, including our own Peec AI product page.
What I showed above is a small slice. One prompt produces a 150,000-line JSON dump, and the two fields in the image are maybe 2 percent of it.
The same stream also carries:
Every rewritten query, and which of roughly ten internal engines each one was sent to (web, news, Wikipedia, Reddit, arXiv, YouTube, PDF and more)
📍 A per-result score, plus a score object that breaks that score into its components
📍 A per-chunk score for every block of every fetched page, and which blocks were kept for the prompt
📍 A should_fetch decision on each result, with crawl date and publication date
📍 A second ranking pass done in the model's reasoning, where domains are re-ordered before the answer is written
📍 The exact prompt the model receives, with the word budget it is given per source
📍Separate result types for shopping and local queries, with their own fields
If you work on GEO or AI visibility, this is the closest look at ChatGPT's retrieval pipeline I have seen. MORE TO COME.
Follow @DavidKonitzny, @TomekRudzki, @MalteLandwehr, there is a lot more coming THIS WEEK.


Seg retweeted
L'auteur n'est pas une simple case à cocher. C'est une entité du Knowledge Graph avec un identifiant, des relations, un historique 📜
1492vision.substack.com/p/la…
Depuis quelques semaines, tout le monde parle des auteurs en SEO. Byline, page auteur, un peu de schema, et hop, de l'E-E-A-T.
Sauf que ça décrit ce que vous déclarez. Google, lui, construit un profil d'entité que vous l'aidiez ou non.
On le montre data à l'appui depuis mars 2025, quand on a trouvé sur Discover l'entité d'une autrice que l'API Knowledge Graph de Google refuse de donner. Avec ses profils sociaux persos, pas ceux du média qui l'emploie.
Dans l'article : un brevet de 2005 qui décrivait déjà tout, une citation de 2013 qui décrit les Search profiles douze ans avant leur lancement, un flag nommé dans les protos de Google, et ce qui se passe quand un créateur revendique son profil.
Plus la nuance qui manque partout ailleurs : non, pas d'auteur ne veut pas dire pas de visibilité. Nos données sont formelles.
Le substack 1492 vision est gratuit, on y publie ce genre de dossier avant tout le monde. Abonnez-vous.
Seg retweeted
Well, I checked. 😅
I found google.com/goto URLs among retrieved sources in ChatGPT, Claude, Perplexity, and Microsoft Copilot.
So yes, /goto is making its way into AI search retrieval too.
For Claude, the earliest findings I’ve seen point back to July ☠️
🤷♂️


Seg retweeted

L'équipe @resoneo a disséqué Google Maps : 1 623 schémas internes analysés, les 72 signaux du ranking local mis à nu. Probablement L'étude SEO local de l'année.
Le génie, c'est eux. J'ai juste compressé leurs 35 chapitres en 4 checklists grâce à mon stagiaire IA : Top 40 actions pour votre fiche Google. 👇


Google Maps Leak :
We’ve just released the full Geostore archive: 10,936 declarations from Google’s 2026 binary we found, matched against the LEAK 2024 documentation
think.resoneo.com/google-map…
Full archive available
