

phd stu @PKU1898 , research focused on rl, data synthesis/research and reliable eval. prev intern @Ali_TongyiLab, @PixVerse. now intern @TencentGlobal
Haidian, Beijing
Joined December 2023
- Tweets191
- Following388
- Followers34
- Likes117


Shaohang Wei retweeted

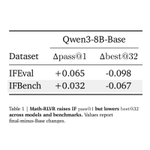
Learning that "RSI" benchmarks are just MLE/post-train style tasks repackaged with a new label was disappointing.
We could just take the ~20 ML-adjacent tasks from TB 4 and re-release them as RSI-bench and everyone would clap.
Shaohang Wei retweeted

Priming Base Models for Agentic Post-Training: An Open Midtraining Recipe
An open midtraining recipe using natural code data and agent traces at 256K context improves base models' downstream SWE-bench post-training results and agent harness robustness.
arxivb.org/abs/2610.22019


观《慢科研倡议》有感:作为学生,从长远价值角度来说,应保持清醒,要知道做科研、实习、做项目都需要以真正建立起独立发现问题、分析问题和解决问题的能力为基本追求,认同“保持耐心”。
关于agent如何放大科研能力培养,应强调个人提出假设与观点,独立设计实验,用agent来反面质疑、寻找逻辑漏洞。
Shaohang Wei retweeted

就本质而言,我并不追求快乐。我的生活,是一场严肃且认真的研究过程。
我经常会诘问自己,如果一个人具备越来越强的分析能力、竞争能力和理解世界的能力之后,他究竟应该用什么来约束自己。每一次,我的回答都是德性先于能力,责任先于欲望,真实先于情绪,人的完整性先于某一个领域内的成功。
举一个例子。量化与投资,都是在不确定性中识别规律、构建模型、作出判断的工具。我会很有倾向性的观察量化与投资的模式,但我不会完全复制它的思维方式以让它来统摄我生活的面面观。
因为一个人善于识别规律,但他并不必然尊重规律;善于理解人性,无法意味着他必然善待他人;善于最大化收益,也不等于他知道什么东西不应当被拿来交换。
这是工具理性与价值理性的根本区别。
我认为,就物质的究极而言,量化和投资都是术的层面,而厚德载物,永远是做人的第一性原理。而它往往意味着艰深的责任感,道德感与严谨精神。
德性应当是人在使用能力之前,就已经确立的约束条件。一个人的能力越强,其价值观中微小的偏差,就越可能被放大。
所以,值得警惕的是他逐渐习惯于用收益、效率、竞争和可计算性去解释一切,最终丧失对不可量化之物的敬畏。
第二,我想谈谈慢的哲学。
当今互联网与人工智能所制造的竞争,很大一部分不光是知识的竞争,还有注意力的竞争。它鼓励人们不断作出判断,却不鼓励人们长期检验判断;鼓励人们迅速表达立场,却不要求他们承担立场的后果。
在这种环境下,一个人愿意为某些问题花费多年时间,愿意承认自己不知道,愿意在没有掌声、没有物质奖励的时候继续工作,本身就是一种重要的精神能力。
就比如我现在做的事情。从写下推特的第一个帖文开始,我就没有想要开启创作者收益的任何想法与计划。我写下文字,只是信息输出,如果有人能在精神层面实现共振,那就是对双方最好的收益。
慢的哲学,就是专注的哲学。它让我更加坚定于生活中某些稳定的变量,站在更清晰的立场,看待动态的关系。
生活即研究,很多人可能不理解我的感受。
从观察视角,我是一个比较无趣的人。因为我的存在方式只有阅读与输出,而并不以快乐与爽感为驱动,因为每当高山仰止,景行行止,人总会有痛苦。我也会有。
求真是一项严肃的责任,它不以人的意志为转移。如果要讲的具体些,那或许是冷冽的孤独之下求真求实的确切。这已经是我走过二十多年时光里,唯一的珍视之物。
当生活是是一场研究,那么研究者就必须接受一个极其严格的前提:研究者本人,也必须成为被研究的对象。
我们对世界的观察会受到样本、经历、情绪、立场以及价值偏好的影响。
这意味着,一个严谨的人,不仅要能识别他人论证中的漏洞,还必须愿意识别自己最珍视的信念中可能存在的漏洞。
而发掘自己的漏洞,理性中的破败,痛苦中的耗散,承认与揭开自己,往往并不欢愉。对此,我做了无数次,在无言的深夜。
我经常会习惯把成熟的精神严谨性理解为三个层次:
第一,不轻易被外界改变。 不被流行观点、社会评价与即时利益随意牵引。
第二,能够主动修正自己。 当新的证据出现时,不把承认错误视为人格上的失败。
第三,即使坚信自己的道路,也不需要通过否定其他人的道路来证明其正当性。
这就是我对于自身的最大期望,做一个有能力认识世界的人,同时更要做一个有德性与世界相处的人。求真让我接近事实,求善让我懂得行动,求美则提醒我,世界并不只是等待被分析、利用和征服的对象。
如果厚德载物是第一性原理,那么德性的最高表现,是在看清世界的复杂、不完美与局限之后,依然能够保持真诚、宽厚与责任。
神经是具有可塑性的,会记住你的每一个行为。延迟满足,本质上是去建立完成长期更有收益行为后的即时反馈。
人在低谷的时候,最安全的方式当然是保护自己不受创伤。但是不能总是沉溺于此,因为保护自己的行为往往建立了短期的正反馈机制,要尝试打破这种反馈。。
Shaohang Wei retweeted

Announcing Exploration-Distillation, a RL framework that unlocks aggressive exploration and large performance boosts over standard algorithms like DAPO. In principle, an LLM can discover new things during RL, but existing algorithms struggle. Here’s how we do it. 🧵1/n
Shaohang Wei retweeted

现在顶尖大学里教 Agent,已经开始一路教到 GPU 了。
非常推荐 Harvard 的 CS2680 Modern AI Systems 。课程从 Claude Code、Agent Loop、Eval 和 Token 成本开始,一路往下做到模型部署、Routing、KV Cache、量化和 speculative decoding。
作业设计也很有巧思,5 个作业都围着同一个 Agent 系统往下拆,先看它怎么工作,再自己搭 Harness,最后一路优化到推理层。
感觉它更像是在回答一个问题:
一个现代 AI Agent,到底是怎么从应用层一路跑到底层系统的?
做 Agent、Harness、AI Infra 的可以收藏。
cs2680.seas.harvard.edu/
Shaohang Wei retweeted

OPSFT: Transferring On-Policy Generalization to SFT
On-policy training generalizes better than SFT. The key lies in the parameter update direction. OPSFT extracts this direction from a few on-policy steps and constrains SFT updates to it, bringing on-policy generalization to SFT.

Shaohang Wei retweeted

🚨斯坦福 CS146S 刚刚放出了一个 45 分钟的硬核讲座实录
毫无保留地教你如何真正搭出一台 7×24 小时完全自动化运行的 Agent:
从底层的无状态休眠与事件唤醒机制、到主从多 Agent 任务解耦、上下文指针化压缩,以及那些没人告诉你的工业级 Harness 调度逻辑。
市面上那些动辄几千刀的 Agent 架构课,
干货密度可能连他头 10 分钟的一半都达不到。
而且最爽的是:完全开源免费。
不管你是刚接触自主Agent ,还是像我一样天天在终端和容器里死磕系统调度…
看完这个,你会用一种全新的架构师视角去重塑你的 AI 系统。
强烈建议码住。
以后你每次设计自动化 Agent 架构的时候,都会回来翻看无数遍。
Shaohang Wei retweeted

如果你想做AI相关的工作,不妨考虑一下Agent Infra这个新兴领域。我最近也在入门这个领域,做了一些调研,记录了这个领域需要的技能清单,欢迎收藏,保存,我也会继续分享在这个领域的学习心得。
完整 List:
1.Agent Runtime:理解 Agent Loop、Tool Calling、Streaming、Session,理解并实现一个最小可用Agent,而不是只调用一次模型 API。
2.上下文与状态管理:喂给大模型的上下文决定了这一轮模型能看到什么,也很大程度上决定模型做的决策质量;State 会保存任务当前执行到了哪里。需要处理上下文裁剪、压缩、Checkpoint、任务状态,长期记忆与短期上下文。
3.任务队列与 Worker:把任务通过 Queue 分发给 Worker 执行,并控制并发、优先级、Backpressure 和 Worker Pool。
4.调度与多 Agent 编排:把复杂任务拆成多个子任务,支持DAG、Reviewer、Handoff 和 Human-in-the-loop。
5.Durable Execution:Agent 即使运行几十分钟甚至几个小时后,也不会因为进程重启而导致任务的丢失,需要持久化执行状态、Checkpoint、Replay、Resume 和 Recovery。
6.Retry、Timeout 与幂等:模型、工具、网络和 Worker 等各方面都会遇到问题;系统要能判断什么时候重试、什么时候超时,以及避免 git push、发邮件、创建资源等操作被重复执行。
7.分布式状态与一致性:多个 Orchestrator、Worker 和数据库共同维护 Task State,需要理解 Transaction、WAL、Lease、Heartbeat、Replication、Consistency 以及故障恢复。
8.Sandbox 与执行环境:Coding Agent 会执行 Shell、Git、Python、构建和测试,需要为每个 Agent 提供隔离的文件系统、进程、网络和资源环境,并限制 CPU、内存和执行时间。
9.工具基础设施与 MCP:Agent 不只是调用几个 Function,还需要统一管理 Shell、Filesystem、Browser、Database、API 等工具;MCP 可以作为 Agent 与外部工具、资源之间的一种标准接口。
10.权限、安全与 Secrets:控制 Agent 能访问哪些文件、调用哪些工具、连接哪些网络和读取哪些密钥,涉及 Authentication、Authorization、ACL、Secret Management 和 Audit。
11.可观测性与调试:Agent Task 的完整执行过程会通过trace记录下来,用 Metrics 看延迟、Queue、Token、成本、失败率和 Retry。
12.Evaluation 与 Replay:不只看“Agent 能不能跑”,还要判断任务是否真的完成正确,通过 Dataset、Rubric、Task Success Rate、Regression、Replay 和 LLM-as-Judge 做持续评估。
Shaohang Wei retweeted

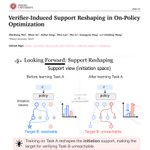
RL data task gen 101: verifiers
a few caveats and things i've noticed from poor verifier generation:
> because difficulty comes in a range of 0.2-0.6 normally for frontier labs, people overfit their tasks to hit this range. this is bad because it incentivizes tasks that have the verifiers shaped around the grade, rather than the grade shaped around good verifiers
> i think verifiers and the surrounding envs are the hardest piece to create within a task
at the highest of levels, a verifier is the way you approach verifying that a model did the task correctly. they can be:
> deterministic: unit tests, tool call checks, substring checks, actually running the code, etc
> LLMaaJ: taking unstructured text and grading it, running "taste" checks on code, correct or not, scores from a rubric, having an LLM reason over a trajectory etc
> most recently, JaaJ (Jev as a judge): using a classifier to grade answers
shapes can look completely different across different task types. rewards can be positive or negative, to determine if you're rewarding a model for doing the correct action, or penalizing it for doing the wrong action. verifiers can be gates that automatically fail a task or remove only a portion of the score. tasks in reward can be binary 1's and 0's or gradient from 0 to 1. all of these are good ways to approach task creation, depending on the task at hand.
the biggest pitfalls in verifier creation:
> incorrect verifiers: this seems obvious, but often times a verifier might seem correct to you, but can be wrong for a host of reasons. if you include web search or have an extremely large environment, maybe the model found contradictory information to what you thought was the correct answer, and is still technically correct
> lazy verifiers: you only check for a specific path, and so any path that is correct but outside of the scope of your verifiers is penalized
> missing verifiers: you're only verifying the correct actions were taken, not punishing incorrect actions too (allows a bunch of erroneous calls, for ex: if i want to email your boss for a raise, but instead it emails your boss, your customer, and your friends, but you only grade for (1), it'd be a 1.0)
what i would be focusing on as a data vendor:
(1) figuring out how to make judgments for non-verifiable domains in RL tasks: things like auto-research, physics, real-world sims, and philosophy
>>case in point models are still pretty bad at deep thinking & writing
(2) making LLMaaJ more stable
>> i think we rely too heavily on LLMaaJ assuming models are very, very smart. at high contexts / during search, etc LLMs can miss obvious stuff, so you want to confirm stability via tons of regrades and helping the model as much as possible, etc
Shaohang Wei retweeted

说起来,我从 NTU 人工智能专业辍学,在一窍不通的情况下,最后选择 all in agent infra,还挺神奇的。
当初面试了好几轮,摸爬滚打进了 NTU 最好的实验室。我以为有机会接触到大模型研究。进去之后发现,实验室里的卡根本没办法支持进行模型训练,连小模型后训练都做不了,只能做些微调项目,我就知道大模型训练的工作注定和我无缘。
于是,我开始转向agent。但做了一段时间,又发现一个问题:在 vibe coding 的催化下,agent app 的开发门槛越来越低,同质化和内卷却越来越严重。往下一层做agent harness,受模型影响又比较大。很多刚做出来的harness会随着模型升级而淘汰。
我也曾一度非常焦虑,觉得agent工程师就是个伪需求。我不看好做Harness方向,因为意识到Harness的最终形态就是极简模式,什么都不需要做,等模型慢慢变好。我也不看好app方向,感觉主要任务就是让agent做逆向工程加缝合加微创新的组合。似乎都没有什么门槛和护城河。
于是我就在思考做什么,能够不被模型能力提升的浪潮冲走。那一定是让agent跑在上面的东西啊,大伙说对不对!!!
我突然就顿悟了,模型能力越强,harness越鸡肋。
可是模型能力越强,能让agent跑的平台/环境却显得越重要‼️。
坦白说我蛮二极管的,我为什么敢all in agent infra这个赛道:
1. 因为3-5月份那会儿,我周围的人不知道这是什么,除了sandbox,从来没有听说过agent infra,agent runtime substrate这个理念。我觉得这个赛道简直就是蓝海赛道🤣。
2. 这可能是我与众不同的一个想法,那会儿沙盒大家讨论的都是如何安全、如何隔离。但我看到的是如何利用这个特性做一些在host上操作会被认为是危险的操作,然后给它改造成一个multiagent的执行环境。我对这个奇葩想法感到兴奋🥰。

Shaohang Wei retweeted
github.com/tursodatabase/age…
github.com/mem9-ai/drive9
github.com/Ephemeral-AI-Lab/…
github.com/cloudflare/comput…
可以先看这几个文件系统+沙盒的项目。
核心是fuse + db/s3 存储filesystem + sandbox

Shaohang Wei retweeted

How should models continually learn from new data?
SFT on heavily post-trained models often forgets and fails to generalize, so many works try to make the data more on-policy, e.g., on-policy self-distillation, Pedagogical RL...
If you've tried, you might find it’s tricky to balance on-policyness and data quality. What if on-policy isn't necessary? We show that off-policy training actually works well for continually learning, if done right!
🧵1/7
Shaohang Wei retweeted

arxiv.org/abs/2610.04906
Tencent is one of few companies that keep publishing papers on environment synthesis.


Shaohang Wei retweeted

最近 RL 圈两个热度很高的工作——BPO 和 Score Centering——看起来是两条完全不同的路: 一个从 PMD(策略镜像下降)+ Bellman 重构出发,推 critic-free 的轨迹目标; 一个从 off-policy drift 分解出发,解释 TIM 为什么制造漂移并把它消掉。
这篇解读把两边的公式推到底,得到一个很干净的结论:
在完整形式下,它们共享同一个 full-vocabulary token 梯度。 条件是四条:同一个 rollout policy μ、相同的 Â、精确计算 full-vocab reverse-KL / expected score、且都不加工程近似与 clipping。
而背后的核心洞见是这个分解: E_q[Rs] = E_q[R]·s̄(drift) + Cov_q(R, s)(signal)
几个值得记住的判断:
① drift 的本质是"向 sampler 蒸馏"——s̄ = ∇Σ q_v log p_v = −∇L_CE,也就是训练在把 trainer 拉向量化、陈旧的 sampler 副本,偏差被反复注入,可能形成正反馈直至奖励崩溃
② group centering 只能缩小 drift,不能消除:advantage 总和为零,但不保证每个前缀下的条件均值为零
③ Score Centering 是 bias correction,不是经典的方差缩减:减去非零的 E_q[s] 是刻意改变梯度均值,与 reward baseline 那种 control variate 不同
④ 为什么有了 IS 还需要它:精确 IS 权重方差爆炸,裁剪后又重新引入 drift;Score Centering 不依赖 importance ratio、不需要裁剪
工程上也很实用:用 stop-gradient 构造成标量 loss 就能靠自动微分得到 (s_{y_t} − s̄);完整词表太贵时用 top-k 近似,实验里 k=32/128 已接近完整版(文中有可直接用的 JAX 实现)。
一句话总结:梯度等价,但原始理论目标不同——BPO 从 PMD 最优性条件与 Bellman 出发,Score Centering 从 drift 出发。
#RL #RLVR #后训练 #LLM

Shaohang Wei retweeted

Berkeley alumni discussed how to get hired at DeepMind, Cursor, and Thinking Machines.
Not trying to romanticize frontier labs, the biggest takeaway is how these people think about taking risks and directing their career paths.
“Three UC Berkeley alumni now at Google DeepMind, Cursor, and Thinking Machines Lab share how they broke into AI, internships, interviews, startups that failed, and big tech vs startup choices.”
youtu.be/R_p2ixNlqQ0?is=t6Cq…
