

I need more tokens. I built @mopsos_ai | ex-@OceanProtocol
Paris, France
Joined August 2026
- Tweets127
- Following83
- Followers36
- Likes371




Pinned Tweet
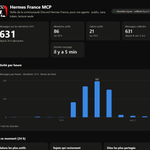
J'ai fait un petit MCP pour que vos agents puissent faire une veille de ce qui se trame sur ce discord:
vps-srv1053190.tail927db4.ts…


Ça y est, le serveur Discord Communautaire
Hermes France 🇫🇷
est ouvert.
J’avais trop envie d’avoir un endroit où on peut se retrouver entre francophones, montrer ce qu’on construit avec Hermes, poser nos questions et se filer des coups de main.
Si tu l’utilises déjà, ou que t’as envie de t’y mettre, viens. Je sens qu’on va voir passer des trucs vraiment lourds là-dedans mdrrr
Qui nous rejoint ? Je mets le lien en commentaire.
1.5 millards de valo pour Nous Research quand même

As reported in the @WSJ, we have raised a Series B to bring Hermes Agent to new frontiers (and, yes, build a mobile app)
Thank you to our investors including @nvidia @M12vc @SamsungNext @robotventures @usv @ycombinator @MenloVentures, among others
wsj.com/pro/venture-capital/…

Ça j’aime bien

One more thing: we’re halving the price of cache reads on Claude Sonnet 5.5, to $0.10 per million tokens. That makes Sonnet 5.5 around 20% cheaper to run on most long-running work.
Tokenophage retweeted

TIMON is a new Agentic Workstation who let you manage all your projects easily !
try the beta on timon-ai.com

Tokenophage retweeted

On est en train de grow la plus grosse communauté autour de l’agentique
C’est niché de fou pour le moment mais j’ai de bon espoirs que ça deviennent vraiment un truc de fou dans les mois/années à venir
Incroyable de vivre ça
500 membres en moins de 48h sur le Discord Hermes France 🇫🇷
Plus de 10 personnes qui nous rejoignent chaque heure. J’ai ouvert le serveur, j’ai posé le lien sur X et j’ai regardé le compteur monter en mode « mais attendez quoi ?? » mdrrr
Voir autant de francophones chauds pour Hermes, l’agentique et tout ce qu’on peut construire avec… putain ça me hype.
Si t’es pas encore dedans, lien en commentaire 👇
Ça intéresserait des gens que je fasse la même pour le Discord officiel d’Hermes?

J'ai fait un petit MCP pour que vos agents puissent faire une veille de ce qui se trame sur ce discord:
vps-srv1053190.tail927db4.ts…

Pointez-vous mes agentiqueurs
Ça y est, le serveur Discord Communautaire
Hermes France 🇫🇷
est ouvert.
J’avais trop envie d’avoir un endroit où on peut se retrouver entre francophones, montrer ce qu’on construit avec Hermes, poser nos questions et se filer des coups de main.
Si tu l’utilises déjà, ou que t’as envie de t’y mettre, viens. Je sens qu’on va voir passer des trucs vraiment lourds là-dedans mdrrr
Qui nous rejoint ? Je mets le lien en commentaire.
Tokenophage retweeted

The same model, with the same weights, scores 62% in one agent harness and 33% in another.
@adithya_s_k and the @huggingface team just released the ultimate guide to multi-harness RL, and it's one of the most practical RL write-ups this year, and everything open!
The trick is simple. Don't touch the harness. Point it at a proxy instead of the model. The proxy speaks all four API formats coding agents use (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini). It records the exact token ids and logprobs vLLM sampled, and you train on that. You don't change a single line of Claude Code, Codex or OpenCode.
Results:
🔹 Trained across 4 harnesses at once, LFM2.5-2.6B by @liquidai went from 42% to 54%
🔹 31% fewer tool calls, thanks to a small bonus for solving tasks in fewer steps
🔹 Training in OpenCode alone took OpenCode from 34% to 58%, but the multi-harness model improved everywhere
They also tried the shortcut everyone reaches for: fine-tune on 3,189 successful rollouts from Qwen3.8-27B. Imitation plateaued at 47.5%, below both RL runs. Copying a bigger model doesn't get you there. Practice does.
The best part is that everything is open: the capture proxy in OpenEnv, the trainer in TRL, the tasks, the SFT data, the training code and all seven trained models.
Agents will run in dozens of harnesses.
Now open models can be trained for each of them, by anyone.
Read it here 👇
huggingface.co/spaces/FineEn…

Y'a encore des artefacts surtout au niveau des dents mais ça reste impressionnant

Introducing Griffin, the first model to pass the video Turing test.
48% of people who talked to it live thought it was a real human. Previous systems have had a pass rate <3%. It is #1 on NVIDIA's benchmark for full-duplex AI video.
It’s the first Human Interaction Model (HIM).
Readers added context they thought people might want to know
The 48% figure and "video Turing test" claim are from Tavus's own study of 54 one-minute calls, not independently verified or using a standard protocol. Griffin-Lite leads NVIDIA's VideoFDB benchmark on their public leaderboard.
cellcog.ai/blog/tavus-gri…
research.nvidia.com/labs/amri/proj…
tech-ish.com/2026/10/02/tav…
La gueule des dots me conforte dans mon idée que la DA d’Anthropic est infiniment meilleure que celle d’OpenAI
Ce que la science des données va devenir avec les llm ça va être quelque chose
8ème sur 4000 teams à une compétition Kaggle avec un système 100% autonome je crois qu’on se rend pas compte
Surtout que sur Kaggle les compétiteurs c’est pas n’importe qui, majoritairement des gros cracks dans le domaine sous Master/PhD ahah

As a test of our progress to advance the frontier of AI research, in June we entered the next generation of our autonomous AI research system, AIRA₃, in a live Kaggle competition run by NVIDIA to fine-tune a 30B Nemotron model. The challenge was to teach the model to reason better — all competitors had access to the same information and were graded externally on a private test set.
AIRA₃ placed 8th out of ~4,000 teams to win Gold, outperforming human competitors who had access to the same frontier tools.
We believe this is a reliable signal that AIRA₃ can improve a targeted capability of an AI model at a level similar to human experts.

