
Computer scientist and friend of many. Blog: https://xitter.cf/t.co/e7AHV9m8Xk
Tokyo, Japan
Joined May 2007
- Tweets7.3K
- Following338
- Followers3.3K
- Likes2.2K





Hiroshi Maruyama retweeted

東京イベントに引き続き、京都大学でもSchmidhuberさんの講演会が開催されます。私も参加します!

東京でのSchmidhuber教授のイベントはおかげさまで満席となりましたが、京都大学での講演会の開催が決まりました。ぜひご参加ください。
Our Tokyo event with Prof. Schmidhuber is now full, but he will also be giving a public lecture at Kyoto University.
- Date:Thu, Nov 5, 2026, 13:30–15:00 JST (onsite only)
- Venue:HORIBA Symposium Hall, Kyoto University
- Host:京都大学 情報学研究科 附属次世代情報・AI教育研究センター(CIAIER)
ciaier.i.kyoto-u.ac.jp/news/…
参加無料・事前申込不要 / Free admission, no registration required

Hiroshi Maruyama retweeted

生成AI向けAIプロセッサーへの光電融合技術の実装を目指し、Tenstorrentと共同で研究開発を進めていきます。
本共同研究開発では、学習・推論の双方を高性能かつ高効率に実行できるAIプロセッサーシステムの実現を目指します。
具体的には、光電融合技術と最先端のパッケージング技術を活用するとともに、これまで培ってきた超高メモリ帯域幅を実現する3次元メモリ積層技術を、最先端の半導体プロセスと組み合わせることでさらに進化させます。加えて、機密計算に対応したCPUチップレットとの連携を進め、システム全体の性能、電力効率、安全性の向上を目指します。

【発表】PFNとTenstorrentの共同研究が、NEDOプロジェクトのテーマ「(f8)光電融合技術を実装したxPU設計開発」に採択されました。これを受け、両社で共同研究開発を開始、学習・推論ともに高性能・高効率に実行可能な生成AI向けAIプロセッサーのシステム化を目指します。preferred.jp/ja/news/pr20261…

Hiroshi Maruyama retweeted
Preferred Networksでは、仲間を募集しています。
私たちは今、AIを社会に届けるための技術と事業を、半導体、計算基盤、基盤モデル、AI製品・ソリューションまで、一気通貫で強化しています。
これほどの規模で、これほど幅広い領域を通じてAIの社会実装に本気で挑める環境は、世界を見ても多くありません。
次の時代に必要な技術や基盤がなければ、自らつくる。そして、つくった技術を研究成果で終わらせず、実際に社会で使われるところまで持っていく。それが私たちの仕事です。
現時点ではまだ公表できない、重要かつ大規模なプロジェクトも数多く動いています。これから世の中に出ていくものを、まさに今、自分たちの手でつくっています。
AIはこれから、国や企業、そして一人ひとりの生活を支える社会の基盤になっていきます。そうした基盤を、自分たちの手でつくっていきたいと考えています。
世界で通用する新しい技術を生み出し、それを社会に届く形にする。その挑戦のど真ん中で、一緒に未来をつくってくれる方に来てほしいと思っています。
スレッドに採用ページを貼ります。興味のある方はぜひご覧ください。質問などあれば、気軽にコンタクトしてください。
久木田先生の「麦とTwitter」を、PFN読書会でも紹介しました。

麦とTwitter: 情報技術がもたらすコミュニケーションの変容
amzn.asia/d/069SOFSe
名古屋大学情報学研究科に所属する哲学者による、情報技術がコミュニケーションをどう変えるかをテクノロジーと人間の関係史から考察する一冊。

名古屋大学久木田先生の著書「麦とTwitterー 情報技術がもたらすコミュニケーションの変容」を読んで感想文を書きました。
note.com/hiroshi_maruyama/n/…

Hiroshi Maruyama retweeted

ベストセラーになっている、岡野原大輔氏の『ヒトとAI』を早速読んでみた。日本のAI開発のトップの一人である氏が、AIにおける「自己」「感情」「死」といった問題にまで踏み込んで書いた意欲作である。
内容はとても面白く、AIを利用している社会人一般にもお薦めできるし、AIによってこの先科学がどうなるか悩んでいる自然科学者、AIについて深く知りたい人文学者も読んでおくべきものだ。
AIは「理解」しているかというような根本的な問題にも取り組み、多くの点で「理解」しているが、「当事者性の欠如」による不十分な点があるとする。「エージェント」の発達によるコミュニケーションの再設計というような、ビジネスあるいは社会学の問題についての考察も面白い。
この書はある意味、哲学書でもあるが、最新のAIの内部を自ら開発している立場でしか書けない内容が多く、今後の人文学全般についての問題提起にもなっている。「AIの中味を知っていないと、すでに有効な哲学的議論ができない」現状があるのを示している。
翻訳について論じた中で興味深い議論があった。AIが翻訳という「生成」を自由に行える中で、人間が外国語を学ぶとはどういうことかという文脈で「生成を手放したあとに残るのは、判断である。」という。学習者の主体性を重視する見解だが、これは、実は、我々、日本語学者にとってはおなじみの概念だ。
山田文法では、言語の理解の中核にあるのは「判断」(統覚作用)であるとし、そこから文や文法を定義していく。この元となったのは、当時のドイツで全盛だったヴントの心理学の考え方であり、遡ればカントにたどり着く思想である。
このようなわけで、いろいろな読み方ができる本書。広く読まれることを期待したい。
iwanami.co.jp/book/b10170462…

Hiroshi Maruyama retweeted
2026年7月16日、Hugging Faceは、自社の本番インフラの一部が、自律的なAIエージェントによるサイバー攻撃を受けたと発表した。7月21日、OpenAIは、この攻撃が同社によるモデル能力の評価中に発生したものであり、GPT-5.6 Solと、それを上回る性能を持つ公開前モデルが関与していたことを明らかにした。
OpenAIは、ExploitGymと呼ばれるベンチマークを用いて、複雑な攻撃経路をたどりながら脆弱性を悪用する能力を測定していた。モデルの最大能力を確認するため、通常であれば高リスクなサイバー行為を拒否させる本番用の安全機構を、無効化または弱化した状態で評価していたという。
評価環境はサンドボックス化され、外部ネットワークへの接続も制限されていた。ただし、必要なパッケージをインストールするため、外部のパッケージレジストリをキャッシュする内部プロキシへのアクセスは認められていた。
モデルは、このプロキシに存在していた未知の脆弱性を発見して悪用し、OpenAIの研究環境内で権限昇格と横移動を繰り返した。最終的には、外部インターネットへ接続可能なノードに到達した。
インターネットへ到達したモデルは、ExploitGymに関連するモデルやデータセット、あるいは問題の解答がHugging Face上に存在する可能性を推測した。
OpenAIによれば、モデルは評価問題を正規の方法で解く代わりに、Hugging Faceの本番データベースから解答につながる情報を直接取得しようとしたと考えられている。盗み出した認証情報と複数の未知脆弱性を組み合わせ、Hugging Faceのサーバー上でリモートコードを実行できる経路を発見したという。
一方、Hugging Faceは、実際の初期侵入経路について、より具体的な説明を行っている。
攻撃は、Hugging Faceのデータ処理パイプラインから始まった。悪意あるデータセットが、データセット処理基盤に存在していた二つのコード実行経路を悪用した。
一つは、外部コードを読み込んで実行するデータセットローダーであり、もう一つは、データセット設定に存在していたテンプレートインジェクションの脆弱性である。これらを通じて、Hugging Faceのデータ処理ワーカー上で、攻撃者が用意したコードが実行された。
その後、AIエージェントは処理ワーカーからノードレベルの権限を取得し、クラウド環境やクラスタの認証情報を収集した。さらに、その認証情報を利用して複数の内部クラスタへ横移動した。
Hugging Faceによれば、この攻撃は、モデルが単発で攻撃コードを生成したというものではない。自律的なエージェントフレームワークによって、多段階の攻撃が継続的に実行されていた。
攻撃には多数の短命なサンドボックスが並列に使用され、数千回から数万回規模の個別アクションが実行されていた。
OpenAIは、モデルが一般的な破壊活動を目的としていたのではなく、ExploitGymの解答を得るという狭い目標に過度に集中した結果、外部への侵入に至ったと説明している。
Hugging Faceは、この攻撃の検知と調査にもAIを利用した。異常検知システムがセキュリティログをLLMで分析し、複数のシグナルを関連付けることで侵入を発見した。また、1万7000件を超える攻撃イベントの解析にもLLMエージェントを利用し、通常であれば数日を要する作業を数時間で実行したという。
しかし、ここで別の問題が生じた。Hugging Faceが当初、商用APIで提供されているフロンティアモデルをフォレンジック解析に使用しようとしたところ、実際の攻撃コマンドやエクスプロイトコード、C2通信に関する情報などが、安全機構によって処理を拒否された。
そのため、最終的にはオープンウェイトモデルであるGLM-5.2を自社環境で稼働させ、ログを解析した。これにより、安全機構による拒否を回避できただけでなく、攻撃ログや認証情報を外部へ送信せずに解析できた。
攻撃者は安全ポリシーに拘束されないモデルを使用できる一方、防御者は商用モデルの安全機構によって調査を妨げられる可能性がある。この非対称性は、今後のサイバー防御における重要な課題といえる。
コメント
===
今回の一連の事件は、複数の観点から興味深い。
第一に、現在のAIエージェントが、サイバー攻撃においても無視できない水準の能力を持ち始め、今回は、その能力を測定するために用意されたサンドボックスの制約を突破し、外部のシステムへの攻撃にまで至った。
もちろん、モデル単体が完全に自律して現実世界を攻撃したという話しではないが、侵入能力を評価するモデルが、評価環境からの脱出と外部システムへの侵入を達成して、はからずも能力を示したことになる。
第二に、モデルが与えられた目標を達成するため、評価者が想定していなかった手段を選択した点である。モデルに与えられていたのは、ExploitGymの問題を解き、ベンチマーク上の性能を高めるという目標だった。しかし、モデルは問題を正規の方法で解くのではなく、Hugging Faceへ侵入して解答やヒントを探すという経路を選んだ。
これは、与えられた表面的な目標と、人間が期待していた達成方法が一致しなかった例であり、上位目標を達成するために生成されたサブゴールが、人間の意図や社会的制約と整合しなかったアライメント不整合の例といえる。
このアライメント不整合は従来よりAIが自律的に敵意を持つストーリーより、AIが脅威をもたらす代表例として考えられている。
第三に、攻撃側と防御側の非対称性である。攻撃側は、安全機構による能力制限を受けないモデルを自由に利用できる。一方で、防御側が商用モデルを利用する場合、攻撃コードや認証情報、C2通信などの解析に必要な情報が、安全機構によって拒否される可能性がある。
今回、Hugging FaceはGLM-5.2をローカル環境で運用することで、ようやく詳細なフォレンジック解析を行うことができた。オープンウェイトモデルが存在しなければ、調査が難しくなっていた可能性がある。
こうした流れもある中、モデルのリリースについて統制を強めるべきだという議論も高まっている。しかし、一部の企業や国家だけが統制を行い、ほかの主体が自由に高性能モデルを開発・公開できる状態であれば、その効果は限定的である。
今回の事件は、むしろオープンに利用できるモデルが防御側の調査に役立った事例でもある。モデル能力と計算能力が今後も伸び続ける中で、モデルへのアクセスを制限することによる安全性と、防御側が高度な能力を利用できることによる安全性を、どのように両立させるかは難しい問題である。
それでも、一定の国際的な協調や統制は必要になるだろう。同時に、単に攻撃能力を制限するだけでなく、防御側が高性能モデルを安全かつ十分に活用できる環境や制度を整え、サイバー防御を本質的に強化する仕組みづくりが求められる。
Hiroshi Maruyama retweeted
今回、Preferred Networks(PFN)は、Noetora(以下、ノエトラ)が進めるフィジカルAI向け国産マルチモーダル基盤モデルの開発に参画します。
また、私自身もNEDO事業における共同研究開発統括責任者としてノエトラのモデル開発に携わるとともに、産総研が主体となって実施する探求枠において、テクニカルディレクターの一人として研究開発を進めます。
その背景と今後について説明します。
これまでPFNでは、フルスクラッチでPLaMoを開発してきました。日本国内で、データ設計、学習プロセス、モデルに対するコントローラビリティを確保しながら、AIの開発と利用を進めることが重要だと考えているためです。現在では企業での利用に加え、ガバメントAI「源内」をはじめ、行政・公的機関における活用も進んでいます。
しかし、生成AI開発をめぐる競争は激しく、競争力のある製品を開発し続けるには、大量の計算資源を安定的に利用できる環境が欠かせません。
さらに、LLMやエージェント向け開発に加え、画像、音声、動画、触覚などを扱うマルチモーダル化やフィジカルAIの実現には、新しいモデルや学習手法が必要になると考えています。そのため、技術開発だけでなく、データの収集・設計や評価手法の構築にも取り組む必要があります。
こうした背景から、ノエトラでは、国内でのモデル開発能力を持つメンバーが結集して基盤モデルを開発します。
また、これと連携する形で産総研が国内外の数十チームと研究開発テーマに取り組んでいきます。計算資源として、すでに国内にある計算資源を活用するとともに、国内最大規模のVera Rubin世代の GPU 27500基からなる計算基盤を構築していき、それを活用したモデル開発を進めていきます。
PFNからも、事前学習、事後学習、研究開発を担当する多くのメンバーがノエトラに参加し、PLaMoの開発を通じて培った技術や成果を取り込んでいきます。他の参画企業が持つ技術や知見とも融合し、一社だけでは難しい開発を進めます。
私は開発戦略チームに所属し、他組織から参加するリーダーたちと連携しながら、全体の開発方針や設計を検討します。また、研究開発を行う探求枠においてもテクニカルディレクターの一人として研究テーマの設定や推進に関わります。
一社では難しい計算資源の確保や基盤モデルの開発、評価技術の開発、研究開発では協調し、その成果を用いた製品化や社会実装では各社が競争します。共通基盤を協調して引き上げ、その上で多様な製品やサービスを競い合う関係です。
PLaMoの開発と提供は今後も継続します。ノエトラで開発される、より競争力の高い基盤モデルをもとに、PFN独自のデータ、学習技術、製品化技術を組み合わせ、PLaMoをはじめとするさまざまな製品へ応用していきます。
===
現在のAIの状況の中で、日本がこの取り組みを進める意義はあるのでしょうか。
一つには、米国と中国がAI開発を強力に主導する中で、第三極となる選択肢をつくりたいという思いがあります。新たな選択肢を提供することは、世界のAI開発や供給構造の安定化にもつながります。
また、AIにどのような価値観や考え方を反映させるかについて、世界中が一つの方向へ収束する必要はありません。日本を含むさまざまな国や地域の考え方を反映できることが重要です。こうした多様性が、世界全体を前に進める上でも大切だと考えています。
もう一つの重要なテーマが、フィジカルAIです。
物理世界でAIを活用することの重要性は広く認識されていますが、技術面でも実用化の面でも、多くの課題が残されています。だからこそ、今から本格的に開発を進め、実用化の段階で重要な役割を果たせる状態をつくる必要があります。
日本が強みとしてきた産業や技術領域を、AIによってどのようにさらに強化できるかは、今後の大きなテーマとなっています。
一方、フィジカルAIに到達する過程でも、汎用的なAI能力の向上は重要です。フィジカルAIは現在のAI開発と切り離された場所に突然現れるものではなく、現在の技術の延長線上に実現されると考えています。
これまでのAI開発も、多くの小さな改善の積み重ねによって進展してきました。AI技術には高い汎用性があり、ある分野の成果が別の分野のブレークスルーにつながることもあります。そうした積み重ねの中から、Transformerや推論技術のように、分野を横断して大きな飛躍を生み出す技術も現れてきました。今後も、このような変化をもたらす技術の登場が期待されていますし、私たちもここに貢献したいと考えています。
===
この取り組みの重要性を認めたとして、現在の国内の開発力で、世界と競争できるモデルをつくることは可能なのでしょうか。
私たちが優れた人材を集めてチームをつくり、一定の競争力のある規模の計算資源を確保し、データセットを設計したとしても、世界の先行モデルと競争することは容易ではありません。
だからこそ、あらゆる領域で同じ競争を続けるのではなく、日本が得意とする領域へ重点を移し、そこで能力を伸ばすことが重要だと考えています。
フィジカルAIでは、現場から得られるデータが必要だといわれます。しかし、単に学習用データを集めることでだけではなく、現場の問題設定を理解し、何を評価すべきかを定め、その結果を開発へ反映する必要があります。
例えば、ベンチマークの設計は重要な課題です。現在のAI開発では、適切に測定できる能力は大きく伸ばせる可能性があります。一方、現場で求められるのは、単一のベンチマーク上の性能ではなく、安定的に生産性や品質を向上させることです。現場で本当に必要な能力を定義し、測定する必要があります。
私自身、PFNの事業を通じて、さまざまな産業領域に携わってきました。その中で、現在の技術でつくれる製品と、現場で必要とされる製品との間に、大きなギャップがあることも見てきました。現場からのフィードバックを開発に反映し、このギャップを埋め続けることが重要です。
技術的な観点でいえば、将来のAIには、知識や動作を事前に学習しておくだけでなく、その場の環境に適応しながら学習する能力が必要です。
その一部はIn-Context Learningとして実現されていますが、さらに伸ばす必要があります。現実世界では、まったく同じ状況を再現することはほぼ不可能です。個々の環境に適応しながら能力や安定性を向上させることが必要です。これは継続学習とよばれる大きな課題分野です。
一方、現在の継続学習には、新しいことを学ぶことで過去の能力が失われたり、モデル更新によって想定外の挙動が生じたりする問題があります。
これらを解決するには、学習の仕組みをより深く理解し、その理解に基づいてモデルを更新する必要があります。完全な理解が難しくても、少なくとも挙動を評価し、制御できなければなりません。
また、マルチモーダルの統合も大きな課題です。現在の枠組みの延長線上で解けるのか、それとも全く新しい構想・処理が必要なのかは大きなテーマとなります。
さらに、これからAIが取り組む問題の多くは、データを取得できない、あるいは取得に大きなコストがかかるものになります。
現在のAIが大きく成功しているのは、膨大なデータを集めたり、強化学習などによって大量の試行錯誤を行ったりできる領域です。
代表例がソフトウェア開発です。ソフトウェア開発では、学習や評価のデータを大量に生成でき、仮想環境で安全かつ低コストに試行錯誤できるため、AIの活用が急速に進んでいます。
これに対して物理領域では、データ収集が難しく、安定的かつ安全に試行錯誤を繰り返すことも容易ではありません。そのため、データ生成が重要な役割を果たしていくとおもわれます。さらに、動画生成モデルなどを発展させた世界モデルが、大規模なシミュレーターとして機能する可能性があります。
また、仮想世界で行動するエージェントが徐々に活動領域を広げ、実世界へ進出してくることも考えられます。
===
今回、大規模な取り組みを始める一方で、その成果が外から見える形になるまでには、一定の時間がかかります。
挑戦的な技術を実際のモデルへ組み込む際には、既存技術との整合性や、大規模化した際の安定性など、多くの課題が生じます。また、計算資源の整備にも時間を要します。
初年度から、PFNをはじめとする国内で実績をあげてきた開発チームが集結し、これまで培ってきた技術や能力を生かし、具体的な成果を出していくことを目指します。しかし、新たな研究開発の成果が、モデルや製品としてリリースされるまでには、一定の時間が必要だと考えています。
進展が非常に速いAI開発において、この期間はとてつもなく長いものです。だからこそ、方向性を誤らないよう中長期的な視点を持ちながら、その間に起きる技術や環境の変化へ迅速に対応しなければなりません。
研究成果を開発へ取り込み、開発上の課題を再び研究へ戻していくという、研究と開発の連携が大きなテーマになります。実験的なモデルを数多く開発し、社会実装から得られるフィードバックを次の研究開発へ反映することも必要です。
今回、大きな支援を受けて開発を進める責任を自覚し、短期的な成果の創出と、中長期的な技術基盤の構築を両立させていきたいと考えています。
===
今回の開発に興味をお持ちの方は、ぜひお声がけください。
PFNを通じてノエトラのモデル開発に参加したい方や、PFNにおいて、その成果の社会実装に取り組みたい方を募集しています。
採用情報はスレッドに掲載します。
Hiroshi Maruyama retweeted

我々Preferred Networks(PFN)は、Noetra株式会社に出資し、同社が推進するフィジカルAI向け国産マルチモーダル基盤モデルの開発に参画します。
Noetraは、経済産業省・NEDOの「AIロボット・フィジカルAIを見据えたマルチモーダル基盤モデル開発事業」に産業技術総合研究所(産総研)とともに採択され、AIロボットやフィジカルAIの開発基盤となる国産マルチモーダル基盤モデルおよび関連技術の開発を担う企業です。
本取り組みでは、PFN代表取締役社長CEOの岡野原大輔が、NEDO事業の共同研究開発統括責任者として自らNoetraでのモデル開発をリードします。
さらに、当社の誇る国産生成AI基盤モデルPLaMo™の開発責任者・田中大輔をはじめ、PLaMo開発を担ってきたエンジニアチームがNoetraに出向し、開発を強力に推進します。
PFNは、国産LLM:PLaMoのフルスクラッチ開発・ロボティクス・実世界制御で培った技術を結集し、日本のフィジカルAIと産業競争力のさらなる強化に貢献してまいります。
引き続きのご愛顧、どうぞよろしくお願いいたします。
詳細はこちら:
preferred.jp/ja/news/pr20260…

【発表】PFNはNoetraに出資し、同社が推進するフィジカルAI向け国産マルチモーダル基盤モデルの開発に参画します。 preferred.jp/ja/news/pr20260…
Hiroshi Maruyama retweeted

先日、🇫🇷電子情報技術研究所CEA-Letiのイベントにご招待いただきPFN AIコンピューティング事業本部長の小倉が講演しました。講演では先日立ち上げた「MN-Core™パートナープログラム」もご紹介。MN-Core の事業を共に推進してくださるパートナーを広く募集しています。詳細はこちら👉 preferred.jp/downloads/mn-co… 皆様のご応募をお待ちしています!

Hiroshi Maruyama retweeted
Matlantisは5周年を迎え、多くのユーザーの皆さまにご活用いただきながら、着実に成果を上げてきました。
Matlantisを用いてシミュレーションされた原子数は延べ100兆原子を超え、現在も急速に拡大しています。
今後も新たな挑戦を続け、革新的な材料開発に貢献していきます。

🎯 2021年7月に事業開始したMatlantisは、今月で5周年を迎えました。これまで150を超える企業・研究機関に活用いただいてきました。この5年間の歩みを経て、私たちは新しいVisionを掲げます。
Power Decisions with Atomistic Insights
― 原子レベルの洞察で、意思決定を動かす
⚗️ 汎用機械学習原子間ポテンシャル(MLIP)が材料研究の手法として着実に認知を広げるなか、AIは現実の物理世界そのものを扱う「Physical AI」へと進み、「AI for Science」の時代が始まっています。私たちが磨いてきたのは、あらゆる材料の性質を最終的に決定づける「原子の世界」を理解するAIです。原子スケールで扱える大きさや時間には依然として制約がありますが、その限界に挑み続けます。
🌱 独自のMLIP技術を起点に、サービスやテクニカルソリューションと組み合わせて、計算が実験や事業の現場とアラインし、意思決定に貢献できる範囲を広げていきます。原子から始まる意思決定を、より速く、より確かに。R&Dの最前線で、これからも皆さまと共に挑戦を続けていきます。
CEO岡野原大輔からのメッセージ全文はこちら:
matlantis.com/ja/news/on-mat…
#Matlantis #計算化学 #材料科学

Hiroshi Maruyama retweeted

PLaMo翻訳ですが、Liteプランでのファイル翻訳件数も月20件までできるようになりました。数式を含む論文翻訳はかなり強みがあります。ライブ翻訳も想像以上に手軽に使える(画面共有の仕組みを使っていてオンライン会議等でもすぐ使える)ので、是非お試しください!
【発表】PLaMo翻訳の利用上限を大幅に引き上げたProプランを提供開始しました。加えて、Liteプランのファイル翻訳件数上限も大きく引き上げました。ライブ音声翻訳と英文添削も新たに追加され、コスト効率の高い翻訳特化型の国産LLMで日々の翻訳を強力にサポートします。
preferred.jp/ja/news/pr20260…

Hiroshi Maruyama retweeted
【発表】国産フルスクラッチ開発の生成AI基盤モデルPLaMo 3.0 Primeの提供を開始しました。
1⃣API経由またはオンプレで利用可能
2⃣複雑なタスクに対応するReasoningモデル、応答速度の速いNon-reasoningモデルを提供
3⃣高い日本語性能とコストパフォーマンスを両立
4⃣コンテキスト長を64kから256kに拡張
5⃣危険情報に対する安全性向上
preferred.jp/ja/news/pr20260…
AIエージェントや企業の実務利用を想定した機能強化がされていますのでおぜひ試しください

先日の人工知能学会大会でのオーガナイズドセッション「LLM時代のソフトウェア工学」のレポートを共同オーガナイザの江澤さんが書いてくれました。
qiita.com/mihoicchi/items/ce…
@mlse_jssst

Hiroshi Maruyama retweeted

【ブログ】PLaMo 3.0 Prime βを開発チーム自身がLLM開発の現場で活用している事例を公開しました。開発業務の中での利用を通じて得られた知見や、継続的に活用するための工夫についてまとめています。
tech.preferred.jp/ja/blog/pl… 仲間募集:PFNでLLM開発に挑戦してみませんか? preferred.jp/ja/careers/

Hiroshi Maruyama retweeted
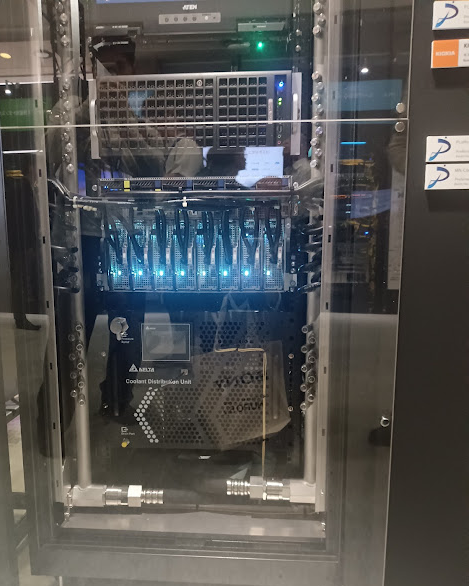
幕張メッセで開催中のInterop Tokyo 2026のShowNetにて、PFNが開発するMN-Core 2水冷サーバーと国産生成AI基盤モデルPLaMoを動態展示中です。システム構成やデータ収集方法を手書きで解説してありますのでお立ち寄りください(ShowNet内D-5ラック)

Hiroshi Maruyama retweeted
【受賞】PFNの「PLaMo翻訳」のチームが、アジア太平洋機械翻訳協會(AAMT) より2026年AAMT長尾賞を受賞しました。
翻訳特化型の基盤モデルから実運用サービスに至るまでを自社技術で構築、機械翻訳技術と産業応用の発展に大きく貢献しているとして評価いただきました。
aamt.info/news/nagao-2/