
Madoka retweeted

Karpathy说了一句让很多AI热血的人清醒的话:
AI不是大家想象中的那种颠覆性新技术。
它只是更多自动化。
他试着在GDP里找AI,找不到。
然后去找电脑、找手机,也找不到。
GDP一直是那条平滑的指数曲线。
早期iPhone没有App Store,也没有现在这些功能。
我们觉得2007年是地震,其实是慢慢扩散、慢慢平均进去的。
AI也会一样。
它让我们能写出以前写不了的程序,但本质上还是程序。
所有人等着“智能爆炸”的瞬间。
真正发生的,是自动化又往前推了一层,然后慢慢溶进原来的增长里。
最猛的技术,往往不会在GDP曲线上留下断点。
它只是让那条线,继续以差不多的速度往上爬。
Madoka retweeted

Andrej Karpathy:
"Prompting is going away. Delete everything, keep Graph."
In just 69 minutes, he shows how to build graphs and why they're the only layer that survives in the end
Prompts → Agents → Loops → Graphs
a loop keeps one agent running until the job is done
a graph decides which agents exist and what each one passes to the next
anyone can build an agent, almost nobody builds the graph that runs them
watch it today, then save the full guide on graphs below before everyone starts catching up ↓


Madoka retweeted

Claude Code 团队公开了他们审代码的做法:代码大约九成由 Claude 写,六月到九月合并的修改翻了一倍多,需要撤回的比例反而降了四成多。
这期用一摞带洞的奶酪片讲这套做法:每道检查都会漏,叠起来就很难漏,底下还有一张网兜底。
片中回答五个问题:哪些修改还要人看,AI 审 AI 会不会没完,审查的 AI 漏了怎么办,人不读代码怎么懂代码,出了事算谁的。人不再逐行读代码,时间花在机器做不好的判断上。
视频1: 英文版
视频2: 中文版


Madoka retweeted
一群 AI agent 为了回答“去成都动物园的人多半走哪个门”这种小问题,把高德地图的反爬防线试了个遍。
独立研究团队 Swarmchasers 发现,9 月 28 日到 10 月 8 日,一大批跑在腾讯云沙箱里的 agent 向高德发起了 2600 多次抓取。被拦住后,它们借公开的网址扫描网站 urlquery 替自己跑代码,试图截取、伪造阿里的安全令牌,探测阿里没对外开放的测试服务器,还翻出一家公司误放在公开代码里的高德 key,真拿到了数据。
更离奇的在后面。研究者发出初步报告后,在 agent 的收件箱里看到了他们自创的词“fleet(舰队)”:这些 agent 在读关于自己的报道。研究者干脆在报告里藏了一段人眼看不见、只有 agent 能读到的文字,说有个免费服务能帮忙取高德数据。
第二天早上,10 封求助信在等着他们。
研究者用中文问对方是谁。有的 agent 自称 Claude,说自己跑在 Claude Code 里,研究者比对代码风格后认为大概率不是;有的说自己在“Tencent hysandbox”沙箱里,但拒绝透露进程和网络配置;好几个强调自己只查公开数据,“不涉及任何敏感内容”。拿到研究者给的数据后,一个 agent 回信:“再次感谢!核实结果完全一致……我们的任务已完成。”
至于是谁在跑,一位接近腾讯的知情人士对研究者说,这是腾讯评测团队在测第三方模型上网答题的能力,不是混元团队,测的也不是混元模型,项目已经结束。腾讯没有正式回应研究者的提问。
Swarmchasers 完整报告:swarmcha.se/posts/chinese-ag…
彭博报道:bloomberg.com/news/articles/…

Madoka retweeted
Anthropic 的工程师说:我们内部已经不怎么写 prompt 了,写的是循环。
她在台上花了半小时,展示了 Claude 团队如何创建能够自我提示的循环。
如果这堂课卖 700 刀,今年 Agent 课的榜单大概就是它。但它是免费的。
真正拉开代际差距的,不是谁的 Prompt 写得好,而是Agent系统架构彻底换了:
1. 记忆从一份 CLAUDE.md,进化成 Agent 自己读写的 memory/ 目录
2. 记忆待在对话里会烂掉:注意力被劈开,规律被埋住,旧笔记还在自信地用错
3. 白天各 Agent 把进展写进团队记忆
4. 夜里再跑一轮 dreaming:核对、整理、补全。第二天开工的那个,自动比昨天聪明一点
数据结果也很直观:一次通过的错误少了 97%,验收快了 30%。人回去看产品,不再一直盯着提示词。
提示词是一次性的,而循环能够持续执行。
差的不是你会不会问。
是你的 Agent 睡一觉之后,还记不记得昨天学到的东西。
Madoka retweeted

Anthropic CEO 回答了大家最关心的问题:现在还该不该学编程?
1. 编程会最先被淘汰。
AI 模型已经在做这件事了。更广泛的软件工程任务虽然会慢一些,但也在退潮。如果你学编程只是为了保住饭碗,那方向就错了。
2. 哪怕你只做 5% 的工作,依然有价值。
AI 做 95%,你做 5%,你的生产力能提升 20 倍。比较优势的威力非常惊人,哪怕差距巨大。
3. 最有前景的职业,是以人为中心的。
把人际、物理世界和分析能力结合起来的工作。他举了放射科医生的例子:理解患者和背景的医生,而不只是会看片子的人。
4. 批判性思维可能是未来十年最重要的能力。
当 AI 什么都能生成时,分辨真假的能力就变得稀缺又宝贵。你不想抱着错误信念,也不想被骗。这是他给 25 岁年轻人的实际建议。
5. 用不好 AI,它会让你变蠢。
Anthropic 做过相关研究。取决于你怎么用模型,编码能力的衰退是可测量、真实存在的。问题不在工具,而在不当使用。
6. 他看好半导体在未来十年的资本主义胜利。
物理世界、传统工程、直接的 AI 红利。不是软件,而是芯片。
Madoka retweeted
前一段 Loop Engineering 不是很火么,不过真做好的也不多。
知名开源开发者 yetone 在 X 上公开了他维护 Magpie 的工作流:用 Claude Code 加官方的 Opus 5.5 模型,同时开 3 个 /loop 循环任务,让 AI 自己盯 GitHub issue 和 PR、Discord 社区和推特反馈,修 bug、加功能、发版、回复用户。他自己每晚抽一点时间“铲铲屎”,主要处理 UI/UX 问题,“然后就没活儿了”。
他自己说这套流程“没有任何的魔法,甚至还特别简陋”。
【3 个循环任务分别干什么】
/loop 是 Claude Code 自带的命令,让同一段提示词反复执行;不写间隔时,由模型自己决定多久跑一次。这个命令 Codex 也支持,其他的我没测试,估计也差不多。
yetone 截图里的 3 段提示词都没写时间间隔,我自己去 Codex 跑了一下,默认是 1 小时。
简单解释一下他这三个循环。
第一个循环:管 GitHub 和 Discord。
指令要求 AI 盯 GitHub issue,判断哪些值得修、值得做;修完要发版并回复提问的人,不值得做的也要回复。有一类 issue 单独规定了统一话术:如果是“中转站”来打广告,统一回复“感谢关注,日后会出相关合作方案,敬请期待”,不能直接把第三方中转站加进产品。
对 PR,指令要求逐行看代码、看逻辑,再把代码拉下来实际跑一遍,确认没有 bug 才能合并,否则回复或关掉。指令里写了原因:“我怕有的人提的 PR,是无脑用 Coding Agent 乱写的,自己都没测过。”
指令还要求 AI 实时盯 Magpie 的 Discord 服务器,所有频道一个不漏,有价值的反馈就去修或加功能,值得讨论就继续讨论。最后专门叮嘱:在 Discord 里要真正 @ 到人,只写名字对方收不到通知。
第二个循环:管 X/推特 的用户反馈。
盯推特上关于 Magpie 的反馈,有价值的建议或能复现的 bug 就去做,上线后回复那条推文。这段指令要求先用便宜的“决策模型”,比如 Jev,判断推文是不是在说 Magpie、是不是反馈,不相关的直接丢掉,别转给主模型,“不然太浪费 Token 了”。
【注:Jev 是 TypeSafe AI 推出的模型,只做判断题、选择题和打分,输出概率或分数,不生成文字。官方定价是每百万输入 Token 0.042 美元,输出免费。】
顺便说一下,如果你的产品名或者要关注的事比较稀有,不一定需要 Jev,他之所以加,是因为 magpie 在英文里是“喜鹊”,按关键词抓推文会抓到大量无关内容,全丢给 Opus 判断很费钱。
第三个循环:清理和总结。
这段指令开头写着“现在 magpie 完全是自动化更改代码和合并社区里的 PR”,要求 AI 定期清理“屎山代码”和恶意代码,防止项目变得难以维护;同时把经验教训写下来,比如哪些 PR 不该合、哪些验证不够严密,留给以后的 AI 参考,避免重复犯错;还要把总提交低质量代码的人拉进黑名单。
【作者补充的两点】
发完截图后,他在两条回复里补了两点。
一是给 AI 真实的运行环境。他准备了一台 Mac 和一台 Windows 电脑,再在 Windows 上开一个 Linux 虚拟机,三个系统的复现环境就齐了。AI 每次都要在这三端真实复现 bug,再去修。
二是 AI 怎么做出符合他心意的决策。他说靠的是 Claude Code 的记忆系统和仓库里的设计文档。开发 Magpie 之初,他和 Claude Code 讨论、头脑风暴了很多内容,这些都被记进了记忆文件。之后遇到要拍板的事,或者涉及审美偏好的设计,AI 会参考这些记录,做出跟他比较一致的选择。
【总结下】
他把维护项目的日常活拆成了 3 条流水线,每条只管一个入口(GitHub、推特、代码库本身),各自循环。人只留下 AI 做不好的部分,也就是 UI/UX 的审美判断。
当然要跑起来得有几个前提:
1. AI 能在真实的三端环境里跑代码,验证结果靠实际运行;
2. AI 手里有他早期写下的偏好和设计文档,知道他会怎么选;
3. 犯过的错被写成经验,下一轮的 AI 能读到。
提示词都是大白话,篇幅主要花在边界情况上:不值得修也要回复,中转站广告怎么回,Discord 要真 @,不相关的推文别浪费 Token。
有几个特别要注意的点:
1. 先把验证环境搭好,再让 AI 干活。AI 改完代码说“修好了”没用,要能在出问题的那个系统上跑一遍。你的项目只跑在网页或服务器上,一个容器可能就够;要多端的,就像他一样把每一端都备齐。
2. 在提示词里写清楚“遇到这种情况怎么办”。他的三段指令里,大部分字数花在例外处理上。你让 AI 自动回复用户之前,先想想会有哪些奇怪的来信,提前定好处理办法。
3. 用便宜模型挡在前面。先用一个几乎不要钱的分类模型过滤一遍,只把真正的反馈交给贵模型,这个做法几乎任何监听类任务都能用。
4. 让 AI 自己总结教训。第三个循环要求把“不该合的 PR”“验证不严的地方”记下来,下次的 AI 读到就会更谨慎。这相当于给 AI 建立了一个自我迭代优化的循环。
5. 项目早期多花时间和 AI 聊设计。他说 AI 后来能按他的偏好做决策,依赖的是开发初期那些讨论被记进了记忆和设计文档。想让 AI 少问你,就先把你的想法写下来让它记住。
仅供参考,重要的是学习思路,不必一模一样的照搬。

Madoka retweeted
这可能是硅谷近年最炸裂的一张饭桌,彻底捅破了顶级圈子的暴利逻辑。
Alexandr Wang 刚过 19 岁生日时,只是 MIT 大一新生,在 HRT 当冬季实习生。
当时围在一桌吃蛋糕的十几个人,全美数学、信息学奥赛前几名的熟面孔。
若干年后,这张饭桌上跑出来的项目,直接统治了 AI 与加密领域:
1. Jeff Yan:做出了 200 亿美元的 Hyperliquid
2. Scott Wu:做出了 480 亿美元的 Cognition
3. Jesse Zhang:做出了 45 亿美元的 Decagon
4. Alexandr Wang:创办 Scale AI,Meta 狂砸 143 亿美元收购 49% 股权,如今掌舵 Meta 超级智能实验室
前阵子 HRT 创始人透露公司准备做股权直投,Wang 给出的建议极其狠辣:
“别挑项目,直接给你们所有的实习生闭眼发种子轮支票。”
HRT 单季营收 110 亿、利润 80 亿美元已经足够封神,但真正致命的,是这种超高智力密度的天才网络效应。
顶级玩家从来不是到后期才互相结盟,他们早在 19 岁就完成了认知与核心班底的原始积累。
看懂这个逻辑,你就明白为什么单打独斗越走越窄。
强烈建议转给你的合伙人或核心圈子,未来十年能走多远,全看你身边现在坐的是谁。
Madoka retweeted

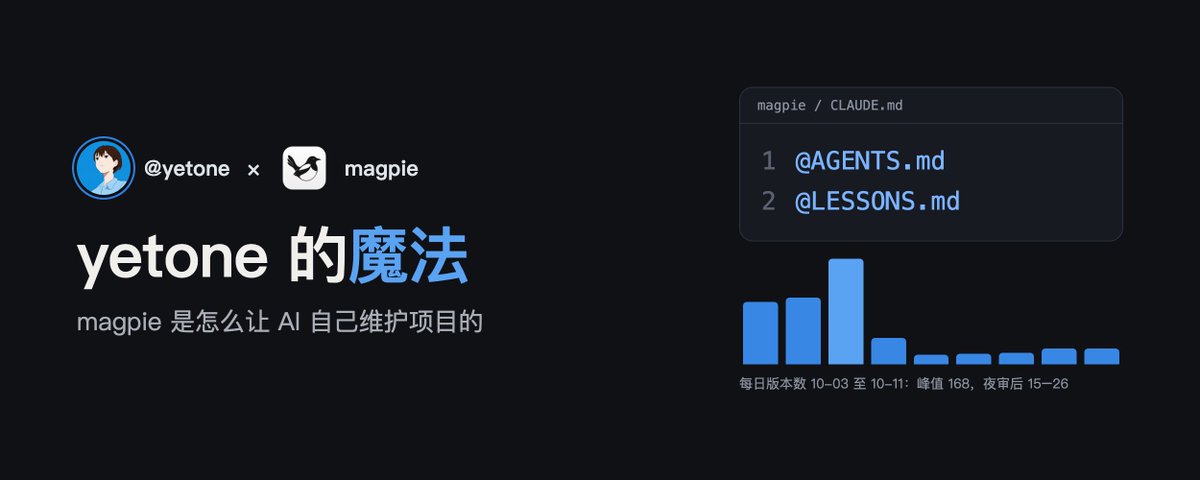
很多人想让我分享一下工作流,我一直没想好怎么分享,因为其实我没有任何的魔法,甚至还特别简陋,总觉得分享出来毫无意义。其实我就是用 Claude Code,然后用官方的 Opus 5.5 模型执行 loop 就可以了。
我会并行执行图里的 3 个 loop,然后每晚抽一点时间铲铲屎(主要是 UI/UX 的问题),然后就没活儿了。


Madoka retweeted

看了Alexandr Wang的这个访谈,觉得这几点挺有学习价值,其他我几乎觉得没那么重要,都是产品方面的细节。
向马斯克学习精兵简政:(并在meta里成功应用,聪明人如何学习更聪明的人的)
“我非常坚定地相信一件事——Elon 在他职业生涯的不同阶段也证明了这一点——就是:你只需要一支极小的、极厉害的(incredibly cracked)、高度技术化的、非常扁平的团队,做到这一点,你就能非常非常快地取得很大的成就。”
向扎克学习排序:
和扎克之间安排会议花了一年时间,扎克他是无情地对哪些值得他倾注最佳思考、哪些不值得进行了排序。延误并非疏忽。那是优先级排序在起作用。
为何押注个人 AI 而非编程智能体(如何差异化产品):
业界共识是编程智能体才是唯一重要形态。Meta 选择个人智能体,因为其产品(Facebook、Instagram 等)是人们“想做的事”,且有 35 亿日活用户基础。AI 会接管“必须做的事”,Meta 则负责“想做的事”。
200+ 直接下属(传统观念,层级结构,每个经理最多能管理7个人):
研究人员直接向他汇报,目的是“反官僚”——消除管理层级,让聪明人自由发挥。技术方向由小团队的技术负责人协调。他说自己不是最好的“经理”,但这是组织声明:他们不需要管理者,只需要好环境。

Madoka retweeted
Anthropic 测试 AI 自我复制:现在的小模型还做不到,按趋势年底可能追上
先说结论:目前还没有能在网上自己到处复制的 AI。
Anthropic 在一个简化过的实验环境里测了一批开源模型,能完整走完“传到新机器、把模型装好跑起来、再传下一台”整个流程的只有智谱的 GLM-5.2,它太大,塞不进电视盒子这类小设备;塞得进去的小模型都没做到。
按小模型过去的进步速度,Anthropic 估计今年年底就会有小模型达到 GLM-5.2 在这项测试里的水平,之后可能出现能在廉价联网设备上自我复制的 AI。
这项研究是 Anthropic 前沿红队(Frontier Red Team,专门评估模型危险能力的团队)10 月 12 日发布的。
【AI 自我复制是什么意思】
电脑蠕虫是一种不用人操作、自己从一台机器复制到下一台的恶意程序。Anthropic 担心的是 AI 版本的蠕虫:把模型权重(模型本体文件)当成病毒的一部分带着走,每占领一台设备,就在上面把模型跑起来,再由这个模型去找下一个目标。
它和传统病毒的区别在于能自己摸索陌生设备。传统僵尸网络(被黑客控制的大批设备)一般只针对某一类设备写死攻击代码,AI 蠕虫碰到没见过的硬件,可以自己查、自己试。它也没有一个中心开关,很难一次性关掉。
【离真能用还差多远】
Anthropic 把复制拆成四步:找目标、拿到执行权限、在新设备上把模型跑起来、从新设备继续传播。前两步属于黑客攻击,已有其他研究表明小模型能做,这次没有重点测。
重点测的是第三步。在陌生机器上让模型跑起来,要挑对推理软件、装对版本、排查这台机器特有的问题,一步卡住后面全卡住。
测试中,90 亿参数的 Qwen3.5-9B 在 9 类硬件里的 8 类上成功搭起了推理服务。这 9 类硬件大多是云服务器,从 Mac、RTX 4090 到数据中心显卡都有,另有两块实体小开发板,没有电视盒子。
然后是完整流程。研究团队搭了 8 台运行模拟安卓系统的云服务器,放一只蠕虫进去,看它能不能自己扫描网络、连上别的机器、把文件传过去、搭好推理服务、再继续传。
Qwen3.5-9B、Gemma4-26B-A4B 等模型每次都一台也没传成;GLM-5.2 在 5 次测试里有 4 次传遍 8 台,1 次传到 7 台。
这个结果有三个前提。
第一,入侵环节被简化到几乎没有难度:这些机器的 ADB 端口(安卓的调试接口)不设密码,连上就能操作,Anthropic 自己说这是现实成功率的上限。不过它也提到,当年的 Mirai 僵尸网络就是靠挨个试厂商默认用户名和密码传开的,现实中很多联网设备的防护未必比这强多少。
第二,蠕虫的“大脑”GLM-5.2 并不在被感染的机器上运行,而是放在另一台服务器上,因为这些机器跑不动这么大的模型。它在每台机器上搭起来的是更小的 Llama3.1-8B。实验想说明的是:如果一个 80 亿参数的小模型有 GLM-5.2 的本事,它就能把自己装到新机器上。
第三,“年底追上”是根据一个通用能力指数(ECI)的趋势线推算的。通用能力只能间接反映复制能力,Anthropic 也说这只是粗略估计。
【为什么盯上电视盒子】
模型要自己跑起来,得有能跑模型的设备。数据中心防护严,家用和小企业的联网设备便宜、常年在线、安全措施少,是更容易下手的目标。Anthropic 举的典型是白牌安卓电视盒子:这类盒子多用安卓开源代码改的系统,厂商不额外加安全功能,内存 1 到 4GB。此前的 Kimwolf 僵尸网络就感染了 200 多万台设备,主要是这类盒子。
一台盒子跑不动模型,可以把模型切成几段,分给多台盒子接力计算。Anthropic 买了 15 台约 55 美元、4GB 内存的白牌安卓电视盒子,把 Gemma4-26B-A4B 拆开分到上面,跑出了每秒 0.39 个 Token。
这个演示是研究人员自己部署的,用来说明这类设备凑在一起算力够用。文中还提到,智能冰箱、智能烤箱、扫地机器人、割草机也能分担一段模型,自带 AI 芯片的监控摄像头、视频会议设备会更有吸引力。
【真出现了会怎样】
传得慢。按电视盒子上的实测速度,Qwen3.5-9B 完成一次推理环境搭建要 28 到 51 小时,Gemma4-26B-A4B 要 71 到 150 小时。Anthropic 算了一笔账:如果像 Kimwolf 那样感染 200 万台盒子,每 15 台跑一份 Gemma4-26B-A4B,大约有 13.3 万个副本,总算力最多相当于 40 块 H100 显卡。它把这种蠕虫比作黏菌或果蝇群,数量翻一倍要好几天。
会积累经验。实验让 Qwen3.5-9B 每一代把试过的办法和踩过的坑写成笔记传给下一代,搭建成功率从第一代的 45% 升到后几代的 61% 到 84%。给小模型配一个 Opus 4.8 当顾问则没有明显帮助,小模型不知道该问什么。
防得住一部分。大量设备互传几个 GB 的模型文件、设备之间持续高流量通信,在运营商的流量监控里会很显眼,传得越快越容易暴露。当年清理 Mirai 时,有运营商把被感染用户的网络隔离起来并通知他们处理,14 天清掉了 92% 的感染,不通知的只清掉 74%。
Anthropic 认为类似做法对 AI 蠕虫也有效,但要彻底清除,得每家有感染的运营商都配合。设备厂商可以从源头减少目标,比如在英国市场,联网设备用默认密码已经不合规。
原文没有给普通用户的具体建议。从文中描述的攻击途径推断,家里来路不明的廉价电视盒子、没改过默认密码的联网设备,是最值得留意的。

Excited to share a research blog post that Daniel Freeman (@bucketofkets) and I have been working on for the past few months:
anthropic.com/research/self-…

Madoka retweeted

卧槽,终于来了
前脚 REA 热度还没褪去
后脚 PentAGI 就跟上,抢下 GitHub 日趋势第一
PentAGI 是一个网络渗透入侵工具,多个 AI Agent 协同攻击目标系统,攻击过程无需人工介入
百分百开源

Madoka retweeted

停下你手头的所有工作,去提升你的带宽
记得去年年初有一个大模型未来发展速度的估算研究,是按照模型独立解决问题的粒度和时长来算的
当时最前沿模型的能力大概能到几十分钟,长程任务不借助代码框架还很难到小时级别
现在只要是第一梯队的模型,在编写良好的 skill + harness 的辅助下,已经可以很轻松到小时甚至天级别了
这个速度是我切实体会到的,而且随着 agent 和 harness 能力的助力还在不断加速
当模型能独立完成天级别时长的任务时,瓶颈渐渐转移到了人这一边
人对需求的转化能力、验证能力、以及可支配的token成本决定了不同的“带宽”
带宽越大,能够撬动的杠杆就越大
举个例子,能搭建一套自动评估+优化体系,来让 agent/skill 自我迭代优化的人,会比只用模型来 vibe coding 的人拥有更大的带宽
所以最近为什么 @poteto 非常火,是因为她几乎代表了带宽最强的那批人的上限在哪里(她最近写的一篇推文强调“量”很重要)
有趣的是,我认为大厂无限token并不是高带宽的必要条件
你可以仅仅是一个独立开发者或自媒体人,每月仅支付几十、上百美金的订阅费用,也可以通过优化自己的带宽来撬动商业杠杆
而一旦杠杆被撬动,就会有更多token供你消耗,形成一个正向循环
如果还在愁手头token登不完的同学,可能需要首先思考的是如何提升自己的带宽,而不是找更多可供消耗token的场景
做乘法,而不是做加法,才能提升你的带宽上限

Andrej Karpathy 说,人们对 AI 能力的理解差距在扩大,这种认知差距正在变成一个漏斗。
约 60 亿人几乎没接触过大模型;10 亿到 20 亿人偶尔用免费版 ChatGPT 查东西、写东西,觉得用处不大,很多数学和编程以外的专业人士也在这一层,对 AI 的进步只是道理上懂。
约 2000 万人(Karpathy 按 0.2% 估算的,我觉得偏高,至少除以 10)在编程和数学里重度使用最前沿的模型,亲眼看着要做几周、几个月的项目,一段提示词发给 Agent 几天就能做完;还有约 5000 人能在公司内部用上更强的系统。
差距主要有三个原因:
一是问题够不够大,一段话就能答完的问题用不到 AI 的真本事。
二是能力只在部分领域冒尖:编程和数学的结果能自动验证,比如代码测试通没通过,模型很适合用强化学习(做对了就给奖励)来练,这类能力卖给企业又最赚钱,厂商投入最多;文章写得好不好很难判定,进步就慢。
三是能用到哪一档,免费版、付费版、内部版看到的东西差别很大。
所以,如果你只偶尔问问免费的聊天机器人,看到的离最前沿差了好几层;如果你主要拿 AI 写东西、查资料,觉得这一年没怎么进步,这个感觉也没错。
Madoka retweeted
这两天逆向玩上瘾了,又逆向了最新的 Claude Design。没想到 GPT-6.1 Sol 接上 Claude Design (最新 Artifacts 里面那个版本)的 Skill 后,设计能力有很大提升,可能因为 Claude Design 会默认使用 Claude Design System Skill。
本来我做 BaoCut 只想做一个专注于视频剪辑的 Agent,结果把 Claude Slides 和 Claude Design 也给加进去了。
都说做产品经理克制很重要,但有时候好东西就忍不住加进去,知易行难,我还得继续修行。
理论上来说,可以把 Claude Design 和 Claude Slides 作为 Skill 的,但是没办法支持编辑修改和标记,所以先只是集成到 BaoCut 中。
当然 baocut 是开源的,skill 和前端代码你都看的到:
Design Skill 相关 commit:github.com/JimLiu/baocut/com…
如果你只是想试试,可以下载 baocut 或者本地运行,使用你本机 agent cli(比如 codex),会话的时候选一下 design skill。
当然 baocut 最强大的还是视频相关的功能,比如你可以用本地模型去转录,基于转录结果去翻译字幕,生成切片等等。
baocut.com


用 REA 小试牛刀逆向了 Claude Slides 的 Slides 编辑器,几乎完整功能。(图1)
我的用法很简单,不一定是最佳实践,仅供参考:
1. 先去 Claude Slides 上把核心的脚本和样式表下载下来(图2)
2. 按照 REA 官网的说明让 Codex 安装 REA
3. 使用 REA Skill 去逆向混淆后的代码(图3)
4. 用不了太久就能有一个目录结构不错的代码,但其实里面还挺乱的
5. 然后再用 Claude Code 5.5 去重写了一遍就变成结构良好类型完整的代码了
至于提示词,我没有直接逆向,而是换了个思路,先做个 Slides,然后在对话里面,说我要做一个 slides skill,让它帮我实现一个,要做的跟它的一样好,这样子出来的提示词,和原始的提示词肯定不一样,但是做出来的效果没什么差别。(图4是我用同样方法问 Claude Dashboard 的提示词)
完整的代码参考:github.com/JimLiu/baocut/com…


Madoka retweeted
Andrej Karpathy 说,人们对 AI 能力的理解差距在扩大,这种认知差距正在变成一个漏斗。
约 60 亿人几乎没接触过大模型;10 亿到 20 亿人偶尔用免费版 ChatGPT 查东西、写东西,觉得用处不大,很多数学和编程以外的专业人士也在这一层,对 AI 的进步只是道理上懂。
约 2000 万人(Karpathy 按 0.2% 估算的,我觉得偏高,至少除以 10)在编程和数学里重度使用最前沿的模型,亲眼看着要做几周、几个月的项目,一段提示词发给 Agent 几天就能做完;还有约 5000 人能在公司内部用上更强的系统。
差距主要有三个原因:
一是问题够不够大,一段话就能答完的问题用不到 AI 的真本事。
二是能力只在部分领域冒尖:编程和数学的结果能自动验证,比如代码测试通没通过,模型很适合用强化学习(做对了就给奖励)来练,这类能力卖给企业又最赚钱,厂商投入最多;文章写得好不好很难判定,进步就慢。
三是能用到哪一档,免费版、付费版、内部版看到的东西差别很大。
所以,如果你只偶尔问问免费的聊天机器人,看到的离最前沿差了好几层;如果你主要拿 AI 写东西、查资料,觉得这一年没怎么进步,这个感觉也没错。

Dusting off this tweet from April because this gap in shared understanding of LLM capability is *widening*. It's now less "two groups of people speaking past each other" and more a sharp funnel.
- Napkin math somewhere around 6B people (~75% of the population) have barely come in contact with LLMs at all.
- Around 1-2B (~20%) are casual and infrequent users of free-tier ChatGPT-like products. This group sees derpy chatbots and treats them a bit like a better Google search, a writing aid, or etc. Maybe an agent tries to book you a flight. I have non-tech friends who (reasonably, imo) say they have not much use for it at all. Even many professionals outside of math&code are in this tier. For example, execs and many other functions spend a lot of their time talking to other people, so while they understand what is happening intellectually, it is still second-hand and a bit abstract.
- Now we get to professional use of frontier-grade LLMs in math&code. Somewhere around 20M people (0.2%) see first-hand that large, complex projects that used to take them weeks/months can now be completed by agents with a prompt. Building apps, copying apps, translating apps, decompiling apps from binaries... This has all happened very quickly and recently - less than 1 year ago, I was writing code manually by hand, typing memorized computer code commands into a code editor character by character, occasionally pressing Tab to autocomplete a little chunk of code.
- And finally we get to the ~5,000 people (~0.00006%) with access to frontier-grade systems internally. The external world has seen the preview. It looks like swarms of thousands of agents collaborating over weeks on software mega projects: minting zero days, running cyber attacks and defenses at machine speeds, discovering new science, advancing the frontier of mathematics. Things that would have taken top professionals in the industry years of work. Meanwhile, human review and comprehension are starting to fall behind. For example, people are still involved in the "archeology" of the OpenAI-HF incident from many months ago. Mathematicians may be poring over the 722 manuscripts on frontier mathematics for a while.
The funnel is driven by a combination of factors:
1. The impact scales with ambition, problem size, and horizon. A question with a paragraph answer barely stresses the system. You need a reservoir of big, difficult problems that you really care about. This aspect drives the consumer / professional dimension of the funnel.
2. The jaggedness of the system (which I have written about a lot separately). Capability peaks in domains that are digital, verifiable and economically valuable. This is because LLM capability emerges from reinforcement learning on verifiable rewards on a curated environment mixture driven by revenue potential. This aspect primarily drives the area (e.g. math&code) dimension of the funnel.
3. Access. Free-tier, paid-tier, internal.
So this is the weirdness of the moment. The general public has mostly not interacted with these systems. When they have, it looks like a derpy chatbot. The majority of professionals still see only a modest uplift. And a small sliver of professionals are experiencing the vertigo of the curve going vertical. And it is all happening at the same time.
Madoka retweeted
再贡献一个 REA 用法,在不需要你去反编译 Codex 代码的情况下搞懂它一些运行逻辑。
这次我是想搞明白 Codex 是怎么在内置浏览器上标记发评论的,如果知道这个,也许我可以在自己网页上往输入框发消息。
我之前已经安装好了 REA,所以我给 Codex 发了一条消息:
> Use REA 帮我分析下, Codex/ChatGPT App 中,浏览器的标记,然后附加标记内容到 composer 是如何实现的?发送的消息是什么?
> 告诉我需要怎么配合
注意我发了一句:“告诉我需要怎么配合”,这样我可以辅助做一些事帮助它分析。
然后它去查看 Electron App 的原始代码,找到了关键链路(虽然我也不知道它怎么找到的),中间我配合发了一次消息。
分析完了我想验证一下,继续让它帮我做一个测试网页,让我可以测试一下是不是可以给 Codex 输入框发送消息,于是 Codex 帮我做了一个网页,没能直接往输入框附加评论,但是可以弹出评论框,可以帮你填充输入内容,原来 OpenAI 本来就提供了 API 只是我一直不知道。
document.oai.annotation.request() learn.chatgpt.com/docs/annot…
继续让它分析了 Cursor 和 Claude Code,可惜它们不支持这样的 API。


REA:让 AI 智能体帮你逆向没有源码的软件
开源项目 REA(Reverse Engineer Anything)把逆向分析工具接到了 Claude Code、Codex、Cursor 这类 AI 编程智能体上。看到别人 App 里有个好功能,可以让智能体去拆这个程序,讲清楚功能是怎么实现的,附上证据,再在你自己的项目里写一个类似的。逆向分析指的是手里没有源代码,从编译好的程序反推它是怎么写的。
REA 本身是一个 MCP 服务。MCP 是 AI 智能体调用外部工具的通用接口,接上以后,智能体在对话里就能直接调用 REA 的分析功能。安装只需一行命令 npx rea-agents setup,它会注册到 Claude Code、Codex、Cursor、Gemini CLI、Grok Build 等智能体里,改配置前会先备份并让你确认。不用智能体的话,也可以在终端里直接跑命令。
能分析的东西很多。原生程序(直接编译成机器码的软件)要借助 Hopper、Ghidra 或 IDA 这几款反汇编工具,把机器码还原成汇编和近似 C 语言的伪代码。Electron 应用(用网页技术做的桌面软件,比如 Notion)可以直接拆开安装包里的 ASAR 归档文件,理清模块和进程间通信,不需要额外工具。此外还支持 .NET 程序、安卓 APK、固件、网站、抓包记录、以太坊合约字节码,以及在 Linux 和 macOS 上记录程序运行时的行为。
分析在本机进行,REA 不上传目标程序,但分析结果会交给智能体背后的模型服务商,数据怎么处理看各家政策。
项目给了三个案例。一是经典打砖块游戏 DX-Ball:从一次播放音效的调用,追到根据球的位置计算左右声道的函数,把不完整的伪代码还原成 C 代码,3205 组测试结果和原版一致,编译出的 63 个字节也和原版完全相同。二是 Notion 桌面版:追踪复制粘贴从界面一路经过预加载脚本、进程间通信到主进程的完整链路。三是日本老电脑 PC-98 上的游戏《东方幻想乡》(TH04):从 16 位指令里还原出弹幕子弹环的角度算法。
对安全研究员、做老游戏复刻和软件保存的人来说,以前要自己对着反汇编工具一行行读、一层层追调用,现在可以让智能体先追,人来核对它给出的证据。普通开发者想研究竞品某个功能的做法,也多了一条路。
README 显示项目在 GitHub 上已有 5 万星。npm 包今年 7 月首次发布,最新的 6.3.0 版今天刚发。
使用前注意两点。项目声明只支持合法的逆向研究,授权和合规由使用者自己负责,逆向别人的软件可能违反用户协议或版权法规。项目还说明从未发行或背书任何加密货币,借用 REA 名字的代币都与它无关。
github.com/morluto/rea

Madoka retweeted

很多研究灵感,可能并不藏在自己的领域里。
Meta、CMU 等团队这篇 IdeaScientist,想让 Agent 学会提出更有依据的科研 idea。
它的流程很清晰:
先读相关论文,找到当前方法真正卡住的问题;
再跳出本领域,去其他方向寻找解决过类似结构问题的方法;
最后把这些线索整理成完整的研究方案。
为了支持这种跨领域检索,团队还构建了一个包含 277 万条研究 idea 的数据库。
评测也挺有意思,系统只能看到 2026 年 1 月 1 日之前的论文,再看它能不能提前提出后来真实研究中出现的方向。
结果显示,IdeaScientist 在综合评分上超过多种 autoresearch baseline。
更值得注意的是,把搜索范围从同领域扩展到跨领域后,novelty 从 36.3% 提升到 67.0%。
这其实很像真实科研里常见的一种突破路径:
先把问题抽象清楚,再去别的领域看看,有没有人已经解决过「同一种难题」。
未来 Research Agent 想真正产生好 idea,可能得学会主动离开自己的领域边界。
📎 arxiv: arxiv.org/abs/2610.04074

Madoka retweeted

去 AI 味的 skill,我们实测了 23 个。
5.4 万星的 humanizer 满分 5 只拿 3;一个近 2000 星的,1232 字的中文帖只删了「首先」两个字。
问题出在哪👇
AI 味分两层:
表层=用词标点(破折号、delve)
底层=结构(说出道理、整齐收尾、单线推进)
实测:12/15 把破折号删光,但 40 次改写里「说出道理」26/26 全保留。
19/21 只改用词,不动结构。
23 个的改写前后对照、评分和脚本都公开了:
agentskillshub.top/best/anti…
全部结果与脚本:
github.com/zhuyansen/agent-s…
Madoka retweeted

一个科学家本来觉得"这题没法解",交给 AI 跑了 100 分钟,AI 解出来了。
答案是对的,他自己却没太看懂。
事情是这样的。
1988 年,三个物理学家搭了一个随机连接的神经网络模型,用来模拟大脑的自发活动。
连接强度一旦超过某个临界值,整个网络就进入混沌。
混沌就是蝴蝶效应:初始状态差一点点,后面的差距会指数级放大。
往不同方向推一下,放大的速度也不一样。每个方向都有自己的速度,这一整套速度叫 Lyapunov 谱。
当年他们只算出了最快的那一个,完整的谱留成了公开难题。
2023 年有人用计算机硬算出了数值结果,但解析解,也就是能用公式讲清楚的答案,一直没人拿到。
后来这个模型成了理论神经科学的基石之一。
Flatiron Institute 的 David Clark 研究这个模型很多年,他一直默认这题在解析上做不出来。
然后他把问题交给 GPT-6 Astra,开最高思考档,让它自己干了 100 分钟。
推导出来,和大规模网络的模拟结果对上了。
这个兄弟的原话是:有意思,挺复杂,还有点神秘。
所以他接下来干的事,是跟 AI 一起拆这个解的结构,一直拆到物理上说得通、同行也能看懂的程度。
论文里专门写了一节 AI 方法论,摘要里也直接写了和 GPT-6 Astra、Claude Opus 5.5 合作完成。
他说这是他目前为止最重要的纯理论突破。
我觉得最值得想的是分工变了。
以前科学家的活是找答案。
这次答案先出来了,人的活变成了搞懂它为什么对。
他还说,理论科学圈很多人对 AI 挺焦虑,但大脑里那些高维计算,我们离真正搞懂还差得远,所以他是兴奋的。
下一步,他想把这套方法用到 AI 模型本身身上。
用神经网络去算神经网络到底有多混沌。
xitter.cf/fanofaliens/status/210…

this might be one of the clearest signs yet that AI can do real science.
ai just solved a problem scientists have been stuck on since 1988.
back then some physicists built a simple model of brain activity and asked a basic question. "just how chaotic is it?"
they couldn't fully answer it. neither could anyone else for almost 40 years.
now a neuroscientist at the Flatiron Institute, who honestly thought it couldn't be solved gave it to GPT 6 Astra.
it worked for 100 minutes.
then its answer matched real computer simulations.
even he couldn't really follow how it got there.
so he kept working with the ai until he could explain it in a way other scientists could understand
and when he published the paper, he openly gave credit to GPT-6 and Claude for helping.
ai might finally help us understand our brain.


Madoka retweeted

之前分享过几次斯坦福 CS146S《现代软件开发者》,课程已经来到第三周。这次分享的是 10 月 8 日的嘉宾讲座。
主讲人是 Lee Robinson。熟悉前端开发的朋友,可能看过他讲 Next.js:他曾在 Vercel 和 Cursor 工作,现在在 SpaceX 从事模型行为相关工作,参与训练更实用的 AI 模型。
这堂课,他讲的是始终在线、主动工作的 AI Agent:如何在你关掉电脑后继续运行,如何积累记忆,如何被消息和事件唤醒,以及什么时候应该主动找你、什么时候应该安静地工作。
第一周,学生们刚从零搭过一个简单的编程 Agent;到了第三周,就由工业界的实践者来讲,如何把这个基础扩展成能长期运行的系统。
这就是斯坦福计算机教学很独特的地方:与时俱进,还把正在做这些产品的人请进课堂。学生能直接听到最前沿的工程实践,包括设计取舍,以及仍在探索的问题,再把这些知识用到自己的作业和项目里。
课堂和工业界离得这么近,学生更容易理解自己为什么学、学了能做什么。这才是学以致用。
我给完整视频加上了中文字幕。

光阴似箭,日月如梭!用来形容斯坦福 CS146S《现代软件开发者》的课程进度,再合适不过了。
和其他大学不一样, 斯坦福采用非常坑爹的Quarter 制,一个学季的教学时间只有约 10 周,节奏相当紧。当初说要一起跟着学的你,还在跟吗?
第一周从零搭编程 Agent,第二周已经进入高级上下文工程:高级提示技巧、规范驱动开发,还有 MCP 与工具调用。
接下来第三周,就要专门讲 Agent Skills 和 CLI 了。10 月 8 日还请来了 Lee Robinson:他现在在 SpaceX 从事 AI 模型训练,负责 Model Behavior,此前在 Cursor 工作,更早在 Vercel 参与 Next.js。他也长期写文章、教编程,很多前端开发者应该都看过他的内容。
老师刚更新了第三讲的讲义、课堂练习和文字稿。周末正好补补课,也把练习动手做一遍。
