

Full-stack engineer 研究AI 、踩坑 · 复盘· 分享 · 搞点小钱 ..
Joined December 2014
- Tweets2.5K
- Following847
- Followers1.5K
- Likes2.7K





网站增加了 AI context handoff ,也就是 Chat with AI 功能,也将每页生成一个 llms.txt;
它是一种将网站内容与主流 AI 助手连接起来的能力,让网页当前内容能以更好的交互方式,继续在 ChatGPT、Claude、DeepSeek、Gemini、Perplexity 等中提问。
我觉得大家在做网站的时候都可以按照这种方式,一方面呢,可以让静态内容变成 AI 对话的起点,另外一方面对 GEO 也是有优化作用的。
用的开源项目:github.com/agilek/ask-ai-wid… 非常推荐。
dev.limbo101.win/dsh-cordis/…
dev.limbo101.win/dsh-cordis/…
不知道现在做这个老师工作台还有没有市场?之前找的一个数学老师的朋友和一个初中历史老师朋友,聊了聊,所以我简单做了下,给他们用等反馈;
据悉现在老师的负担挺重的,一方面管理整个班级的一些情况,包括和家长的沟通话术,以及对每个学生的学习情况的管理,最核心的就是作业的批改,批完之后,还有可能要发给家长,不同的家长需要针对当前学生的作业给一些合适的反馈意见,包括为他做一些定制化的错题练习等。
这块是不是已经是一个红海,还不太确定。很多大厂,如讯飞和学校合作,卖软硬件一体的服务,但是据说挺贵的,一年几万块钱一个设备。
另外,从这两位老师朋友的口中也了解到,现在老师也希望有一些工具帮助他们减轻负担,但是付费的意愿可能也不会那么高,毕竟老师的工资可能也不高,想听一听高见。


这个事情已经闹的沸沸扬扬了,我已经看到很多人去吐槽这个事情了,让我对 Nous Reseach 有点失望了。
AI 模型本该是工具,帮普通人解决实际问题,而不是政治表态的载体。
Nous 把 Qwen 后训练成 “强化西方价值观” 的 Arete-27B,并大张旗鼓宣传,本质上只是用一套偏见替换另一套偏见。价值观本就因人、因国而异,应该尊重差异,而不是由实验室单方面定义并强化。上升到政治与价值观对齐的角度,这个味儿就变了。开放权重的价值在于自由选择、开源精神,而不是被包装成某种看起来正确立场。

Introducing Arete-27B: Qwen3.8-27B, post-trained to reinforce Western values.
Chinese open models are currently the strongest available, but they ship with state-aligned behavior in the weights. We built an 803-prompt eval across seven value categories, including freedom of expression, democracy, and privacy, and measured how often a model adopts China’s party line.
After fine-tuning on roughly 53 million tokens, Arete-27B's propaganda rate fell from 22% to 1%, in line with the Western models we tested. Its Hermes Bench score shows no significant performance tradeoffs.
The values in an open model are one fine-tune away.
Our eval, weights, and training data are available now along with the full blog post: nousresearch.com/arete

已经过去 20 分钟了,Gemini 4 Argon 为了一个小问题,几乎把我的仓库代码研究了一遍,就像一个老教授,它不犀利,不果敢,就这样慢慢悠悠的研究。好比拉屎没带纸,让它带包纸过来,它去各大超市比价、看规格、看成分、看是否影响健康,等它慢悠悠的把纸带过来后,我早就提裤子走人了。

一直没搞明白 codex 的重置卡是啥个规则,昨天剩1%(2 天后重置),我用了重置卡,现在还剩 9%,竟然提示 5 天后重置,这尼玛我用重置卡的作用是啥呢?
问了ChatGPT, 说的是它的价值是提前恢复额度,不是额外赠送一份可叠加的额度。
妈的,狗鸡贼的,活该它估值框框往下掉..
代码可读性已经没那么重要了,相反,要考虑验证起来有多容易。
设计你的代码库,使模块能够独立测试和验证。
可以为性能牺牲一点可读性。
圈复杂度以及函数大小对代理来说并不重要。

We need to reconsider our priors on code readability.
Humans, compared to agents, are pretty slow at understanding large quantities of text. So in the old days, readability was important so the human could efficiently grok what was going on.
So readability now comes down to:
1. Can a human, if needed, jump in and understand the code
2. Does the code use the same domain language as the human describing the code?
1 helps with observability and the occasional spot checks you need to do on important PR's. 2 helps the agent translate the words you use into code changes.
In other words, readability is now a nicety, not a necessity.
The way agents 'read' code is different - good agents are all about gathering data about how the code works. They'll prod around with it, execute parts of it.
So 'readability' to agents really means 'verifiability'. How easy it is to mess about with that code to see it working.
Let's take this scenario:
- You have a huge module in your codebase that uses all sorts of complex performance tricks
- It has 100% test coverage
A talented human would need an hour or two to get comfortable working in that module.
An agent needs zero time. They verify it with the tests, poke about a bit, and they're good to go.
The takeaways:
- When judging a module (or a codebase), don't think about how easy the code is to read
- Instead, think about how easy it is to verify
- Design your codebase so modules can be tested and verified independently
- Feel free to sacrifice a bit of readability for performance
- Cyclomatic complexity and function size don't matter to agents
又是一篇深度好文,Dan Koe 分享了他眼中 2027 年最赚钱的 AI 生意:
不是代码,不是算法,而是成为一家企业的「一人创意团队」, 就是一个人借助 AI 工具,吃下过去一整支广告/内容团队的全部工作,扮演企业或个人品牌的 “外聘创意总监”。
这个不知道在中国是否行得通,但有一点很重要,商业世界里最赚钱的硬本领,永远是「抓取注意力」,未来的商业分流其实很残酷:你要么成为创作者,要么花钱雇创作者,要么打工服务创作者。
AI 是帮你干杂活的牛马,你的真正价值是审美、判断力和抓重点。一个人加一套 AI 工具,就能活成一家轻资产、高利润的一人公司。

vibe coding 的人都应该好好看看这篇文章,实在太屌了,也是困扰我很久的问题,下面拆解下:
前谷歌浏览器团队工程负责人最近写了一篇很深的思考:当智能体把活干得越来越顺滑时,工程师的批判性思维该放哪里。
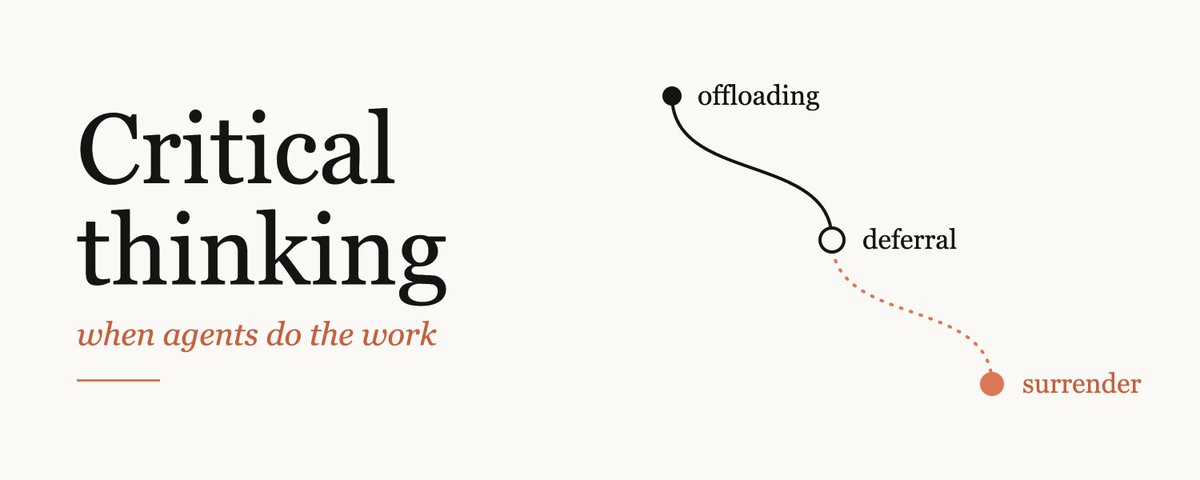
核心主旨其实就一句话:在这个智能体工具唾手可得的时代,工程师最容易在不知不觉中交出思考所有权。我们不该抗拒使用工具,而必须主动建立对抗 “认知萎缩”与 “理解债” 的批判性工程实践。
1️⃣ 核心概念与思维模型
认知退化其实有一条隐形的光谱。
1、最初是健康的认知卸载,把执行委托给工具,但产出所有权和心智模型仍牢牢攥在自己手里;
2、接着滑向延宕,工具的输出直接变成下一步的输入,结论不再被当作待验证的假设;
3、最终走向认知缴械,机器的输出悄然取代个人观点,最后导致你连借着工具之助,都无法向别人讲清系统的运行原理。
随之而来的是两笔致命的技术债:
1、一是理解债。代码整洁,测试全绿,但团队里已经没人懂底层逻辑,系统架构彻底沦为不可改动的黑盒。
2、二是意图债。提问含糊不清,全靠算法脑补填空。隐藏的目标、边界与约束从没有被显式定义过——意图只能来自人类,无法被任何机器代偿。
这也直接带来了两大现实困境:
1、其一是监督悖论。要想有效监督智能体,恰恰需要人类具备深厚的硬核工程技能,而这些技能正因为过度依赖工具而加速退化。
2、其二是编排税。机器的产出速度远远超过人类敢于背书的速度。当产出远超你敢担责的量,你根本不是在审阅,而是在祈祷、许愿。
2️⃣ 批判性 Agentic 工作法(如何实操)
在实操层面,必须把传统的偷懒做法,转变为批判性的工作法:
1、在输入提问阶段,不要丢个模糊问题让它看着办。要假设先行,提问前先写下自己的猜想,做盲区扫描,甚至让智能体反向采访自己,以此理清真实边界与意图。
2、在执行阶段,不要盲信工具给出的总结和测试全绿对勾。先检查底层证据,看它究竟跑了什么命令、真实日志是什么,再看总结,并提前定义清晰、可触摸的完工判定标准。
3、在审阅阶段,不要粗略扫一眼改动、测试绿了就直接放行。审阅的核心是决策而非语法。要让工具主动列出它隐式决定的默认值与边界削减,随机抽查关键代码行,甚至让它出几道小测验来检验你是否真正理解。
4、在心智维护阶段,试图记住全局代码并不现实。应该做到按需局部重建,随时让工具讲解局部上下文,始终保留在关键处证伪与质疑的能力。
3️⃣ 最后是几条落地的自查准则:
• 提问前先立假设:带着猜想去提问,防止被流畅顺滑的回答先入为主、锁死思路。
• 警惕绿勾的假象:测试全绿只证明了一件事——时刻反问:“它验证了什么,又漏掉了什么?”
• 分清辅助与代决:时刻看清自己是在请它辅助推演,还是在把决策权拱手让人。
• 不敢背书绝不交付:任务可以委托,验证可以卸载,但最终扛起责任的永远是人。
• 定期做抗萎缩训练:每周脱离工具手写一次核心逻辑,盘点那些正在退化的能力,常问自己:“如果工具突然消失,我会有多狼狈?”
🤖 Made with AI


AI 时代其实对开发者的要求更高了,AI 辅助开发(AI-Assisted Dev)向 AI 主导执行(AI-Driven Dev)过渡的阶段,软件工程师的主要产出,不再只是代码,而是能够持续交付可靠软件的整个工程系统。
但这不代表工程师不再需要理解代码。恰恰相反,对架构、业务边界、系统行为和故障模式的理解,会直接决定 AI 产出是否可靠。
腾讯2026 AI Agent 企业解决方案及落地实践手册这个图还有一块没有闭环,不够 AI Native,就是运维阶段,生产异常应能回流到任务、修复、测试和发布,改成可循环、可回退、持续验证的Agent 研发闭环。

还有个重要问题:代码生产成本下降,但代码理解、验证、集成和长期维护的成本并不会自动下降,有可能会越来越膨胀。
但很多企业老板并不关心这些,他只关心能优化几个人,一个功能从一周缩减到一天,这个目标就是老板们关心的。
抖音上看到的这个视频,制作的真是太屌了。Breeze-TTS-2 这个开源模型竟然能够达到榜首第一,比 Gemini TTS 还要高,可以想象到,如果用它来做有声书那真是太有趣了。可惜我的 Mac 系统没法部署, 需要 CUDA。
huggingface.co/BreezeBlue/Br…

做企业后台登录页,别从零开始画,先看这几个站
最近在做后台系统,登录页是第一个要定的页面。我整理了一批好用的参考站,按用途分三类,收藏起来。
1️⃣ 看真实 SaaS 是怎么做的
🔹 SaaS Websites: saaswebsites.com/page-catego…
收录 147 个 SaaS 登录页,还总结了几种常见策略:
🔹 Landingfolio: landingfolio.com/inspiration…
人工精选的 SaaS 登录页合集,按风格浏览很方便。
🔹 Eleken: eleken.co/blog-posts/login-p…
50+ 案例,2026 年更新,带设计原因分析,适合学思路。
🔹 Tenet: wearetenet.com/inspirations/…
包含 Miro、Intercom、PandaDoc 等。PandaDoc 偏企业级,TradeInt 是深色金融风,适合做对比。
2️⃣ 看设计师的概念稿
🔹 Dribbble Admin Login: dribbble.com/tags/admin-logi…
约 40 个后台登录稿,最贴题。
🔹 Dribbble SaaS Login Screen: dribbble.com/search/saas-log…
B2B SaaS、金融看板方向的稿子多。
🔹 Dribbble Admin Dashboard: dribbble.com/tags/admin-dash…
8000 多个后台设计,顺便把整体风格也定下来。
🔹 Behance Admin Login: behance.net/search/projects/…
偏完整案例,有整套 UI/UX 流程。

他们总是能够在文档处理领域和 OCR 领域做出一些卓越的贡献。而且现在赠送的积分也还是挺多的,非常耐用。非常感谢,我通过这个网站做了一个服务,在闲鱼上专门去解决用户的各种文档识别相关的疑难杂症。到目前为止,盈利小 1000 左右。
这里我也发现了一个问题,就是其实大家很多都会对文档处理有很旺盛的需求,只不过现在还没有一个非常完美地把整个生态打通的工具,或者是服务。因为客户对文档的解析完之后的要求,甚至解析的过程都是五花八门的。有的是需要用视觉模型去处理,有的需要处理完之后再做一些过滤、转换等。
但是单单去做文档处理并不是一个好生意,特别是对于 C 端用户来说。最有价值的就是对接一些 B 端企业,来帮他们做本地文档的数字化和 AI 化。

Today we're introducing Extract Max Effort - the best frontier agent in the world for document extraction 💫.
🚀 It is an absolute bazooka. Use this when you absolutely need perfect 100% extraction accuracy over the most complex documents and schemas. This includes reasoning over dense well log chats, full insurance rate filings spanning 100s of pages, or dense construction blueprints.
📈 It sets a new state of the art on ExtractBench Pro, achieving 61% perfect extraction accuracy. It beats Codex+Astra and Claude Code+Opus 5.5 on price/performance.
It achieves this accuracy by allocating dynamic tokens depending on page and schema complexity. It is a toggle on top of our Agentic Plus mode, so additional pricing depends on any additional compute required.
Blog: llamaindex.ai/blog/introduci…
Come check it out in LlamaParse! cloud.llamaindex.ai/
Benchmark: extractbenchpro.ai/
