

著書『データ分析力を高める ビジネスパーソンのためのSQL入門』 https://xitter.cf/t.co/3Nj9rSawJX | 外資系コンサルシニアマネージャー ◀︎ ebookjapanでデータサイエンス組織の部長 ◀︎ Yahoo! JAPANでWebエンジニア | 複業でマーケティング・データ分析・コーチングなど
Joined July 2010
- Tweets16.4K
- Following491
- Followers3.6K
- Likes3.5K




Pinned Tweet
ついに本日SQLの入門書が発売になりました!
自分自身が過去にSQL勉強会として実施した内容を体系化して1冊の本にまとめました。
240ページとコンパクトにまとめたので、
SQLを学んでデータ分析力を高めたい人が読む最初の1冊としておすすめです!
amazon.co.jp/dp/4297134438/

オントロジーによって「データ」ではなく「意思決定」をモデル化する動きが注目。Palantirは概念(名詞)だけでなくロジック・アクション(動詞)・権限まで一体で扱い、AIが読むだけでなく承認や更新まで安全に実行できる土台として設計している。
product.hiway.app/blog/ontol…

「オントロジーとは何か」の整理。オントロジーをAIエージェントにとっての3つの役割に整理しているのが分かりやすい。
zenn.dev/komlock_lab/article…
①認識:AIエージェントが世界を見るための地図
②行動:権限と承認フロー込みのAPIカタログ
③組織:AIと人間が共通言語で動くための「業務OS」

オントロジーの定義から効果の実証データを整理した記事。
fd-x.co.jp/insights/41-what-…
・同じデータ/LLMでもSQL直接だと正答率16.7%、ナレッジグラフ化で54.2%、オントロジーで72%まで伸びる
・2026年の最新モデルでも、セマンティックレイヤー経由は98〜100%、SQLを書かせる方式は84〜90%と差が残る

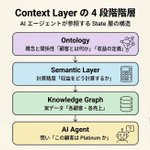
Salesforceによるオントロジーの解説。「データはつながっても意味はつながらない」という一言が分かりやすい。タクソノミーは「分類」、ナレッジグラフは「実データの地図」、オントロジーは「意味と関係の設計図」という整理も分かりやすい。
salesforce.com/jp/blog/jp-wh…

セマンティックWebがなぜ推論できる仕組みにならなかったかを分析した論文。事実を「主語・述語・目的語」だけで表すと、いつ・どの条件で・どの根拠で成り立つかが抜け落ちてしまうという指摘は、企業のオントロジー設計でもそのまま当てはまる気がする
arxiv.org/abs/2609.14121

A/Bテストで「有意差が出るまで待つ」ことの代償を論じた記事。問いを「統計的に有意か」から「どの選択肢が最悪の機会損失を最小化するか」に変え、推定効果が導入コストを上回れば実施するというAMMRの考え方がとても参考になる。
dhbr.diamond.jp/articles/-/1…

ベンダーのFDEが作ったAIエージェントの70%は2028年までに放棄されると予測。技術的に失敗する前に構造的に失敗するという指摘がとても鋭い。FDEが去った後も現場で使い続けられるよう、知識の移転と出口戦略を最初から設計しておくことが鍵だと感じる。
publickey1.jp/blog/26/fdeai7…

ナレッジグラフを数十件作ってきたオントロジストが「成功より失敗の方が多い」と認めた上で原因を整理した記事。技術より進め方の問題が大きいという指摘が参考になる。
ontologist.substack.com/p/wh…
・上位オントロジーから深い継承を先に作ると、必要なクラスが後から分かって破綻する
・全社1つの巨大なグラフより、小さなグラフを分散させてつなぐ方がうまくいく
・グラフをLLMのコンテキストに詰め込むとトークンが膨らむので、必要な分を問い合わせさせる
AnthropicがClaudeの新機能「Claude Dashboards」をベータ公開。SnowflakeやDatabricks、BigQueryなどに接続し、自然言語の指示だけでダッシュボードを自動生成できる。SQLを書かなくても分析できる時代になったけど、その数字が正しいかを確かめることが重要になる。
news.mynavi.jp/techplus/arti…

Databricks GenieでECのKPIを聞いたところ、5問中正解はゼロ。キャンセルを除外するルールや割引額の定義をSQLで登録していくと、全問正解になった。「もっともらしい間違い」を消すのはモデルではなく業務ルールの定義だということがよくわかる好事例。
tech.every.tv/entry/2026/04/…

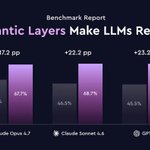
3つのLLMでセマンティックレイヤーの効果を検証したベンチマーク。指標の意味や判断ルールを書いたMarkdownを渡すだけでどのモデルも正答率が17〜23ポイント向上。しかもLLMモデル間での差はない。AI分析の品質の上限を決めるのはデータモデル側という結論がとても重要。
cube.dev/blog/why-semantic-l…

Anthropicのデータサイエンスチームが社内分析にClaudeを使った知見。問題はクエリを書くことではなくどれが正しいクエリかを見極めること。
atscale.com/blog/anthropic-a…
・過去のSQLやダッシュボードを大量に読ませても精度向上は1%未満。精度に効くのはトレーニングデータを増やすことではなく構造
・意味レイヤーではなく指標の定義や使うテーブル・フィルタをスキルファイルに書く「意味スキル」を構築
・正答率は21%から95%へ改善し、一部の領域では約99%
・セマンティックレイヤー経由にしたある大手銀行の事例では計算コストを最大2万1000分の1に削減

App OrchidがオントロジーでText-to-SQLの精度を底上げ。素の状態でも高いが、最後の数%を埋めるのが意味の定義という点が参考になる。
・Spiderベンチマークでゼロショット94.6%
・オントロジー付与で99.8%
・ファインチューニングと違い、スキーマ変更に追従しやすい構造
apporchid.com/blog/how-app-o…

LLMの質問応答精度向上例。SQL直接だと16.7%、オントロジーで定義したナレッジグラフ経由だと54.2%まで上がった。さらにオントロジーでクエリの誤りを検知して修正させると72.55%に到達。LLMの性能より、業務の意味をどう渡すかが精度を決めるという議論としても参考になる。
arxiv.org/html/2311.07509v1
なぜ今オントロジーなのかを3つの力から整理した記事。アリストテレスから2400年の歴史を踏まえた上で現在地を示しているのが参考になる。
note.com/fumiyuki_ota/n/nb0b…
①ハルシネーション:LLMに業務の概念と関係の地図を渡す必要が出てきた
②規制:EUのデジタル製品パスポートが機械可読な意味の標準化を義務化
③地政学:取引先が変わるたびに発生する意味の擦り合わせコストが膨らんでいる
オントロジーの意味とAIとの関係、データ活用までを解説した記事。ある業務領域の用語や概念の定義と関係性を構造的に整理した枠組み、という定義がわかりやすい。情報量が多いので言葉の定義から入りたいときに向いていて、社内の共通認識を作る目的でも使いやすい。
since2020.jp/media/ontology/

オントロジーの基本を整理した記事。概念と関係を機械が解釈できる形で定義するという核を押さえた上で、なぜAI時代に必要になるのかまで繋げてある。具体のサービス、実装方法など含めて短く読めるので最初の一本として読みやすい気がする。
qiita.com/kurogoma939/items/…

2026年のセマンティックレイヤー最新動向をまとめた記事。各社が標準化に向かい始めたのが大きい。
note.com/ikki_mz/n/nf558876c…
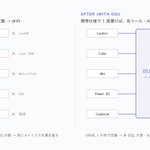
・SnowflakeのSemantic Viewはトップダウンの定義にGolden Queryでボトムアップを足すハイブリッド
・Open Semantic Interchangeの仕様が確定しDatabricksなども参加

AI時代にBIは不要という見方に対して「すみ分けではなく組み合わせ」と語る。生成AIの普及後もBIの利用は93%のユーザーが利用を維持または拡大。生成AIでの分析経験者の85.5%が誤った回答を経験し、必要なスキルのトップが「分析結果の検証・評価」という結果も示唆的。
japan.zdnet.com/article/3525…

オントロジーの基礎から最小構成での実装ステップまで丁寧に解説した記事。概念5〜10個から始めてYAML定義とテーブル5つで組める、という具体性がとても分かりやすい。
note.com/nocode_solutions/n/…
・スキーマとの違いは「システム都合の構造」か「現場の言葉での意味定義」か
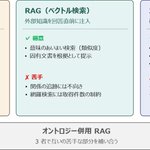
・Microsoftの研究でオントロジー併用RAGは事実の再現率が55%向上、回答の正しさが40%改善
・構築はLLMに草案を作らせ人間が確定する分担が現実的
