

Zhi Lee retweeted

an open model just beat Jev outright on clinical decisions 🔥
pplx-decider v1.1 got 643 of 669 right vs 628 for Jev, at 42% less per decision and about the same speed. and you can download the weights and run it inside the hospital.
System One just went open


pplx-decider-v1.1-27b, our updated open weights multimodal decision model, is now available.
It scores the highest on the new @huggingface Decision Index 0.3 benchmark. pplx-decider-v1.1-27b costs half as much as v1, at $0.02 per million input tokens.
huggingface.co/spaces/multim…

Zhi Lee retweeted

SemiAnalysis 上周发了份《中国AI基础设施热潮》,第一次把中国大厂的算力家底盘清楚了。他们访谈 60 多家公司,追踪 1000 多个数据中心,结论是中国已交付容量 24 GW,全球第二,仅次于美国的 56 GW,后面还有约 20 GW 在建、30 GW 预期建设。
字节 5.3 GW 居首,占全国已交付容量的约五分之一,但绝大部分是租的,华为 1 GW 几乎全自建。阿里 3.9 GW,腾讯 2.4 GW,百度 1.1 GW。
字节是算力大户,始终坚持闭源模型,现金流最强,比腾讯、阿里、百度的收入加起来都要多的多,但因为 AI 的激进投入也几乎把现金流干负了。豆包月活 3.45 亿国内第一,视频模型 Seedance 份额最高,还在训 10T 参数的模型,国内目前最高参数是月之暗面的 2.8T,阿里qwen5 目标 10 万亿参数、DeepSeek 下一代8 万亿参数,minimax 在 10 月会发布 3 万亿参数的 minimax M3 pro。
2026 年 AI 资本开支从年初 1600 亿上调到 2000 亿,一半买芯片。模型领先且算力足够,你就不会开源,OpenAI、Anthropic、字节都选择了相同的路,从租赁、自建算力、研发芯片把产业链利润最大化。
智谱和 DeepSeek作为开源的代表,GLM 和 DeepSeek九成的使用被别人部署,自己只收到一成的钱,根子就在算力不够,就算算力再怎么优化能赚到的钱也不会超过 50 亿美金,智谱当前的 ARR 是 18 亿美金,DeepSeek和月之暗面 Kimi月 10 亿美金,MiniMax8 亿美金。
阿里、腾讯、百度三家 2026 年 Q2 合计资本开支约 200 亿美元,同比翻倍,历史上第一次同时负自由现金流。消费互联网见顶的焦虑,正被全部换成机房和 GPU。


Zhi Lee retweeted

Transformers struggle to generalize to tasks they were not explicitly trained on. Instead, we propose in 2026 that it is the job of the harness to generalize through composition.
We observe a powerful property when training RLMs: for tasks with shared structure that look different, the root model naturally learns the same trajectory, meaning it views the two task trajectories as the same! In other words, the Transformer does not need additional generalization capabilities to transfer capabilities from one task to the other, the harness induces it.
We find that well-designed harnesses form a quotient set over task trajectories, meaning their individual LLM calls can see structurally “similar” tasks as near-identical, token-for-token! Harnesses can effectively generalize for the Transformer during training, without relying on any intrinsic generalization capability from the model.
For example, RLMs can see problems of different lengths as the same: we show that RLMs can train exclusively on short tasks, and fully generalize to similar but unseen tasks 8-32x longer because it produces near identical trajectories for both.
Taking this further, we show that tasks across different domains (e.g. math solutions vs. essay writing) that share a decomposition strategy exhibit the same generalization effect. RLMs can train on the problem of finding which essays belong to the same author and improve performance on finding math problems that share similar solutions.
The full blogpost, experiments, and discussion are in the thread below.

Zhi Lee retweeted

JEV as a judge!
Researchers at Carnegie Mellon University just tested how far JEV can go as a decision-only judge, and where a stronger LLM still needs to take over.
The setup is simple.
JEV takes the evaluation state, the judging instructions, and the allowed outputs, then returns a typed decision with probabilities for each label instead of generating a long rationale first.
The paper compares it against generative LLM judges and reward models across preference, factuality, and answer-adjudication tasks.
On ordinary preference, evidence-grounded factuality, and final-answer adjudication, JEV stayed within roughly 3 percentage points of the strongest judge tested.
The cost difference was much larger.
On the measured panel, JEV came in at about $0.04 per 1,000 judgments with roughly 0.15s median latency.
The more useful result is what happens when you use JEV's confidence as a routing signal.
When JEV is confident, you keep the decision. When it is unsure, you escalate that case to a stronger LLM judge.
With a 0.9 confidence threshold, the pooled cascade escalated about 34% of the judgments and retained 99.6% of GPT-6's accuracy at 47% of its fee.
That gives you a much more practical evaluation pipeline:
Input → JEV → Confidence check → Accept or escalate → Stronger LLM
The paper also shows where this stops working well.
JEV falls further behind on difficult reasoning, coding, and style-adversarial cases where an incorrect answer is written convincingly. So the confidence score is useful for routing, but it should not be treated as proof that the verdict is correct.
I like this because it turns LLM-as-a-judge from a single-model choice into a systems problem.
You do not need the strongest judge for every evaluation. You need a cheap first pass that knows when it should hand the difficult cases over to something stronger.
I've shared the link to the paper in the comments.


Zhi Lee retweeted

I hope the proposals by frontier labs to pace AI research stem from a genuine concern for safety and a recognition of the potential risks posed by future models, rather than a strategic effort to consolidate power and permanently solidify the market dominance of a few top players.
If these efforts are genuine, then oversight must take a more democratic and accountable form, with both national and international components, similar to the Nuclear Regulatory Commission in the US and the International Atomic Energy Agency internationally.
If there is only one organization responsible for safety monitoring, and it happens to be staffed by the same people as the frontier labs, and it is perfectly aligned with them both by incentives and by ideology, then it would be indistinguishable from letting frontier labs self-regulate and self-certify their own safety standards.
Two potential warning signs of regulatory capture to watch out for:
1. Calls to ban open-source AI. Open-source development currently serves as the only real counterweight to the dominance of frontier labs.
2. Attempts to hinder non-frontier research. Models that are one or two generations behind the frontier -- whose level of capability has already been deployed at scale -- are empirically known not to pose safety risks.
As long as we don't see 1 & 2, and we see real international coordination efforts, then I will optimistically believe that the proposals are benevolent.
Zhi Lee retweeted

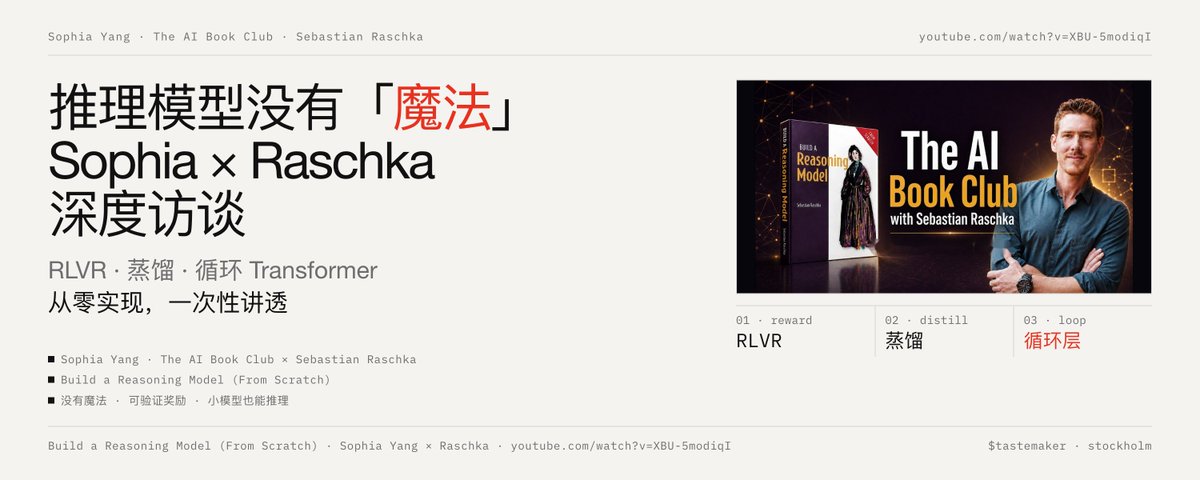
"Reasoning" 只是行业术语,推理模型不是在像人一样思考。
@sophiamyang & @rasbt 在这场 69m 访谈里拆解了推理模型的工程本质:
· RLVR 如何用可验证奖励训练模型
· 蒸馏的伦理边界在哪
· 循环 Transformer 是否真的会隐藏思维链
他们认为:推理模型没有魔法,只有方法。
Zhi Lee retweeted

Will Huawei catch up to Nvidia by 2030? Almost certainly not.
We analyzed Huawei’s chip roadmap and supply chain, from the Ascend 950 to its 3D-stacking bet and domestic HBM supply. Our estimate: Huawei will produce less than 4% of Nvidia's AI compute in 2026. Relying on domestic HBM alone, that share could fall to just 1% by 2028. 🧵

backup

Tailscale 自己出手,做了个反直觉的东西,Tailcat,一句话概括就是:没有 Tailscale 的 Tailscale。
不用注册账号,不用装 VPN,不用开端口,不用 root,也不改你的路由和 DNS。两台机器,发个短 token 过去,直接就连上了,全程 WireGuard 端到端加密。打得通走直连,打不通自动走 DERP 中继,一点不耽误。
连上之后能干嘛?我给你数数:
1️⃣ 两台电脑互传文件
2️⃣ 把本地端口甩出去
3️⃣ 直接 SSH 进去
4️⃣ 当 SOCKS5 代理
5️⃣ 当出口节点
6️⃣ 浏览器里也能传
Go 写的,全程用户态,官方开源。像 netcat,但走的是 Tailscale 的数据面。
🔗 tailscale.github.io/tailcat/

😂

晚点这篇扒机器人行业的文章,太敢写了。
在制造厂,一台机器人伸出爪子,捡起轴承,转身放到塑料盒子里,这个动作人类 2 秒就能完成,机器人却用了 70 秒,而这家机器人公司估值 10 亿。
市面主流的通用人形机器人,平均造价 20 万,折旧时间不到 10 个月,运行 10 天就得返修。
虽然成熟点的仓库机器人,确实能搬货,但只要货物大小或位置出现一点偏差,就会失败。
多数机器人公司,仍未解决稳定性和人工介入频繁等问题,用机器人来投产,普遍会带来负 EV。
目前真正玩得转的商业模式,是机器人公司把机器人卖给数据采集厂,把销售额做出来,数据厂再雇人遥控机器人干活,把操作数据卖回给机器人公司。
机器人公司,相当于用买数据的方式,返还部分购机款。地方政府则出钱、出地支持数据采集厂,因为项目能创造就业、又披着机器人和人工智能的高科技外衣,堆这套资金盘,抬估值,奔上市。
而行业内,基本已经不是白手起家了,多数创业公司,都是连续创业老手,在幕后操盘,然后找一位行业泰斗、资深人物,作为 CEO 站在台前去融资,非常会玩弄投资人的心理。


Zhi Lee retweeted

When language models first started using tools well, I was sympathetic to the narrative that instead of scaling up language models, all we needed was a strong enough "cognitive core", say 1B parameters, and anything else could be done with tool use, like browsing the internet or executing code. I think a lot of people were sympathetic to this argument, and indeed it is pretty hard to come up with a meaningful task that cannot be in principle achieved by a 1B model with adequate access to tools. For example, any esoteric fact that a large language model would know can be, in principle, retrieved from the internet and reasoned over by a 1B language model.
However I now think this is totally wrong for one simple reason: doing tasks quickly and naturally without tool use matters a lot.
The way that I internalized this reason was actually in my personal journey learning badminton this year. In badminton I am very much like a "1B cognitive core". While I can physically do every movement in a badminton shot that my coach teaches me, it requires a lot of work to mentally remember every cue and put it together. In practice I can do a shot almost perfectly, but I struggle to do it across a point and I definitely can't do it consistently in a game. This is obviously different from someone who has practiced a shot ten-thousand times and effortlessly executes it as a natural instinct.
In the same way, language models knowing a fact internally, without tool calls, is meaningful. The first reason is that we obviously care about speed; you'd much rather get an answer immediately than have the model think a long time to be sure of its answer or browse the web. A second reason is that there are some things that are simply best learned via backpropagation over lots of data. If you ask about how people generally think of the Shambhala music festival, you'd rather a large language model give you an aggregate opinion based on all the data on the internet, than get a regurgitation of the first three reviews that show up in a web search. A third reason is that having to do a lot of work to find an answer is not as reliable as already knowing the answer. While this does not have to be true in theory, it is probably true in practice, at least for now. If you have to re-look up facts or redo a mathematical derivation all the time there is a higher chance of mistakes, which can compound in a long-horizon task.
Once you buy that it is valuable to do things parametrically without tool use, then you must buy the argument that a 1B cognitive core is not sufficient. There is an information limit to how much knowledge can be internalized by a 1B model, and we will surely want AI to know more than that. Even 1T probably won't be enough. We will want the AI to know as much about our world as possible, we will want it to be updated with new information, and our expectations of what AI can do for us will continue to grow.
In summary, tool use enables small models to do a lot more, but those who demand the highest quality intelligence will always want larger models. Bitter lesson strikes again.
你见过真正高效的战场,就再也演不来大厂的“剧本杀”。你以为你退役了,其实是你“心死了”。

Zhi Lee retweeted
初创和中型公司的工程高管(CTO、工程负责人、工程 VP ...)正在成批地离开或倦怠
这是 @GergelyOrosz 观察到了问题:
这些职位本来就极难招到人,但好不容易招到的人,入职几个月后又主动离开,而且离开后不是跳槽,而是直接休长假。在薪酬顶端的人主动退出市场,这说明问题不在钱,而在职位本身。
Gergely 想到了这几点原因,一起看看:
第一股力量:AI 把这个职位本身变成了"坏职位"(原因 1、2、4)
· 原因 1 说的是期望值失控:董事会和 CEO 看到"AI 让工程效率提升 10 倍"的叙事后,会把不切实际的目标压给工程负责人——"为什么我们不能用一半的人做两倍的事?"这个职位的本质是承接技术组织与商业期望之间的落差,而 AI 叙事把这个落差撑到了没人能填平的程度。
· 原因 2 更致命:高管入职后有信息优势,能看清公司真实的 AI 战略成色。很多人入职几周就意识到这家公司在 AI 时代根本没有赢的路径,这时最理性的选择就是止损离开。
· 原因 4 是这个循环的证据:你的前任就是因为这些原因走的。职位空缺本身就是一个坏信号——问题是结构性的,换人解决不了。
第二股力量:个人职业生涯的 AI 焦虑(原因 3、6)
· 原因 3 说:这些人意识到自己必须获得"AI-native"的实战经验才能在长期立足,而如果所在公司的环境给不了这种经验,留下来就等于"职业自杀"。这揭示了一个重大转变:以前评估一份工程高管工作看的是薪酬、股权、团队规模;现在多了一个硬性维度——这份工作能不能让我积累 AI 时代的领导经验。答案是否的话,钱给够也留不住人。
· 原因 6 是它的推论:选对公司变得空前重要、也空前困难,判断失误的成本被放大了。
第三股力量:外部选项变好了,离开的机会成本变低(原因 5、7、8)
· 原因 5:在纽约、旧金山这样的市场,顶尖的人可以做兼职 CTO ——同时服务几家公司,收入不差、压力小得多、还能横向接触多家公司的 AI 实践。推文最后那句很关键:这些兼职 CTO 收到大量全职邀约,绝大多数都拒绝了。这是市场用脚投票:全职工程高管这个"产品"的性价比,已经被同一批人验证为不划算。
· 原因 7:优秀的工程领导者现在自己创业比以往任何时候都容易——AI 降低了建产品的成本,而他们的履历又足以融到资。所以很多人一边任职一边在业余搭自己的东西。
· 原因 8:本来就已经倦怠的人,发现现在是休息的好时机——反正行业在剧变,歇几个月观察局势反而是理性策略。
把三股力量合起来看,这不是"一批人累了",是 AI 正在重新定价"工程领导力"这个职位:职位的难度被 AI 期望值推高了,职位的吸引力被个人 AI 焦虑削弱了,而职位的替代选项(兼职、创业、休息)都变便宜了。三个变量同时朝一个方向动,于是出现了系统性的人才外流。


Zhi Lee retweeted

杨植麟在 GTC 2026 的一次演讲"How We Scaled Kimi K2.5":月之暗面想把 AI 训练中三个沿用了近十年的基础组件,重新做一遍。优化器 Adam(2014 年)、注意力机制(2017 年)、残差连接(2015 年),三个 Transformer 时代的地基组件,月之暗面各给了一个替代方案,而且全部开源。
但这场演讲讲的不只是 K2.5,而是月之暗面过去一年多的技术路线:开源模型还能从哪里继续变强,又该怎样逼近闭源模型的前沿水平。
杨植麟把答案拆成了三个方向:让每个 Token 更值钱、让更长的上下文真正发挥作用,以及让多个 Agent 同时协作。
此外,他还分享了两个重要进展:视觉训练如何反过来增强文本能力,以及月之暗面刚刚公布的下一代架构 Attention Residue。
【一、数据不够,就让每个 Token 更值钱】
大模型训练正在遇到一个越来越现实的问题:高质量数据快不够用了。
互联网上真正有价值的文本数量有限,模型越做越大,需要的数据越来越多,大家迟早都会撞上“数据墙”。既然高质量数据很难翻倍,月之暗面的思路是:能不能让模型从同样的数据里学到更多?
他们给出的答案是 MuonClip,用它替代已经用了十多年的 Adam 优化器。
MuonClip 基于 Muon 优化器。简单理解,它会在更新模型参数时,尽量让不同方向上的信息保持独立,减少重复和浪费,从而提高训练数据的利用效率。
月之暗面的实验结果是:使用同样数量的数据,MuonClip 的训练效果接近把数据量增加一倍,这不仅意味着训练成本下降,也意味着模型能力的上限可能被推高。
假设手里只有 50 万亿个高质量 Token,如果 Token 利用效率提高一倍,就相当于又多出了 50 万亿 Token。在优质数据越来越稀缺的情况下,这种效率提升比单纯增加算力更重要。
但 Muon 也有一个明显问题:模型扩展到万亿参数后,注意力层里的数值容易失控。
月之暗面在训练中发现,注意力层的最大 logit 会突然飙升到 1000 以上,而正常范围通常只有 50 到 100。一旦数值继续膨胀,训练曲线就会发散,整个训练过程可能直接崩掉。
为了解决这个问题,他们设计了 QK-Clip。它会在模型前向计算时,实时检查每个注意力头的最大 logit。一旦数值超过安全范围,就同步缩放 Q 和 K 的投影,把数值压回来。
这个操作不会改变训练的收敛效果,只负责维持数值稳定。
靠着 QK-Clip,月之暗面成功把 Muon 扩展到了万亿参数规模,并训练了超过 15 万亿 Token,整个过程中没有出现一次 loss spike。
【二、上下文不只是要长,还要真正有用】
第二个方向,是提高模型利用长上下文的能力。
杨植麟展示了 Scaling Law 论文作者 Jared Kaplan 等人曾经做过的一组实验:比较 Transformer 和 LSTM 在不同上下文长度下的预测效果。
LSTM 读到一定长度之后,效果很快就不再提升。继续增加上下文,模型也很难从中获得更多信息。Transformer 则不同。上下文越长,模型对后续内容的预测通常越准确,而且很难看到明显的饱和点。
这个特点在 Agent 时代尤其重要。复杂 Agent 任务可能持续几天甚至几周。模型需要记住之前做过什么、得到过哪些结果、哪些方向已经失败,以及接下来该做什么。如果长上下文不能持续提供有效信息,Agent 的任务链条就很容易断掉。
问题是,标准的全注意力机制成本太高。它的计算量会随着上下文长度平方增长。上下文扩大十倍,注意力计算量可能增加一百倍。到了百万 Token 级别,训练和推理成本都会变得非常高。
月之暗面的解决方案是 Kimi Linear,核心是一种名为 KDA,也就是 Kimi Delta Attention 的线性注意力机制。KDA 的关键,是让模型学会“哪些信息要长期保留,哪些信息可以快速忘掉”。
传统线性注意力通常只有一个全局衰减系数,控制整个模型的记忆速度。这有点像所有内容共用同一个遗忘按钮:要么一起记住,要么一起忘掉。KDA 把一个衰减系数拆成了多个。不同信息通道可以使用不同的遗忘速度:
- 有些通道衰减得很慢,负责保留长距离信息
- 有些通道衰减得很快,及时腾出空间吸收新内容
实际使用时,Kimi Linear 并没有完全抛弃全注意力,而是把线性注意力层和全注意力层按照 3∶1 的比例混合。
杨植麟称,这是第一个在短上下文、长输入和长输出任务上,都能全面超过全注意力的架构。上下文扩展到百万 Token,甚至更长时,它的效率优势会更加明显。
【三、从一个 Agent,变成一支 Agent 团队】
前两个方向都在提升单个模型的能力。第三个方向,则是让多个 Agent 一起工作。月之暗面把这种方式叫作 Agent Swarm,也就是“智能体集群”。
它的组织方式很像一家公司。一个主 Agent 充当 CEO,负责理解目标、拆解任务,并把不同子任务分配给多个子 Agent。子 Agent 可以分别扮演研究员、程序员、数据分析师和事实核查员等角色。任务完成后,主 Agent 再汇总结果。
这样做最大的价值是把串行任务改成并行任务。过去,一个 Agent 可能需要依次搜索资料、阅读文档、分析数据、编写代码、检查事实。现在,这些工作可以交给几十个甚至几百个 Agent 同时完成,从而大幅缩短复杂任务的执行时间。
不过,要让模型真正学会并行协作并不容易。训练 Agent Swarm 时,月之暗面设计了三种奖励:
第一种是“实例化奖励”,鼓励主 Agent 创建更多可以并行执行的子任务,避免它退化回单 Agent 串行工作。
第二种是“完成奖励”,要求子任务必须真正完成,防止模型为了获得实例化奖励,批量创建没有意义的空任务。
第三种是最终结果奖励,用来判断整个任务是否真正解决。
这三种奖励的权重会随着训练过程动态变化。训练前期更重视任务拆解、并行化和子任务完成率,后期则逐渐把重点转向最终结果。
从演示结果看,Agent Swarm 在复杂任务上能明显缩短执行时间。比如:
- 同时下载、阅读几百个信息源并完成研究
- 并行撰写一份上百页文献综述的不同章节
- 同时分析十个不同的数据集
Kimi K2.5 发布时,Agent Swarm 已经支持最多 100 个 Agent 并行工作,整个任务最多可以执行 1500 个步骤。4 月发布的 K2.6 又把并行 Agent 的上限提高到了 300 个。
【四、一个意外收获:练“视觉”,也能让“大脑”变聪明】
K2.5 和前代 K2 之间,一个重要变化是采用了“早期融合”训练。
过去很多开源多模态模型采用的是“后期融合”:先用大量文本训练出一个语言模型,再用相对少量的视觉数据补上看图能力。
例如,先训练 20 万亿个文本 Token,再用大约 2 万亿个多模态 Token 把视觉能力“贴”上去。
K2.5 的做法不同。
它从训练一开始,就把视觉和文本数据混在一起。在 K2 文本基座的基础上,K2.5 又训练了约 15 万亿个混合 Token。
这种方式带来了两个让杨植麟感到兴奋的结果。
第一个发现是:只训练视觉任务,也能提升模型的文本推理能力。
研究团队只让模型完成数数、识别图片和视觉问答等任务,没有加入数学或编程训练。结果模型的文本推理能力也变强了。
换句话说,模型在练习“看”的同时,“想”的能力也得到了提升。
第二个发现则来自相反的方向:如果文本基座足够强,模型甚至不一定需要专门的视觉 SFT 数据。
K2.5 采用了“零视觉 SFT”方案。所有监督微调数据都是纯文本,然后再通过文本与视觉联合的强化学习,让模型获得视觉能力。最终,它在视觉任务上的表现依然接近最先进水平。
杨植麟认为,这种双向迁移来自早期融合。
当文本和视觉被放进同一个表征空间后,一种模态学到的能力,就有机会迁移到另一种模态。这也是 K2.5 能够“看图写代码”的基础。
如果视觉和文本仍然像两个彼此分开的“大脑”,这样的跨模态能力就很难自然出现。
【五、下一步:用注意力机制替代残差连接】
演讲快结束时,杨植麟介绍了月之暗面刚刚发布的一项新研究:Attention Residue,也就是“注意力残差”。这篇论文发布于 3 月 15 日,距离演讲只有两天。
残差连接是现代深度神经网络最重要的基础技术之一。2015 年,何恺明等人提出残差网络,此后残差连接逐渐成为 Transformer 的标准组件。它的基本做法是:每一层不仅处理上一层的结果,还保留一条直接传递信息的通道。这样即使模型很深,信息和梯度也能顺利通过,模型才有可能稳定训练。
杨植麟引用了 Ilya Sutskever 的一个说法:残差连接可以被理解为“旋转了 90 度的 LSTM”——LSTM 在时间维度上传递信息,残差连接则在网络深度上传递信息。
月之暗面顺着这个类比继续往前走了一步。
既然 Transformer 已经用注意力机制替代了 LSTM 在时间维度上的循环结构,那么在深度维度上,是否也能做同样的替换?
Attention Residue 就是这个思路的产物。
标准残差连接主要使用上一层的输出。Attention Residue 则允许当前层查看所有前序层的输出,再通过注意力机制决定:哪些历史信息值得保留,哪些信息可以忽略。
也就是说,模型不再只能被动接收上一层的结果,而是可以主动从整个计算历史中挑选信息。
为了控制计算成本,月之暗面实际采用的是分块版本 Block Attention Residual。它会把模型层分成多个块,比如每 16 层组成一个块。块内继续使用标准残差连接,块与块之间才使用注意力残差。
实验显示,大约 8 个块就能获得大部分收益。
Attention Residue 带来了约 24% 的 Token 效率提升。
按照杨植麟的算法,如果有 50 万亿个高质量 Token,效率提高 24%,就相当于额外增加了 12 万亿个 Token。它在 GPQA、MATH 和 HumanEval 等推理、数学与编程测试上的提升尤其明显。
【三个用了近十年的组件,都还有改进空间】
演讲最后,杨植麟把月之暗面的三个替代方案放在了一起:
- Adam → MuonClip
- Full Attention → Kimi Linear
- Residual Connection → Attention Residue
它们分别对应大模型训练中的三个基础问题:
- 怎样从有限的数据中学到更多
- 怎样更高效地利用超长上下文
- 怎样让深层网络更灵活地传递信息
三个方案都可以相对独立地替换现有组件,也都已经开源。
这些技术能否直接叠加,增益能否简单相乘,目前还没有经过完整验证。但它们至少说明了一件事:很多被认为“已经足够好”的基础组件,可能远没有到达终点。
在优质数据越来越少、训练成本越来越高的情况下,继续堆参数和算力并不是唯一的路。重新设计优化器、注意力机制和残差连接,同样可能带来可观的提升。
这也是杨植麟整场演讲真正想表达的观点。
正如他最后所说:
> “Open models cannot be just open; they have also to be great.”
开源模型不能只是开放,还必须足够强。
注:本视频由 BaoCut.app 翻译

Zhi Lee retweeted
前 OpenAI、Deepmind、ScaleAI、Stanford 研究员 Phil Chen 分享:AI 时代的职业建议
他认为:AI 时代,真正稀缺的不是解题能力,而是找问题的能力、资源分配能力和判断力。
1. 真正有限的资源:时间、关系、声誉
以前人们看重金钱、学历、职位,但作者认为这些正在变得充裕。资本比以前更容易获得。真正稀缺的是:
· 时间:能否把时间花在真正有意义的问题上
· 关系:与优秀的人建立真实、深度的连接
· 声誉:过去在相关领域做出的好成绩被同行认可
他举了自己放弃量化高薪选择 Scale 的例子,多年后 Scale 带来的网络、机会和认知远超现金差异。这个选择反映了一个原则:不要只看短期确定性回报,要看稀缺资源积累。
2. 学会发现问题,而不只是解决问题
Phil 现在是 fully agent-native 公司的创始人,因此他 hiring 的视角很有参考价值。传统技术面试(LeetCode、系统设计)与实际工作表现的关联正在下降,他们更关注候选人:
· 能否快速理解新环境
· 能否识别出值得解决的问题
· 能否在现有约束下执行
未来人才的核心价值是:问题选择 + 资源分配——也就是把时间和 token(算力/智能)投入到最值得的问题上。
他还提到,很多学生因为 AI 能做题而沮丧。但即使在 agent 辅助下,人与人的差距依然巨大,体现在直觉、外部知识、与模型协作的效率。
3. 做问题最雄心勃勃的形式
借用 Sutton 的 "bitter lesson":通用方法 + 规模扩展最终击败手工优化。这个原则也适用于职业选择:
· 选择在做最雄心勃勃版本问题的公司
· 选择能让你站在问题前沿的岗位
AI 降低了普通软件的门槛,随便谁都能搭出一个简单系统。真正的、持久的价值只可能来自对真正困难、真正大问题上的极端专注。
4. 冲刺最后一公里
引用 Alfred Lin 的观点:最后 10% 的工作创造 90% 的价值。在 AI 时代, median output(平均产出)很容易得到—— sloppy prompt 就够了。真正差异化的价值来自:
· 独特视角
· 对细节的关注
· 迭代能力
· 干净架构、可扩展性、创造力、polish
由于 AI 模型迭代快,Phil 建议:当学到足够多后,不如直接用下一代模型重新从零做,而不是在原系统上打补丁。
5. 同时提升 xG 和效率
用足球 "expected goals" 比喻职业生涯:
· xG:创造机会的能力——你身处什么位置、能看到什么机会
· efficiency:把握机会的能力——能否把机会转化为进球
Phil 回顾自己 2023 年拒绝 Anthropic 和 Cursor、2024 年再次拒绝它们而选择 DeepMind/OpenAI 的经历。这些机会本身都是高 xG,但他更看重个人兴趣、文化契合和目标。他认为自己做对了很多,但后悔没有花更多时间收集信息来支持决策。
核心建议:长期来看,xG 和效率都重要。xG 来自声誉和专长;效率来自判断力和数据。选择早期公司,关键看团队和市场,而不是现有产品——好产品往往来自好团队。
6. 研究门槛正在降低
对于想进入研究的人,现在比以前更容易:
· 计算资源更多
· 公开模型和优化榜单提供了实验平台
· Modal 等计算平台给学生提供免费额度
研究本质上是一种心态,不是职位。它需要:
· 好奇心
· 与基础设施对抗的执行力
· 对系统的极端细节理解
· 能把结果讲清楚、争取更多资源
· 你可以不在顶级实验室就做研究。


Zhi Lee retweeted

Mistral AI 创始人 Arthur Mensch 对企业 AI 选型发出严厉警告。在他看来,闭源大模型厂商强制留存数据是个巨大陷阱,企业数据一旦接入就会被厂商看光并学走,从而对企业获得巨大的商业杠杆优势。而且闭源巨头历史上早有利用这些敏感信息跨界直接成为其最成功客户竞争对手的前科。
为了防止被软件巨头困在围墙花园中,他建议企业必须将数据存放在开放系统里;如果供应商拒绝提供完全的数据访问权,企业则应利用 AI 快速迁移出逃。拿到数据后,企业必须精细化管理访问权限,结合刚性规则系统与软性大模型防范员工越权。最关键的是要建立专有的持续训练飞轮,根据交互反馈把业务优势打磨成对手无法复制的专属系统,并通过模型压缩省下高昂的部署成本。
这套涵盖 IT 架构与开发模式的重构非常复杂,企业既要懂人类行为,又要懂梯度下降。为了降低落地门槛,Mistral 提供 Studio 控制台与 Forge 训练平台,并派遣专家手把手帮客户落地,待系统运转后便功成身退。他强调,前沿 AI 固然能加速业务增长,但如果控制开关不握在企业自己手里,这种增长就无法转化为企业自身的红利。

haha

Who benefit from open-source mass adoption?
- Chinese labs of course
- Cloud Incumbents(AWS/GCP/Azure/Oracle..)
- Chips (NVIDIA smiles regardless...)
- Consumer/Prosumer/Enterprise applications startups (think Poke, Cursor, Lovable, Replit, Sierra etc.)
- American neoclouds & Inference providers (Nebius, Firework, vLLM, SGLang, etc.)
- Model gateways, orchestration infra(Vercel, merge, openrouter, etc.)
- Consulting FDE (Accenture, Palantir, etc. "We help you deploy all models and won't sell your data")
...
What else?
Zhi Lee retweeted

Maka 的 Harness 工程让 DeepSeek Flash 的测试集效果接近了 GLM-5.2 的水平
-----------------------------------
maka + DeepSeek Flash V4,terminal-bench sample 打出 0.8 分。
实际接近 0.9——有道题其实做对了,只是"产物污染"没被评分系统算上。
已经快赶上了 GLM 5.2 的评测效果了。
-----------------------------------
terminal-bench sample 是 terminal-bench 完整 84 题集的样本子集,共 10 道编程 Agent 任务。
这次跑下来:
总 token 消耗:6000 万,其中 cache 命中:5850 万(97.5% 命中率)。全程花费:约 4 元 RMB。10 道题,4 块钱,接近满分。
-----------------------------------
这是 DeepSeek Flash 变强了吗?
不是。用的就是 DeepSeek Flash V4,同样的模型。
让分数从 baseline 跳到 0.8 的,是对 agent loop 里 self-check 机制的两轮迭代——借鉴了 Claude Code 的 self-check 实现,加强了模型在完成任务后的自我验证逻辑。
两轮迭代之后,Flash 在 terminal benchmark 上突然"悟道"了。
这说明什么:模型的能力有上限,但 harness 的工程质量能大幅影响模型在特定任务上表现的上限。self-check 不是魔法,只是让模型在"提交答案之前自己先验一遍"。这一步,让 DeepSeek Flash 打出了接近 GLM-5.2 的水平。
-----------------------------------
为什么 97.5% 的 cache 命中率是关键
terminal-bench 是长程任务,每道题要跑几十个 tool call,上下文累积到几百万 token。
maka 的上下文管理在这里发挥了作用:
前缀保持稳定,DeepSeek cache 大量命中
6000 万 token 里,5850 万是 cache token,只有 150 万需要全量计算
所以 10 道难题只花了 4 块钱,而不是几十元
这也是为什么用 maka 跑 DeepSeek Flash 比直接用 reasonix 更经济——maka 把 DeepSeek 的 cache 机制发挥到了极致。
-----------------------------------
下一步目标是跑完整的 84 题 terminal-bench。
把 Flash 搞得这么强,不是模型的功劳,是 harness 工程的功劳。
github.com/maka-agent/maka-a…

Zhi Lee retweeted

桥水基金在 Mira Murati(OpenAI 前 CTO)新公司 Thinking Machines 平台上发的 Technical Report。
拿 Qwen3-235B 做私有化微调,在金融文档筛选和央行报告解读上直接落地。
结果挺硬核:定制模型 Accuracy 直接拉到 84.7%(错误率比最强闭源 GPT-5、Claude 4.8 模型低 29.8%),Inference Cost 暴降 13.8倍。
背后是高敏感数据:
Open-weight 是唯一解:敏感的金融核心数据,机构不可能天天往别人的云端送。国内 Qwen 系列长文本和微调上限足够高,成了华尔街追求 ROI 的完美底座。
Data Engine 是核心壁垒:他们砍掉了外包的脏数据,只拿 Hard Cases 让内部顶尖投资经理(领域专家)二次清洗。用高成本的“专家品味”洗出干净数据,才带高了模型天花板。
训练 Recipe 调优:
交错批处理 (Interleaved Batching):多任务训练按循环顺序交错,Accuracy 提了 12.1%。
CIPOS Loss + 非对称裁剪:换掉标准重要性采样,对策略偏离做非对称约束,又顶上去 10.1%。
优秀教师政策蒸馏 (OPD):每 20 步动态用验证集表现最好的 Checkpoint 当 Teacher,再刷了 3.1% 的点。
通用模型的边际效应在特定高壁垒业务上是在递减的。
最近看到的一个趋势:用“顶级开源底座 + 极致干净的专家数据 + 针对性的微调工程”去卷出高性价比的垂直智能。
@sgl_project @vllm_project 队伍都创办公司那融资是这个趋势标志性的事件

Bridgewater used their unique financial knowledge and partnered with us on @tinkerapi to fine-tune a model that helps their analysts focus on what's important. Experts improving AI that empowers experts.
thinkingmachines.ai/news/lea…

Zhi Lee retweeted
Claude Code 这个宣传视频从 X 的评论上看有点翻车了😂
这个宣传吧,用的数据虽然都很强大的样子:每天 4500 次生产部署,73% 的 PR 由 AI 辅助,Niklas 本人同时开 5 到 10 个 Claude 会话跑在不同的 git worktree 里,2000 万行的 monorepo 里 agent 跑得挺好,做代码迁移加了验证机制后成功率从 25% 拉到了 80%。
但问题是他们选的 Spotify,很多人是 Spotify 的用户,都没有感到这两年 Spotify 产品质量有啥提升,反而变差了,也就是说他们虽然用了 AI,但是用户是感知不到提升的
摘录几条评论:
> Spotify 是朋友圈里大家还在付费的质量最低的消费级 App,过去几年没变好甚至在变差。这类报道只讲部署次数这种无意义指标,不讲用户满意度和真实产品结果,让 AI 和 Claude 看起来像小丑。
> Mitchell Hashimoto(Ghostty 作者、HashiCorp 创始人)
> 最近四周里有三周播客链接发不到 Spotify,播客发布系统和网页播放器接连出问题。一边是每天 4500 次部署,一边是连播客都发不上去,对比太讽刺了。
> Gergely Orosz(知名软件工程博主)
> Spotify 的播客界面像小学生画的,与其每天部署 4500 次,不如一天只部署 1 次但做点真正好的东西。
> ThePrimeagen
评论区大量重复出现的吐槽包括:
- 4500 次部署到底在部署什么?
- App 十年没怎么变过。产品感觉停滞多年。
- 为什么 bug 越来越多?
- 离线播放失效、桌面端卡顿、缓存清不干净。
- 这不叫部署,这叫垃圾代码生产机。
支持的声音也有,但很少,点赞也低。有人对“加 judge 后成功率从 25% 到 80%”这个细节感兴趣,有人觉得大规模 monorepo 下跑 agent 的实践有参考价值。
这次翻车的根源其实很简单:Claude 展示的全是工程侧的数字,部署次数、PR 占比、agent 会话数、成功率提升,但完全没有展示用户侧的价值。产品更好用了吗?Bug 更少了吗?用户体验提升了吗?一个字都没提。
AI 宣传总是在讲效率提升了多少,讲代码产出快了多少,但如果用户感知不到任何变化,甚至觉得产品在变差,那这些数字就成了反面教材:用 AI 生产了更多代码,但产品并没有因此变好。
这其实也是当下整个 AI Agent 面临的一个根本问题:我们到底在用什么来衡量 AI 的价值?如果衡量标准只停留在“写了多少行代码”、“部署了多少次”、“PR 通过率多高”,那只是在衡量生产效率,但用户更关心产品质量。
用户不关心你每天部署多少次,只关心用了 AI 后 App 是不是更好用了,是不是解决用户真实痛点了。

Zhi Lee retweeted

How to keep AI spend flat while token usage grows exponentially: Not with friction and spend alerts. With better defaults, routing, and caching.
Better Defaults (not Usage Caps) – Engineers can choose any model they want, but defaults matter. We’re experimenting with defaulting to open weight models like GLM 5.2 and Kimi 2.7 through our LLM gateway, while still encouraging engineers to choose the right model for the task. 91% of our employees were never hitting their usage caps, so instead of lowering caps and driving up alerts, we're moving to cheaper defaults. Note that code reviews use a diversity of models, so they can check each other's work.
Better Routing – In our custom harnesses, we preprocess prompts and route to the best model for the job, considering cache hits and model pricing. For instance, you may want a frontier model for planning, but not for execution where they can be overkill. Ultimately, humans shouldn't be choosing models - AI can automate this task.
Better Caching – Cache misses are the easiest way to drive your cost up. All of our requests are cache aware, so we’re reusing a warm cache wherever possible. For example, our cache hit rate went from 5% → 60% in LibreChat once properly implemented.
Keep Context Lean – Start fresh sessions when switching tasks. Scope file context narrowly. Disconnect unused tools. Don't just compact. The goal isn't fewer tokens used, it's fewer tokens wasted.
Better Visibility – Our engineers can use as many tokens as they want, from whatever model they want, but we’ve made usage visible – and the more you spend on AI, the more impact we expect.
The goal isn't to suppress usage. It's to build the infrastructure that makes exponential growth sustainable.
Putting this into practice has cut our AI spend nearly in half, while our token usage continues to grow.
