

Chief Research Scientist at Megagon Labs Tokyo Developing GiNZA and vecscan 国立国語研究所 共同研究員・国立情報学研究所 外来研究員 Violist, Japanese noodle gourmet
meguro, tokyo
Joined December 2009
- Tweets3.1K
- Following324
- Followers1.5K
- Likes5.8K



Pinned Tweet
日本語NLPライブラリ GiNZA v5.3 - Grossular Garnet をリリースしました。
Mac OS環境での利用性を向上し、解析速度を最大で5.2倍に向上しました。
動作環境は Python 3.10 以上(3.12を推奨)に変更されました。また古いモデルパッケージはv5.3.0で使用できません。
megagonlabs.github.io/ginza/
hiroshi matsuda retweeted

I recommended desk rejections (DR) for 5 out of 14 submissions, as an #ICLR2027 Area Chair.
Story behind this: I did not use any LLM detection tools, which are unnecessary and should not be used for judging DR. These submissions shared some shockingly basic problems in scientific writing, and therefore each paper only took me about 10 mins (thank God) to identify and report the issues.
1. Undefined jargon. Writing 101: Your paper must be self-contained. If a term isn't standard knowledge in the field, it should be defined.
2. Not analyzing or pretending to analyze results. Experimental analysis is about providing insights, not simply repeating numbers from figures and tables. Bro, I can read the numbers myself.
3. Missing citations. Scientific claims need support, either from existing literature or in-paper empirical evidence. Fewer than three citations in an entire introduction? Either the work is a once-in-a-century masterpiece, or the claims are hallucinated in the paper.
My biggest concern isn't whether these papers were written using LLMs. It's that some submissions fail to meet the most basic standards of scientific communication and therefore should not be reviewed.
Considering this has already wasted some reviewers' time, I strongly recommend introducing AI to flag such papers at an earlier stage.
Thanks for ICLR's policy on desk rejections. Hope this can save some time for the responsible reviewers.


hiroshi matsuda retweeted

来週 EMNLP で現地発表します!興味のある方ぜひポスター発表 (10/25 11:00~) もしくはMegagon Labsのスポンサーブースにお越しください!
PhD学生のインターンを募集していますので、LLM・RAG・Visual Understandingに興味のある方はぜひ声かけてください!
paper: arxiv.org/abs/2604.03403
#EMNLP


hiroshi matsuda retweeted

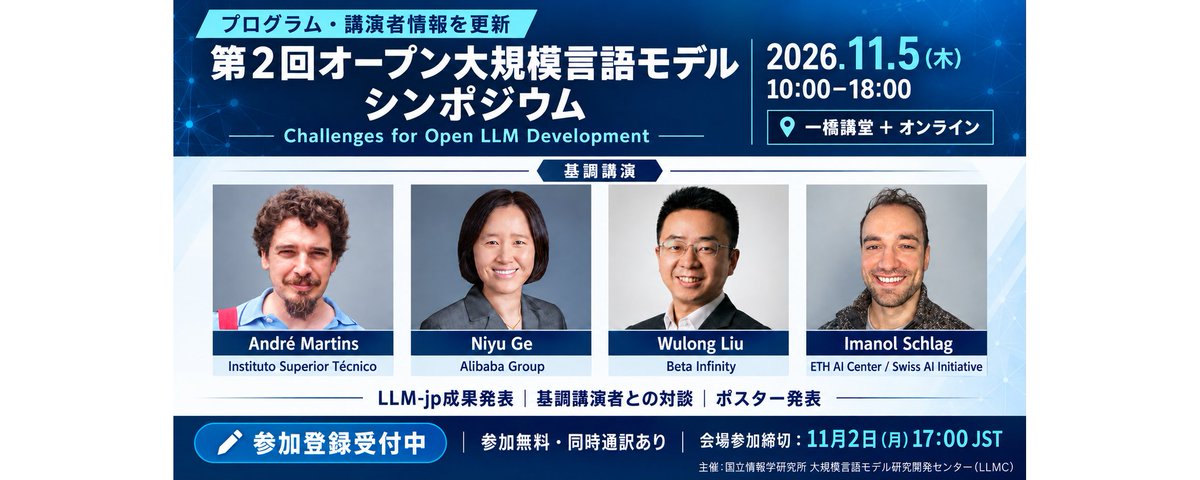
llm-jp-4 の technical report を arxiv で公開しました!
事前学習コーパスの準備から事後学習まで幅広く携わったこともあり,Contribution パートでは名前が最多登場でした!
arxiv.org/abs/2610.19331

hiroshi matsuda retweeted

📢 New preprint from @MegagonLabs 🧵
Confidence estimation for LLM agents is hard: evidence of success spans tool calls, observations, reasoning, and memory. When model internals are inaccessible, reruns are expensive, and training data is scarce, how can we reliably assess whether an agent succeeded and how much to trust its output?
Meet 𝗖𝗼𝗻𝗳𝗶𝗱𝗲𝗻𝗰𝗲 𝗥𝗲𝗮𝘀𝗼𝗻𝗶𝗻𝗴 𝗚𝗿𝗮𝗽𝗵𝘀 (𝗖𝗥𝗚): a training-free, black-box method that turns a single execution trajectory into a structured, evidence-grounded argument for success and an auditable confidence estimate.
Paper: arxiv.org/abs/2610.07948
Code: github.com/megagonlabs/crg_c…
和歌山県の最高峰が護摩壇山から龍神岳に変わったの知らんかった
ja.wikipedia.org/wiki/%E8%AD…


hiroshi matsuda retweeted

2026年10月31日(土)〜11月1日(日) の日程で
SVM勉強会 in 仙台
を開催します!
10月31日は運営会議+懇親会、11月1日はSVM勉強会です。Zoomでのオンライン参加も可能です。
詳細・参加登録はこちらから↓
sites.google.com/view/svm-ca…
#SVM勉強会 #NAIST #松本研 #仙台
hiroshi matsuda retweeted

ヘイブラウンの新曲「途方」弾いてます!
データを頂いた時には既に🎻入れなくていいくらい素晴らしい世界観の作品でした!
弾く内容はお任せ…ということで、2人の静寂の中から溢れ出すクリエイティビティに大変刺激もらい弾きました!
自分としても力作です…是非チェック
nex-tone.link/A00228232


【リリース情報】
2026.10.07(Wed)
「途方」
Digital Release
【Credit】
Lyrics, Vocals:竹岡修平
Music, Guitars, Keys, Bass, Drum Programming, Others:立花陽平
Fiddle, Strings Arrangements : 山田拓斗 @tact_violin
Mix / Mastering:新田康介 @9980knkknk
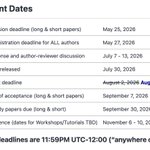
ACL 2027のページを見てみたらARR submission deadlineが1月4日 AoEと出ていた。
2027.aclweb.org/
@aclmeeting からポストはないし、ARRのサイトにもJanuary 2027サイクルの詳細はまだ載っていない。
aclrollingreview.org/dates
あと、京都開催だけどこのまま富士山推しでいくんだろうか。


hiroshi matsuda retweeted

JSAI2027ではオーガナイズドセッションは廃止になり、代わりに、スペシャルトラックというものができるらしい。Science of Scienceに関するトラックを提案してみようかな。
conf.ai-gakkai.or.jp/jsai202…
hiroshi matsuda retweeted

現在のLLMの低精度学習でFlashAttention-3を使った場合、backward計算で数値的な問題が生じる可能性があることが報告されている。
実験では、最初の25Bトークン程度までは正常に学習できていたが、その後、勾配ノルムが1000倍近くまで増大し、最終的な損失も悪化した。
問題の大きかった2層についてattentionのbackward計算だけをFP32に置き換えると、モデル全体の勾配ノルムが2桁以上減少した。つまり、巨大な勾配のかなりの部分が、モデルそのものではなくattention kernelの数値誤差に由来していたことがわかった。
この問題は二つからなる。
1つ目は、FlashAttentionにおけるsoftmaxの計算方法である。FlashAttentionではsoftmax計算時に、scaleとrow maxのsubtractをFMAでまとめて計算する。そのため、本来、最大logitはsoftmax内部で厳密に0になるべきところが、丸め誤差によって0にならない場合がある。このわずかな誤差がbackward時に増幅される。
この問題は、先にrow maxを引いてからscaleするように演算順序を変更することで、その大部分を取り除くことができる。
2つ目の問題は、softmaxのscore gradientが持つ対称性が、丸め誤差によって崩れてしまうことである。
softmaxには、すべてのscoreに同じ定数を加えても出力が変わらない、という対称性がある。
例えばsoftmaxに(s1, s2, s3)というscoreを入力するとき、すべてに同じ定数cを加えて(s1+c, s2+c, s3+c)としても、
p_j = exp(s_j+c) / Σ_l exp(s_l+c)
であり、exp(c)は分子と分母で打ち消し合うため、softmaxの出力は変わらない。
したがって、この「全scoreを一様に動かす方向」に対する勾配は0でなければならず、softmaxのscore gradient g_j は
Σ_j g_j = 0
という性質を厳密に満たす。
しかし実際のFlashAttentionでは、このgradientをBF16にキャストした後に計算を続けるため、丸め誤差によってこの総和がわずかに0からずれてしまう。
すると、本来は消えるはずのkey全体の平均成分がquery gradientに混入する。
特に学習が進みkey normが大きくなると、このわずかな保存則の破れが大きく増幅され、本来のgradientよりも偽のgradientが支配的になることがある。
さらに、この誤ったgradientによってQ/K normが大きくなり、それによって誤差がさらに増幅されるというフィードバックループが生じる。
この問題への対処は比較的単純で、BF16にキャストした後にscore gradientの総和が再び0になるように射影すればよい。論文ではこれをGProjと呼んでいる。
GProjを適用すると、query/key gradientの誤差をほぼFP32 attentionと同程度まで低減できる。
また、QK normalizationを使っているモデルではQ/K normの増大そのものが抑えられるため、今回のような誤差が大きく増幅される状況には入りにくいと考えられる。ただし、QK normalizationが数値誤差そのものを修正するわけではなく、あくまでその増幅を抑える役割であると考えるのが適切である。
コメント
===
今回報告されたような問題は非常に厄介である。学習初期にはほとんど問題が見えず、学習が進んで特定の内部状態に入ったときに徐々に顕在化するためである。
この研究が示しているように、モデル内部にはいくつかの対称性があり、それに対応する保存則がbackward計算にも存在する。
低精度計算によってこうした保存則がわずかに破られると、最初は小さな誤差であっても、学習ダイナミクスとのフィードバックループによって徐々に増幅され、最終的には学習全体を不安定化させる場合がある。
この論文が直接扱っているのはBF16だが、最近ではFP8やFP4など、さらに低精度な数値表現を用いた学習も広がっている。
その際には、どの層やどの演算にどの精度を使うべきかが、現在はかなり実験的に決められている。
今回の研究のように、モデル内部に存在する対称性や、それに対応する保存則を明示的に理解することができれば、単に量子化誤差を小さくするだけでなく、どの誤差は許容でき、どの誤差は構造的に危険なのかを判断できるようになる。
その結果として、より低精度での学習を安全に実現したり、低精度化しながら学習安定性や最終性能を維持・改善したりできる可能性がある。
hiroshi matsuda retweeted

【会誌「自然言語処理」著作権規定・投稿規定改定】
著作権規程と投稿規定が改定されます。投稿期間が2026/12/1のトラックに該当する論文から適用となります。投稿を検討いただいている方はぜひ改定版をご参照ください。
著作権規程:anlp.jp/rules/copyright_rule…
原稿執筆案内:anlp.jp/guide/new-guideline.…
hiroshi matsuda retweeted

1501: Pope Alexander VI criticizes Gutenberg’s printing press safety
“The art of printing can be of great service in so far as it furthers the circulation of useful & tested books; but it can bring about serious evils l..it will, therefore, be necessary to maintain full control”


Pope Leo criticises Nvidia’s Jensen Huang over AI safety ft.trib.al/azwdiGc

hiroshi matsuda retweeted
LLM-jp-4.1 を公開しました!今回は量子化版も同時公開です!
いつも通りモデル学習,評価など諸々担当しています.
学習方法や評価結果について久し振りにテックブログも書いたので是非!
モデル:huggingface.co/collections/l…
テックブログ:llm-jp.nii.ac.jp/blog/llm-jp…


LLM-jp-4シリーズの事後学習を改善した「LLM-jp-4.1」シリーズを公開しました!STEM分野の性能を高め、ツール呼び出しに新たに対応し、回答を簡潔にしています。SFT用とDPO用のデータセットも公開しています。詳細は以下をご参照ください。
【ニュース】
llmc.nii.ac.jp/topics/llm-jp…
【テックブログ】
llm-jp.nii.ac.jp/blog/llm-jp…