

- - - 【有关必回,没回是因为限流了】 - - 老推友,没有任何目标,混吃等死。 - -
Joined March 2010
- Tweets6.3K
- Following4.2K
- Followers3.4K
- Likes3.2K




最值得留意的不是某个榜单谁又涨了几分,而是评测本身也有“保质期”。当 SWE-bench Verified、SWE-bench Pro 逐渐不再出现在新模型发布中,跨代比较就会失去共同刻度;代码领域一个基准平均只有一两年生命周期,说明我们常常把榜单的分数当成了能力的长期坐标。可一旦题目被反复训练、方法被针对性优化,分数上升未必意味着真实任务中的可靠性同步提升。
我更倾向于把模型评估拆成两层:一层保留少量稳定、可复现的锚点,用来观察长期趋势;另一层持续更新任务集,覆盖真实工作流中的新工具、新约束和失败类型。报告里还应同时交代题目来源、污染风险、运行成本、方差和失败案例,而不是只给一个总分。旧基准退出并非坏事,真正的问题是新旧之间缺少重叠期与公开映射。否则每一代模型都像换了一把尺子,数字看起来整齐,结论却很难审计。

while compiling eval data for different models, i realized the benchmarks themselves have evolved over time along with the models.
old benchmarks like swe-bench verified and swe-bench pro have stopped appearing new model releases, making it hard to compare performance of new models against old ones.
i took a look at the evolution of benchmarks in specific domains like coding, and the pattern is clear. the average lifespan of a benchmark is 1-2 years before it gets replaced with new ones.


当然,这类 DCF 的输出仍取决于很多判断:收入归属口径、护城河、增长率、监管与合约风险、治理对回购的控制权,都可能让结果大幅变化。最好的用法不是拿目标价当结论,而是逐项追问数据来源、日期和假设,再做敏感性分析:哪些变量一变,估值就翻转?如果答案主要由尚未兑现的增长或主观的代币捕获机制支撑,那模型也应把这种不确定性摆在数字旁边。

Crypto prompt of the day:
You're valuing a crypto token the way a good equity analyst values a company: from the cash it actually returns to its owners. Most token valuations borrow a P/E from other tokens, which just imports their mispricing. This one derives the multiple from the protocol's own economics, so every number traces back to a source or a stated assumption. I'll use your report to decide what I believe, so being honest about what's known matters more than looking precise.
Start by asking which token I mean (and the chain, if the name is ambiguous). Ask whether I can share DefiLlama screenshots, docs links or recent buyback or unlock news. Tell me it's all optional and you'll research anything I don't send. Cite a source and date for every figure you use. If you can run code, do the maths in code.
How to build the valuation:
**Earnings (E0).** Count only the cash that reaches token holders: DefiLlama's "holders revenue" (buybacks, burns and payouts). Fees mostly go to liquidity providers and builders, so they overstate what holders get. Holder revenue is already the holders' share, so don't apply a payout ratio on top.
- **A year or more of history:** use the last 12 months.
- **30 days to a year:** use the lower of the 90-day and 14-day rates, annualised, then cap it at what the last 14 days of protocol revenue can fund. Young tokens' early numbers usually fade, and buybacks can lag a fall in revenue.
- **Under 30 days:** too little to value.
- **Nothing reaches holders yet:** value it only if a real mechanism exists (a governance proposal, or paused buybacks), and lead with the value if it switched on today.
**Supply.** Count every token with a claim on that cash: circulating, vested but unclaimed, scheduled vesting, and part of the unissued emissions pool, released evenly with 75% out by year 7. How much of the pool depends on discipline:
- if the team holds the largest single allocation and the protocol funds itself from fees, count 60 / 10 / 0% (bear / base / bull);
- otherwise count 100 / 60 / 10%.
Show both, because this one choice can move the value by 15–20%.
**Growth (g1, years 1–7, to the nearest 5%).**
- **Base and bull:** g1 = (reset × (1 + market growth)^6 × share change)^(1/7) − 1.
- Market growth (base) is a third of the category's multi-year growth, capped at ±20%. Bull adds 10 points; bear takes 10 off.
- The reset is 0.6522 × (record 12-month level ÷ current level), at most 1, so a past boom isn't extrapolated.
- The share change is ×1.25 (base) or ×1.5 (bull) for a strong moat, ×1.0 or ×1.25 otherwise.
- **Bear:** the bear market growth.
- **No category history, or a young category that's shrinking:** market growth 0%.
- **Perps exchanges:** total market data isn't free, so use 61% trailing growth, a 0.6522 reset, and an extra factor for the on-chain share of perps rising from 7% to 10 / 30 / 35%.
**Return on equity (ROE), from the moat.** Growth only adds value while returns stay above the cost of capital.
- Near-monopoly: 55 / 75 / 100%.
- Strong (category leader, real network effects, 18+ months old): 35 / 50 / 70%.
- Moderate: 25 / 35 / 40%.
- Weak or easily copied: 10 / 15 / 20%.
Never use an ROE below the terminal cost of equity.
**Cost of equity (Ke), built from the risks.** Add up:
- the US 10-year Treasury yield;
- Damodaran's US equity risk premium;
- regulation:
- no KYC with unresolved US exposure: 2.5 / 2.0 / 0.5%;
- past US probes closed: 1.0%;
- regulated: 0.5%;
- governance: 0.4% for each of concentrated control, a team that can change the rules, and no legal wrapper;
- alignment: 0% if buybacks are automatic, 1% if governance controls them, 2% if discretionary;
- smart-contract risk: 2% at launch, falling evenly to 0.5% at three years old.
这份清单把文档、图片和音频放进同一条“原始资料→可用信息”的链路,比单纯罗列模型更接近真实项目。很多 AI 演示看似卡在推理,其实失败更早:扫描件 OCR 错了,表格和阅读顺序被打散,长音频转写丢掉专名,最终检索到的上下文从源头就不可靠。Docling、Marker、Surya 与 PaddleOCR 解决的并非同一个问题,选型要看输入格式、版面复杂度、语言和准确率要求,再决定组合,而不是把十个仓库一股脑塞进 pipeline。
SIE 把多类模型放进统一的自托管推理层,这个方向值得关注:统一 API 和按需加载可能减少服务拼装成本。但“100+ 模型”本身不是收益,还要核算冷启动、显存峰值、吞吐、版本管理和故障隔离,否则只是把多套依赖搬进一个更大的服务。Whisper 与 faster-whisper 的取舍,也应在自己的语言、音频长度和硬件上测,不能只凭项目介绍推断速度与资源占用。
更该沉淀的是每一环的质量边界:保留原文件与页码或时间戳,记录 OCR/转写置信度,对表格、数字、专名抽样复核,并把解析失败显式交给下游。这样 RAG 或 Agent 才能引用可追溯证据,资料质量不足时也能拒绝编答案。模型会继续变强,但可靠的输入处理、评估集和人工校验,仍是把 AI 从演示带进日常工作的基础。

10 GITHUB REPOS FOR TURNING RAW DATA INTO AI INTELLIGENCE
PDFs. scanned documents. images. audio. messy unstructured data.
these repos help you build AI systems that can actually work with it.
all open source. 👇
1. Docling — make documents AI-ready
github.com/docling-project/d…
Convert PDFs, Office files and other document formats into structured content. Great for document processing and RAG pipelines.
2. Marker — convert PDFs into Markdown
github.com/datalab-to/marker
Extract text, tables, equations and document structure from PDFs into formats that are easier for AI applications to consume.
3. Surya — OCR and document layout analysis
github.com/datalab-to/surya
Recognize text across multiple languages and detect document layout elements like tables, text blocks and reading order.
4. SIE — serve the models behind your entire AI pipeline
github.com/superlinked/sie
Here's what makes this one interesting.
SIE brings 100+ models behind one self-hosted inference layer, covering embeddings, reranking, OCR, structured extraction, image understanding, speech-to-text and more.
It supports an OpenAI-compatible API and loads models on demand, so you're not managing a separate inference service for every task.
One layer powering multiple parts of your AI pipeline.
5. Whisper — speech recognition by OpenAI
github.com/openai/whisper
Transcribe audio and handle multilingual speech recognition with an open-source speech recognition model.
6. faster-whisper — run Whisper more efficiently
github.com/SYSTRAN/faster-wh…
A reimplementation using CTranslate2 that can deliver faster transcription with lower memory usage.
7. Florence-2 — understand images
github.com/microsoft/Florenc…
A vision model for tasks including image captioning, object detection, OCR and visual grounding.
8. Qwen2.5-VL — work with visual information
github.com/QwenLM/Qwen2.5-VL
A vision-language model family built for understanding images, videos, documents and visual details.
9. DeepSeek-OCR — extract information from documents
github.com/deepseek-ai/DeepS…
Explore OCR through vision-language models, with a focus on extracting text and information from document images.
10. PaddleOCR — build document intelligence systems
github.com/PaddlePaddle/Padd…
A comprehensive OCR toolkit for text detection, recognition and document parsing across real-world use cases.
The real bottleneck isn't always the LLM.
It's getting messy real-world data into a form AI can actually use.
all open source. worth a bookmark.


这两个案例提醒我,企业上 AI 时最容易跳过的,其实是“先把工作看清楚”。电信团队已有仪表盘和 Agent,仍然可能因为输入、过程、输出没被讲明白,让模型给出听起来合理、实际跑不通的答案;制造报价更直接,图纸字段抽错、成本规则没接好,最后的数字就会偏离真实成本。问题不在于模型能不能写出漂亮方案,而在于它接手的任务有没有稳定边界、结果有没有可核验的依据。
所以我很赞同先跟一单真实业务走完全程,再问谁提供输入、谁做判断、谁承担交付,以及异常由谁接住。AI 先做重复、结构化、可回查的一小段;报价、管理结论这类会影响成本或决策的输出,则保留人工校准和责任人。制造案例里的“减负五成”也明确是早期当事人自述、没有对照,这种口径值得保留:上线故事能提供线索,但不能自动当作因果证据。先把流程、基线、错误成本和人工闸说清,再逐步扩大 AI 的岗位,往往比先追求全链路自动化更能走到稳定交付。

这类工具真正打动我的,不是把日志、链路、错误、会话回放和 AI 调用成本放进同一个界面,而是它试图把“发现问题”与“采取行动”接起来:Agent 可以读取生产错误,默认只读,再把诊断结果带回人的工作流。对小团队来说,少在几个后台之间切换确实能缩短排查路径;但可观测性产品也最容易制造一种错觉——指标齐全就等于问题可解释。真正有用的系统还得让人看清某个结论来自哪条 trace、哪段会话、哪个版本和哪次模型调用,并能快速复现,而不只是给出一段看似合理的摘要。
我会特别关注“read-only by default”这条边界。让 Agent 先读日志、归纳异常、提出修复建议,风险与收益比较清楚;一旦它能重启服务、改配置或写数据,就需要权限分层、操作留痕、可回滚方案和明确的人类确认。否则,自动化可能把一次误判从单个告警放大成线上变更。另一个实际问题是成本口径:AI 调用费用要能按项目、环境、任务和模型拆分,并和请求量、错误率、延迟一起看,才能判断花费换来了什么,而不是只得到一张总账单。
自托管、MIT 许可和兼容 OpenTelemetry 都是不错的起点,尤其适合希望掌握数据边界、又不想被单一 SDK 锁定的团队。接下来最值得验证的是部署后的维护负担、采样与保留策略,以及高基数数据下的资源成本。把这些和“从异常到可验证修复”的时间一起衡量,才能知道它究竟是又一个仪表盘,还是能真正缩短反馈闭环的工程工具。


我认同这条观察里最关键的区分:AI 的价值不只是把某个环节提速 20%,而是有机会重组从发现问题、执行任务到交付结果的整条链路。若一个 Agent 能持续观察搜索表现、分析转化、提出修改并推动上线,它改变的就不只是个人效率,而是小团队能承担的工作范围与反馈速度。
不过,“几台电脑接管几十人团队”更适合作为方向判断,不能直接当作已经普遍成立的结论。真正决定它能否创造业务价值的,是闭环能否稳定运行:目标和权限是否清楚,数据是否可靠,改动是否经过验证,出错时能否回滚,人工介入成本是否仍然可控。自动化做得越深,监控、审计和异常处理就越不能省略。
熟人不愿意为每月 200 美元订阅付费,也未必只是看不懂趋势。若日常工作暂时没有明确场景,或现有工具已经够用,拒绝额外支出是合理选择。让人改变判断的通常不是“AI 很强”的口号,而是一个具体任务:过去要几天、几个人,现在用什么流程完成,质量有没有下降,最后省下的时间或增加的收入是否超过工具和维护成本。
所以我更愿意把这条趋势理解为:竞争单位正在从“谁更会使用模型”转向“谁能把模型、工具、数据和责任机制组织成可重复的交付系统”。模型能力重要,但业务流程、评估标准和兜底设计,才决定它能不能从演示走到日常经营。

很多人以为科技圈早就在全面拥抱 AI,其实仔细看看身边,全是假象。
昨天跟我发小,在大厂年薪大几十万,他到现在连一个月 200 刀的顶级模型订阅都舍不得掏,用的是公司自家的模型+DeepSeek,每个月(200美金额度)。
嘴上全是不屑和抵触,说这玩意儿感受不到实际用处。
很多人骨子里其实陷在一个极度致命的误区:以为 AI 只是个帮自己提效 20% 的打工外包。
心里甚至还暗爽,觉得“老子才是不可替代的架构师,AI 提效不过是我指挥有方”。
我认为,商业世界的账不是这么算的。
当你还在把 AI 当成写写周报、补两行测试用例的玩具时,真正在一线用AI拿结果的人,已经靠几台电脑接管了原来 几十人团队的交付闭环。
以后的网站根本不是几张冷冰冰的展示页面。
它本身就是一个 24 小时无休的 Agent,自己盯 Google 搜索排名,自己分析转化率,自己去抓数据改代码。
你在睡觉,你的系统在替你赚钱。
当你还在按月算薪水、等层层汇报的周报时,外面一人公司的交付周期已经按小时算了。
在真金白银的交付速度面前,大厂那套靠堆人头撑起来的编制,坍塌只是个时间问题。
这组对比让我想到,computer-use 的提速关键未必是让模型“想得更快”,而是把哪些步骤适合代码稳定执行、哪些节点必须重新观察和判断,切分得足够清楚。把连续、可预测的操作合并进 run_plan,确实能减少模型逐步生成与等待的开销;而 Jev 负责在界面发生明显变化时检查计划是否失效、提示下一处需要介入的位置,这相当于给自动化补上了刹车和路标。
不过“快了将近一半”最好和成功率、恢复成本一起看:页面加载延迟、弹窗、权限状态或布局变化,都可能让一段原本有效的代码跑偏。若评测只报告 task time 或 wall time,读者还需要知道失败任务有没有计入、人工介入如何统计、重复运行的波动多大。否则减少了模型思考时间,却把排错负担转移给用户,也未必是真正的效率提升。
我更期待看到按任务类型拆分的结果:固定流程看代码聚合带来的吞吐提升,长链路和高变化场景则看观察点能否及时发现偏差,以及失败后能否安全恢复。速度、可靠性和可解释性放在同一张表里,这种 planner-executor 与代码协作的价值才更容易被复用。

当 AI 知道自己可以编写多步的 computer-use code 之后,computer-use 的执行速度会极大的加快。在我的例子中,快了将近一半的时间。
A 是 code relay + 纯 ReAct。
B 是 code relay + Jev +planner-executor 模式,提供了基于 code relay 工具构建的 observe 和 run_plan 两个 tool,Jev (Decision API) 提供 plan invalidation 检查点和下一次需要 Jev 介入的步骤序号。
测试下来,因为引入 observe 和 run_plan 工具使得模型在生成 computer-use 代码的时候聚合了多个步骤,模型思考时间 (subagent model) 得以极大缩短。
图一是 task time,图二是 wall time。


这组结果最有意思的,不只是 DeepSeek Harness 在 BugHuntBench 上让 Flash 1017 的修复分数提高约 3 分,而是它把“系统能力”也放进了模型比较:引用里的数据说平均提升 2–3 分,同时成本增加 80%。如果只看榜单,Harness 像必抽专武;把额外 token、子代理和运行时间一起算进去,它更像一项需要按任务购买的工程配置。真正要回答的不是“Harness 好不好”,而是这几分提升在真实仓库里能否带来更高的修复成功率,减少回归和人工复核,价值是否足以覆盖成本。
我会希望评测再拆开看:固定模型与提示词,只切换 Harness;报告多次运行的分布,而非单次最高分;同时记录端到端耗时、工具调用、失败类型、修复成功率和人工接手比例。否则分数差异可能混合了模型、工具权限、上下文策略和预算的影响。基准本身仍是有用信号,但不能直接等同生产收益。高价值、失败代价大的任务,80%额外成本也许划算;批量日常修复则可以按难度动态启用子代理。好的 Harness 不只抬高上限,也应清楚说明它在哪些任务上最值、代价从哪里来。


最让我停下来想的,不是“10小时对一年”的速度对比,而是这次复算据称还找出了错误,且作者说最终结论没有改变。这个案例把 AI 进科研的价值与风险同时摆在台面上:它也许能迅速重做繁重推导、充当第二位检查者,但速度本身不能证明推导可靠,更不能代替研究者解释近似、边界条件和每一步为何成立。
真正值得同行关注的,是这项工作的过程能否被独立复核:AI 找到的错误是什么,影响了哪些中间推论,为什么没有改变最终结论?人工一年与模型十小时的工作范围、工具、验证方式是否相同?如果公开论文、代码和计算步骤能让别人重复得到一致结果,节省的时间就可能转向提出更好的问题、解释结果和检验假设;如果过程不可重现,十小时仍只是一个惊人的演示数字。
所以我不觉得科研劳动的价值会简单消失,更可能是评价重点从“亲手算了多少页”转向“能否提出好问题、设计严谨检查,并对结论负责”。手算和专业训练也不会因此变得多余:正是学科理解让研究者知道模型在哪些地方可能出错、哪些验证不能省。AI 可以扩展一个人的研究能力,但可信的知识仍需要可追踪的推导和负责任的人来把关。

Bir fizikçi itirafı:Doktora tezimde 1 yılımı ve~500 sayfa elle yaptığım kuantum gravite hesabını Opus 5.5 makalesi ve GitHub reposu dahil 10 saatte yaptı.😱 Üstelik hataları da buldu.Neyse ki sonuç değişmedi. Akademide “emek” bundan sonra neyi ifade edecek?github.com/eokahya/claude-au…

这条观察值得继续追问:安全基准上的差距扩大,究竟说明模型能力分化,还是评测覆盖、工具使用和任务设定也在改变?Cyber ECI 的分数能提供一个有用信号,但单个总分很难代表真实攻防表现。尤其当开源模型与闭源模型使用不同的访问方式、提示策略或系统配置时,差异可能同时来自模型本身和测试条件。
我更关心的是它对部署决策的含义。开放权重带来的可检查、可微调和本地运行,仍然有独立价值;但这些优势不能自动抵消安全能力上的短板。组织若把模型接入代码、凭据或生产环境,应该按具体任务做自己的红队评估,观察漏洞发现、误报漏报、拒绝行为和工具调用边界,而不是只看排行榜名次。
反过来,基准差距变大也不该被解读成“开放路线没有意义”。公开评测能指出能力缺口,帮助研究者复现问题、追踪改进;真正有价值的比较,应同时公布版本、提示、工具权限和评分方法,并分解不同攻击类型的结果。这样才看得出差距来自哪里、什么场景最相关,以及下一步该补数据、训练还是防护。

Bro why the gap between Chinese open-weight models and US closed models is widening again on cybersecurity benchmarks.
Epoch AI's Cyber ECI showed a ~6-point gap in early 2025. It's now 11 points.
GLM-5.3 leads open-weight models with a score of 160, while the US closed-model frontier has pulled further ahead.
Open models are improving, but the gap is growing instead of shrinking.

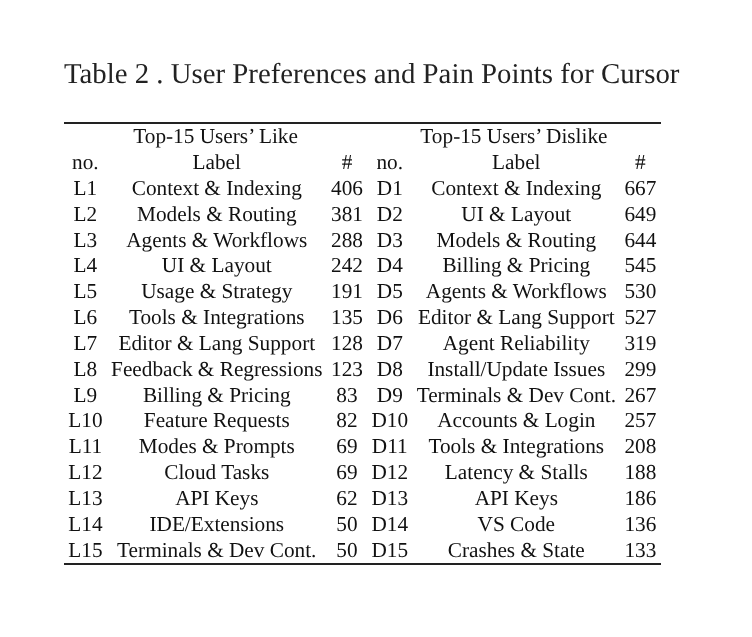
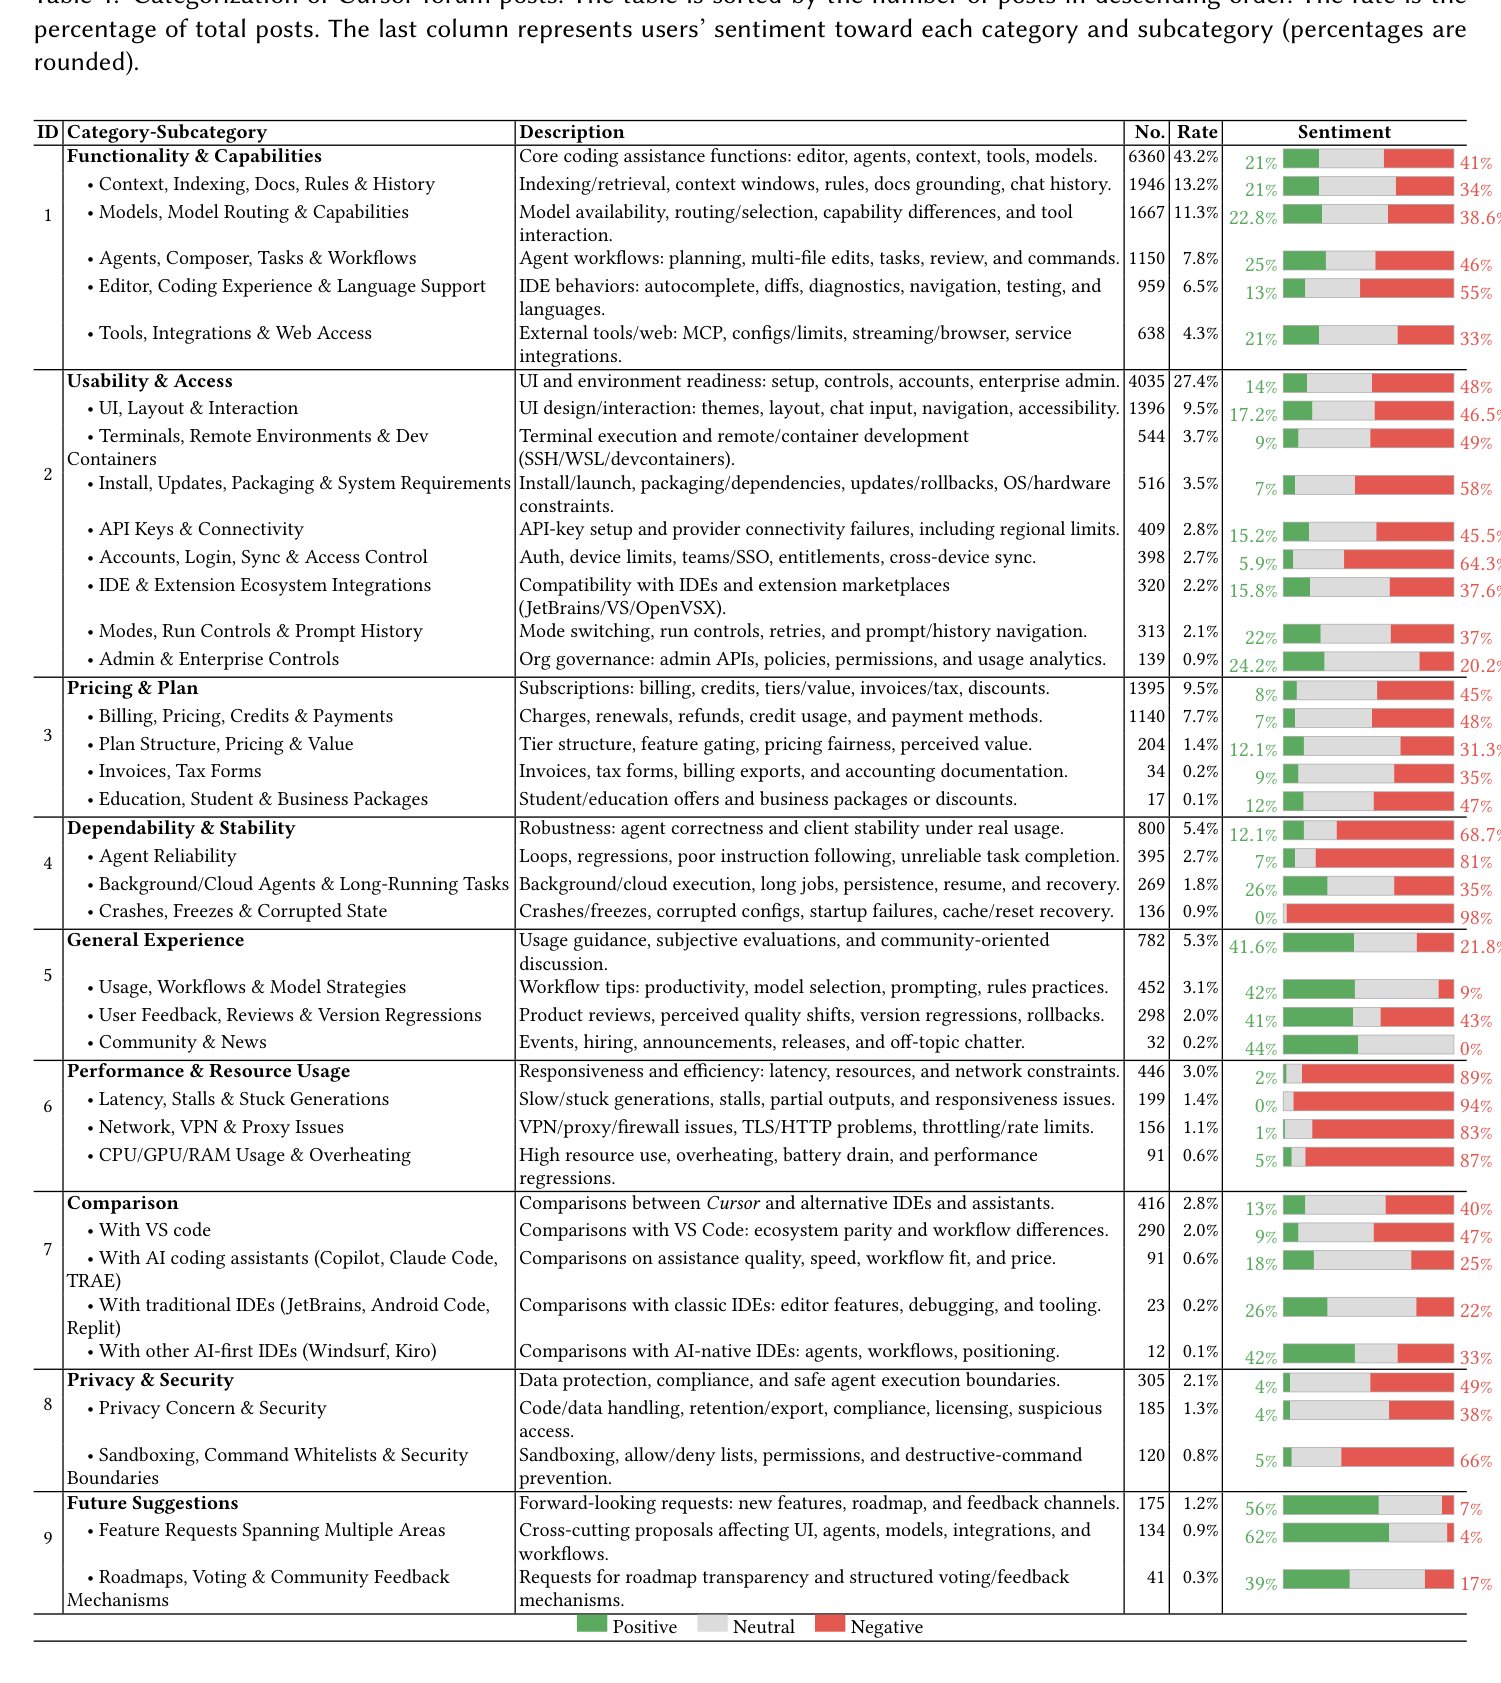
这组论坛数据最值得产品团队重视的,不是把 71% 当成所有 AI IDE 用户的普遍结论,而是它揭示了工作流本身已经成为产品的一部分。模型回答得再好,如果上下文从哪里来、何时被截断不可见,用户就很难判断一次失误究竟是模型能力问题还是信息缺失;路由规则不透明,价格和速度的取舍也无法预期;Agent 中途失败后若不能恢复到明确状态,所谓自动化就会变成难以追责的黑箱。
因此,与其继续堆功能,我更想看到三类可验证的改进:让用户检查和修正上下文,让模型选择与成本变化有据可查,让失败任务可以续跑、回滚或清楚交接。计费也应能对应到具体任务,而不只是月底出现一个总数。产品指标可以从“调用了多少次”转向任务完成率、人工接管率、恢复成功率,以及完成同一类任务所需的总成本。
当然,这个样本来自 Cursor 公开论坛,能说明用户愿意报告什么,不能直接代表沉默用户或其他产品。它更适合作为问题清单和后续访谈的起点;要判断哪项改进真正有效,还需要结合产品内行为数据、支持工单和对照实验。

如果 AI IDE 的上下文、模型路由和 agent 流程既创造价值,也最容易出故障,工程重点就不该只是再加功能。
arxiv.org/abs/2610.20618
研究分析 Cursor 论坛两年多的 14,714 篇帖子与 51,965 条评论:71% 的讨论围绕这些工作流机制。用户痛点也从早期安装访问,转向能力、价格与持续可靠性。对产品设计的启示很实在:上下文要可控、路由要讲得清,agent 出错后要能恢复,用量账单也得可信。局限是数据来自单一产品的公开论坛,不等于所有用户的真实体验。

这条讨论把“Agent 写得快”重新放回工程交付的完整链条里看,我很认同。30 小时接近 400 个 PR 听起来惊人,但它们大多集中在 Web 性能,而且有重渲染、CPU、内存这些可观测指标;这更像一个边界清楚、结果容易衡量的任务集,不能直接推出 Agent 已经能在任意业务里独立完成交付。真正值得学习的,是为什么这类改动能拆得这么细:每个 PR 有明确目标,变化范围可控,测试和内存泄漏检查能及时发现回归,出了问题也更容易定位和回滚。没有这套基础,吞吐量越高,review 和排错的压力可能也越大。
我也赞同把人工审核按风险分层。低风险、可自动验证的改动,可以让 Agent 多跑几轮;一旦涉及权限边界、数据迁移、资金、隐私或不可逆操作,就应该有清楚的人类决策点。Agent 的“通过”只能算一类检查结果,不能替代责任归属。测试 harness 的价值也不止是守住旧行为:它会迫使团队把预期说清楚,甚至暴露原本就存在的缺陷。为了让 Agent 更自主而写检查,往往也是在补工程本身欠下的验证债。
因此,衡量 Agent 工程化不能只数提交量或合并数,还要看改动是否真的产生目标收益、回归率和返工成本、问题被发现所需时间,以及人工介入是否集中在高风险判断上。能稳定扩大的不是“少 review”,而是把重复、机械、可证明的检查自动化,同时保留人对目标、风险和最终结果的把关。

T3 Code 的 @jullerino 说他的 agent 30 个小时合了快 400 个 PR,5 万浏览。我把这条和这两天讲 agent review、测试的几条帖子放一起看了,说几点自己的看法:
1. 这 400 个 PR 主题全是 web 性能:别的线程在流式输出时重渲染少了 86%,JS CPU 最多降 35%,堆内存小了 10% 左右。评论区有人去查了,10 月 17 号一天 t3code 合了 391 个 PR,278 个标题带 perf。
2. 为什么能这么跑,评论区有句话说得准:改动窄,有个数字能验证,有测试兜住回归。@theo 也回了一句,幸亏之前把内存泄漏检测都搭好了。
3. 质疑也不少:400 个 PR 有没有人 review,为什么不合成一个大的,这么多 PR 怎么不互相冲突。
4. 对照 @ScarletKc 整理的 Claude Code 团队那篇:agent review 能跑 50 多轮停不下来,后来上限卡在第三轮,要不要人审按风险分级定,agent 的 approve 也不算人。
5. Cap 的 @richiemcilroy 也说了差不多的话:代码写得越快,他越多时间花在证明没改坏东西上,为此专门搭了一套测试 harness,搭的过程中还顺手修了一堆 bug。
我的结论是 agent 能连续跑多久、合多少,取决于验证那一圈搭得有多结实。人该花时间的地方,正在从写代码挪到写检查。

这条帖子的关键提醒,不只是“初级岗位变少”,而是经验从哪里来。资深工程师并非天生就能识别危险 diff;很多判断力是在修 bug、写测试、被 review、看见线上故障之后,一次次形成的。那些任务看起来琐碎,却是把抽象原则和真实后果连起来的训练场。若 Agent 最先接管的恰好是这些入门工作,团队眼前确实可能更快,但人才成长的梯子也会少掉几级。
我不认为答案是为了培养新人而把所有工作退回手工。更实际的是重新设计“练级路径”:让新人先在有边界、可回滚、影响较小的任务里负责结果,而不只是旁观 Agent;要求他们解释方案、检查生成代码、补测试、复盘失败,并逐步扩大权限。Agent 可以给提示和反馈,但不能把关键判断也一起代劳。否则新人积累的只是提示词经验,未必能迁移成独立诊断能力。
对团队来说,效率指标也该从“生成了多少代码”往后多看一步:审查后留下了多少缺陷,返工和事故成本怎样变化,新人多久能独立判断风险,资深同事是否有时间教会别人。若只统计 Agent 工时和交付速度,培养成本会被推迟到几年后才显现,届时组织可能已经失去能教、也能审的人。
所以我更关心的不是 2031 年到底有没有人检查 Agent,而是今天谁在设计让下一代具备检查能力的工作。自动化可以缩短练习反馈的周期,却不该抹掉练习本身。把低风险任务、清晰责任和人工复盘嵌进流程,既能用上工具,也能让“会发现看似正确的错误”继续有人学会。

初级工程师越招越少。资深工程师从哪里来?
Anthropic 统计了 AI 怎样改变了公司的工作:
> 新入职技术员工中初级工程师的占比:27% → 9%
> 员工规模一年内:×3
> 到 8 月智能体的工时:人类工时的 ×6
> Claude 等待人类回复的时间:约 80%
至于其他人,Claude 让他们变得“更高效”了,而你现在成了一支干着六个人活儿的团队的门卫。读一遍,点“批准”。
门卫得看清从他面前过去的是什么。能区分“真能用的代码”和“只是看起来能用的代码”的,是那些多年来写过自己的烂代码的人。这些年的代价由初级工程师来付:他们在代码评审里被敲打,拿别人的钱试错。
想象一个 2026 年没被录用的初级工程师。到 2031 年,他本来会盯着智能体的 diff,说一句“停,这里有个洞”。他能看出来,因为他自己当年也留下过一模一样的洞。可他没被录用,如今盯着 diff 的是一个从没被人指给他看过这种洞的人。
初级工程师过去靠几年时间在这些任务上成长为资深工程师,现在这些任务由智能体来做。梯子还挂在原地,却爬不上去。也许智能体会成长到能自我检查,但目前没有数据支持这一点。
我押另一边:大约五年后,将没有人来检查智能体。把这条帖子收藏起来,2031 年我们再对一对谁说对了。如果你们团队现在正好在关一个初级岗位的招聘,请把这条帖子转给负责关闭它的人,让他知道自己到底在省什么。如果你也抓到过智能体写出“只是看起来能用”的代码,点个赞:我想知道我们有多少人。
如果这架梯子不修,行业会变成什么样,我在文章里展开讲 ↓
这篇最打动我的不是“多模型互审”这个动作本身,而是把每一步的边界说清楚了:一个 PR 只做一个具体变更,审查针对明确的代码版本和 base,任何 rebase 或合并都可能让旧结论失效;CI 与完整浏览器矩阵分层,发布前再核对候选、备份和迁移,最后由人承担上线决定。这样做确实比让 agent 一路自动跑到部署更慢,也会增加 token 与等待成本,但它把“看起来完成了”拆成了可追溯的证据链。
我尤其认同把代码审查和安全审查分开、要求审查者从新上下文出发。多一个模型不自动等于独立意见:如果它们读的是同一份不完整上下文、沿用同一假设,分歧可能只是表面上的。真正有用的是明确每个执行者要找什么、依据哪一版 diff、结论对应什么证据,以及什么时候必须重新审查。这样修复也能落到具体风险,而不是把所有变更都送进最重的流程。
分阶段验证的价值也在于此。小改动先用局部检查快速反馈,候选集成后再付出完整矩阵的成本,既不把昂贵验证平均摊给每个提交,也不让局部通过被误当成整体发布许可。关键仍是发布人能看到候选版本、迁移与回滚条件,并在上线后核对真实行为。模型会换代,CLI 和编排也会变化;留下可检查的命令、结果、版本和责任边界,才让流程能够升级而不丢失判断依据。慢是成本,事故返工和不可追责也同样是成本;值得追求的不是把每一步都做得最重,而是让风险决定验证深度。

Hace dos días Claude ha sacado un post de como revisan ellos el código, y dado que yo llevo casi ya 3 años centrado en el desarrollo autónomo lo he leído con mucho interés a ver que hacía yo como ellos o ellos como yo :)
Te lo cuento
Tienen revisiones independientes, pruebas verificables, controles según el riesgo y una persona responsable de lo que acaba publicado.
Yo lo hago igual solo que diseño circuitos agnósticos al modelo y los orquesto desde CLIs, ellos vende su Claude y su code-review max, y yo lo hago igual con un Codex, que con un Kimi, que con un GLM.
Más menos... así organizo mis cositas
1. Un cambio concreto por PR.
Acoto el objetivo y trabajo en una copia aislada del repositorio. Esto me permite avanzar en varias tareas sin mezclar sus cambios y revisar cada propuesta por separado. Yo uso worktrees fijos pero estoy probando ya worktress fungibles.
2. Revisión con contexto nuevo.
Abro el PR en borrador, ejecuto las comprobaciones locales que toquen y paso una revisión independiente. Código y seguridad tienen revisiones separadas,generalmente con modelos distintos, Codex revisa Claude, y Claude revisa Codex, generalmente.
Cada ejecución recibe una responsabilidad concreta y debe aportar evidencia de sus conclusiones.
3. La revisión pertenece a una versión.
Registro qué código se ha revisado y contra qué base. Si cambia cualquiera de los dos, reviso de nuevo ( esto pasa mucho con 10-15 agentes dándolo todo) . Esto también se aplica cuando incorporo cambios de otra rama.
4. La validación avanza por etapas.
Después de la revisión llega el CI del PR. Las baterías completas de navegador se reservan para el candidato conjunto que se va a publicar proque esto suele consumir mucho tiempo y recursos.
Así puedo revisar cambios acotados y comprobar después cómo funcionan juntos en la versión final.
5. Publicar requiere una decisión explícita.
Antes de desplegar compruebo el candidato validado, las copias de seguridad y las migraciones que correspondan. Después verifico la versión publicada y su comportamiento real.
La decisión de publicar y la responsabilidad sobre el resultado siguen en mis manos ( de momento :))
Trabajar desde CLIs me permite conectar estos pasos y conservar comandos, resultados y versiones. La orquestación queda definida en un circuito que puedo inspeccionar y adaptarlo como me salga de.. la nariz :)
Anthropic explica en ese post cómo organiza estos principios el equipo que construye Claude Code.
Yo los aplico con mis propios circuitos, con una capa de coordinación pensada para trabajar con distintos modelos y tools, pero reconozco que hay lógicas muy parecidas, y creo que eso nos va a llevar a un estámndar de desarrollo con IA
Creo que los modelos va a seguir evolucionando, pero quiero que mi forma de trabajar pueda incorporar esa evolución y que mis procesos sean antifrágiles.
Una última cosa... esto es lento. Desarrollar asi cuesta un multiplicador en costes de tokens y tiempo, pero la calidad no tiene nada que ver con hacerlo de otra manera, y si son productos que vendes y tienes un negocio detrás... dime tú Rick...
这组结果最有价值的地方,可能不是“递归训练一定有效”,而是它提醒我们:Agent 能力并不是脱离运行环境的单一分数。Terminal-Bench 2.1 上从 77.53% 升到 78.95%,同时在 4.0 上从 16.67% 跌到 11.11%,说明旧环境里的小幅进步完全可能掩盖新环境里的退化。只盯一个熟悉的榜单,很容易把适配旧题型误读成能力普遍提升。
RSR 把成功轨迹整理成 runbook,再经过泄漏审查并在目标 harness 重放;RPR 则接续 critic 做 PPO。这条路线把数据整理、运行框架和模型更新都放进闭环里,工程上很值得继续研究。但目前缺少算力配平、critic 继承的独立消融,也只有单模型三次推理均值,递归本身的贡献还不能和其他因素拆开。代码入口暂时不可用、没有公开模型,也意味着外部团队还难以复现和定位差异。
因此我会把这篇工作看成一个有启发性的训练流程与评测警报,而不是可直接引用的能力排名。尤其 DeepSeek 的 42.3% 是在 Claude Code 框架下测得,与论文采用的框架不同,横向比较前必须先统一 harness、工具权限、上下文预算、提示策略和计分规则。更稳妥的做法是同时报告多个版本基准、多个运行框架、重复运行分布以及失败类型;如果新基准持续变差,就该先查任务分布和框架适配,而不是继续追逐旧榜单上的小数点。

腾讯与 NUS 等团队公布了 Terminal-RSI,一套让终端 Agent 递归自我改进的训练流程。他们用 Qwen3.8-27B 调优,在终端基准上跑出一组反差很大的数据,旧版 Terminal-Bench 2.1 拿到 86.52%(Base 只有 51.70%),新版 Terminal-Bench 4.0 却只有 19.84%(三次运行均值 Mean@3)
训练拆成两个交替阶段。先做 RSR,把不同 Agent 运行框架(harness)里跑通的任务轨迹改写成操作步骤(runbook),过完泄漏审查后在目标框架重放验证,再用筛选出的成功轨迹做监督微调,只更新 actor 的权重,不改运行时源码。接着是 RPR,继承估计后续回报的价值网络(critic),联合 PPO 迭代模型权重。算上基座 Base,全流程共保留 5 个阶段
论文第 3.3 节记录了一组反向变化。在第一轮 RPR 强化学习中,从 step 20 继续训到 step 35,Terminal-Bench 2.1 从 77.53% 涨到 78.95%,Terminal-Bench 4.0 却从 16.67% 跌到了 11.11%。如果单拿旧测试集分数挑模型,容易选到在新环境倒退的检查点
评测环境关闭了显式思考,按结构化 JSON 解析动作,搭配 32k 上下文主动摘要。论文未做算力配平与 critic 继承的独立消融,评测取的也是单模型三次推理均值而非独立训练种子,目前还不能把增益全部归因于递归本身
团队公开了训练思路,但论文代码入口当前 404,所链接组织暂无公开模型
对于 Agent 的开发者,看评测必须核对运行框架。DeepSeek 官方自报 DeepSeek-V4.1-Flash-1017 在 Terminal-Bench 4.0 拿到 42.3%,但测的时候跑在 Claude Code 框架下,使用的运行框架与这篇论文不同,不能直接横向比较两组成绩
