






drinkingtech retweeted

Saying that it's performance driven is like the worst thing you could say in this job market.
For a regular layoff, the employee can at least say that it wasn't due to their fault but here it becomes harder

"Oct 20 (Reuters) - Qualcomm will cut jobs globally in a "performance-focused reduction" following its annual employee reviews, CEO Cristiano Amon told staff in a memo on Monday reviewed by Reuters, with notifications set to begin in November.
The cuts are part of an effort to build "a stronger performance culture" and address situations where the company "has consistently fallen short of expectations," Amon said."
drinkingtech retweeted

并没有奉若圭臬,只是分享而已 ,我也补充一下孟老师 @myanTokenGeek 提到的李录卖飞MU 的资料给大家
李录在2019年底存储行业周期底部首次重仓美光(当时几乎是美股组合唯一持仓),随后在2020年低点继续加仓,峰值持股约1147万股。持有约3.5年后,于2023年上半年分两批全部清仓。
感兴趣具体李录怎么聊可以看这一条:xitter.cf/Vegahao/status/2112109…
买入:2019Q4–2020Q3逐步建仓至峰值。
持有:2021–2022年基本不动。
卖出:2023Q1减持约40%,2023Q2清仓剩余全部。
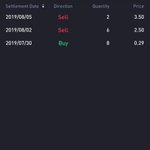
结果:平均成本约48.6美元,平均卖出约62美元,总投入约5.55–5.57亿美元,收回约7.1亿美元,盈利约1.5亿美元,总回报约27%–30%(年化约6%–8%)。
绝对收益为正,但清仓后美光因AI/HBM需求爆发大幅上涨(从约60美元涨至2026年的数百至千美元区间),属于典型的“卖飞”案例。操作符合其价值投资风格:周期底部集中重仓,之后转向更清晰或更便宜的机会。
下图是李录的操作,整体年化在6%-8%


drinkingtech retweeted

当黄仁勋当面对质德国总理时,全场气氛瞬间凝固了…… 🤐
欧洲科技界最大的病根,被皮衣黄一句话活生生刺破!
在峰会上,德国总理默茨(Merz)还在大谈要在“创新与监管”之间找到完美平衡。黄仁勋听完,直接抛出了一句堪称暴击的灵魂考问:
💬 “我听说您一直想在‘创新与监管’之间找平衡。但——如果一个行业连活都没活下来,你到底要监管什么?”
💬 “你首先得让德国的 AI 产业蓬勃发展起来啊!”
💥 这句话直接扯下了欧洲最骄傲的“监管外衣”!
连种子都还没发芽,就急着成立“市场监管所”;连公司都还没跑通业务,厚厚的合规法案就已经盖过来了。
“硅谷在写代码,共匪国在跑应用,而欧洲忙着印红头文件。” 当监管的靴子落得比创新的脚步还快,所谓的“寻找平衡”,不过是在给未出生的婴儿,提前制定成人计划。
没有繁荣的产业,所有的监管规则都只是在“监管空气”‼️
老黄这次当面撕下欧洲的最后尊严,你觉得他是说中了要害没?😎🤔
drinkingtech retweeted

今天有个搞Infra的小男娘发消息跟我说
这是他成年以来最好的秋天
这一年他终于找到了做推理优化的工作
每天和GPU、Kernel、MoE、KV Cache打交道
以前想研究DeepSeek的推理系统,只能对着论文、技术博客和Benchmark,一点点猜他们线上到底是怎么跑的
今天DeepSeek突然把DeepInfer开源了
分布式推理、推测解码、SWA Bounded Replay,连调度器和高性能算子都放出来了
英伟达和华为昇腾都支持,连生产级的Token编解码组件也一起开源
过去要花几个月研究的东西,现在直接就能在GitHub上看源码
今天下午他坐在工位上
突然整个Infra群都沸腾了
所有人停下手头的调参,开始疯狂Clone仓库
有人在看Kernel,有人在研究调度器,还有人在讨论怎么把公司祖传的推理框架换掉
他说很开心
有种人类Infra黄金时代的错觉

drinkingtech retweeted

groups.google.com/g/golang-a…
github.com/golang/go/issues/…
bugzilla.mozilla.org/show_bu…
貌似是有个 CA 泄漏了,不知道影响面多大... 可能最近都得小心点(

drinkingtech retweeted

另外再给大家同步个好玩的东西, 已经搞了一周了. 这个如果能做成功, 大家手里的Qwen3.8-27B, Qwen3.6-35B-A3B, Qwen3.8-Flash-Next 的速度能在开启MTP的情况下再原地提升16%左右. 我会直接发一个llama.cpp / mlx 版本, 开箱即用. 祝我成功吧.

drinkingtech retweeted

老黄最近上了 Lex Fridman 的播客,顺手把台湾半导体发家致富的底层逻辑给扒了个底朝天,,他抛出的观点挺超纲:台湾今天能在芯片圈横着走,最初始的源头其实是当年号称“欧洲通用电气”的荷兰巨头——飞利浦。
按老黄的说法,现在牛气冲天的台积电,以及搞光刻机的 ASML,全都是当年飞利浦拆分出来的产物。这盘大棋早在 1950 年代就被李国鼎给开局了,是他硬生生把飞利浦拉到了台湾搞科技制造。
随后的剧情简直是完美踩中了历史风口。IBM 刚把兼容机的规格一开源,台湾的工程师立马接住了这波红利,设计出的芯片组全交给了台积电和联电(UMC)去制造,直接把整个 PC 产业链的底座给焊死了。就连当年的小伙子迈克尔·戴尔(Michael Dell),也是纯靠着从台湾大把进货主板回去手搓组装,才一路拼成了现在的 PC 硬件巨头。
以前总觉得核心科技是靠闭门造车憋出来的,听老黄这么一捋,这完全是半个世纪前一环扣一环的产业链阳谋。
懂硬件和看历史的老铁们,眼下全球为了 AI 算力打得不可开交,你们觉得现在哪家大厂的布局或者结盟,有当年这波极限拉扯和借鸡生蛋的神级前瞻性?直接亮出你的名单开聊!
drinkingtech retweeted
李录这场88分钟的完整对谈,信息量巨大!我制作了中英双语字幕版本,建议转发收藏
AI的成本与泡沫、中国制造业与房地产、股市未来的角色、明确否定加密货币,以及做投资最难跨过去的人性。
其中有一个判断,值得所有在中国做投资、做生意的人反复琢磨:你所在的行业,究竟是国家要实现的目标,还是实现目标需要付出的代价?
在中国投资,先看懂“目标与代价”。 李录认为,中国的发展往往伴随着阶段性的重点转移。一个时期大力支持的行业,到下一个时期,可能就要承担转型的成本。房地产、制造业、环保,都可以放进这个框架里理解。对企业家和投资者来说,光看行业过去赚了多少钱还不够,还要看它现在处在什么位置。
中国股市未来的位置,要放进家庭资产负债表里看。 现场有人直接问:中国股市到底属于目标,还是代价?他的回答很有意思:当房地产在家庭和国家财富中的占比下降,什么资产来承接财富积累?在他看来,股权能分享企业创造的价值,也与经济增长相互促进。这是他的长期判断,至于什么时候发生,他没有给出短期时间表。
AI很有用,也很昂贵,最终仍然要算账。 他反复强调,AI会持续产生增量成本,算力、资本开支、收入和利润都绕不过去。能力越来越强,不代表投入就可以无限扩大。技术可以带来巨大变化,企业最终还是要面对财务纪律,市场也可能在这个过程中经历多轮繁荣与萧条。
中美AI的区别,他用两个问题来概括。 硅谷更关心:这项技术还能做什么,边界能推到哪里?中国企业也关心技术边界,但会更直接地追问:它能为我的消费者和企业客户做什么?一个更强调探索能力,一个更强调客户用途。这是他观察两边商业路径的切入点。
资金越集中,越值得看看被冷落的公司。 当资本压倒性地涌向少数热门企业,市场另一边可能就有优秀公司在低价交易。他认为,美国、中国和其他市场都存在这种分化。机会可能因此增加,但前提很难:你得能在别人不断赚钱、市场不断强化同一个叙事时,仍然保持自己的判断。
对加密货币,他的态度非常明确。 被现场问到时,他直接表示自己不考虑,并认为它最终会自行消失,也不认可它的社会价值。这部分肯定会引发争议。可以不认同他的结论,但值得连着前面关于货币、购买力和价值创造的讨论一起听,看看他的判断是从哪里来的。
价值投资最难的一关,是你到底想让市场服务你,还是指挥你。 有位做了两年价值投资的观众问:坚持理念却跑输市场,甚至影响职业发展,怎么办?李录把问题拉回了人性:既想长期做正确的事,又想每年、每季度、每个月都交出漂亮业绩,最后甚至希望每小时都赚钱,人就会逐渐变成投机者。做这门生意,还必须找到愿意与你长期同行、理念一致的资金。
最后讲到人生时,他把复利落在了几个很具体的东西上:知识、信任关系、智慧、健康。
找到适合自己的方向,选择值得合作的人,让这些东西持续积累。过程中会有好运,也会有坏运气;关键是尽量保住已经积累下来的东西,让时间继续发挥作用。
中英双语完整版放下面。尤其推荐把“目标与代价”、AI成本,以及最后关于职业和人生的问答连起来看。88分钟,可以留一个完整的时间慢慢听。
drinkingtech retweeted

瞎编的,明朝历史被改的面目全非,连官修明史都一堆冲突矛盾。
方孝孺一个胆小躲家里的也能被捧上神坛,稍微有点气节,要么像齐泰、黄子澄一样出京招募义勇反抗朱棣,要么自杀殉节,朱棣破城后很多自杀殉节的。
具体如下,详细考据编造历史故事的过程,
bilibili.com/video/BV1D84y1s…


drinkingtech retweeted

喜马拉雅资本创始人李录在哥伦比亚商学院第36届格雷厄姆与多德年度论坛上谈了不少AI。他认可这场技术革命的长期价值,但认为AI的发展可能经历不止一轮繁荣与崩溃。技术能走多远,除了取决于算力和算法,还受到资本投入、商业回报以及社会治理的约束。
李录对生成式AI的理解相当克制。他认为,AI利用庞大的算力和算法,从人类创造的数据中识别复杂关联,逐渐具备推理、编程和知识处理能力。它可以大幅降低知识和专业服务的获取门槛,但目前仍主要建立在人类积累的知识体系之上。能源、交通、制造业这些物理世界的约束不会因此消失。对于AI脱离人类控制、持续自我改进的可能性,他尤其警惕,认为人类必须保留监督和干预能力。
商业层面有个很现实的问题:AI与传统互联网的成本结构差别很大。 互联网基础设施建好之后,新增信息分发的边际成本可以压得很低,但AI每生成一次回答、执行一次Agent任务,都需要继续消耗GPU算力、电力和存储资源。模型训练需要大量前期投入,推理服务还会随着调用量增长产生持续成本。即使单次Token价格不断下降,任务复杂度和调用规模上升后,整体算力支出依然可能增加。
这也解释了AI产业链不同环节的盈利差异。英伟达、博通、台积电等上游供应商,可以直接从芯片采购和制造订单中获得收入;微软、谷歌、Meta等大型科技公司则需要承担数据中心建设、设备折旧和运营成本,再通过云服务、广告效率提升和企业客户付费收回投资。模型厂商还要面对推理成本、价格竞争和持续研发投入。上游资本开支对应的订单增长,并不意味着下游能够同步获得相同规模的利润。
李录还谈到资本过度集中的问题。他举标普500指数为例,2010年以来约16年的年化回报达到14%—15%,但2000—2010年几乎没有回报。把过去26年放在一起,长期年化回报又回到高个位数。市场可以在相当长的时间里偏离合理估值,但资本不可能无限增加。当大量资金集中追逐少数热门公司,另一边往往会出现一些经营质量不错、价格却受到冷落的企业。他认为,这种分化在美国、中国及其他市场都存在。
对于价值投资者而言,技术创新和股东回报始终需要分别衡量。AI能够提高生产率,扩大知识服务的供给,但巨额资本投入最终仍要通过收入、利润和现金流来消化。技术进步可以持续很多年,资本市场却未必会沿着同一条曲线定价。 这也是李录判断AI可能经历多轮繁荣与崩溃的重要原因。

drinkingtech retweeted

两张老 V100,也能在本地跑 3210 亿参数的 GLM-5.3-Flash!!
这个开源项目叫 Project Maya。
前几天我写过,12GB 显存 + 64GB 内存,用 Strata 就能跑千问的千亿模型。
这次 Maya 也是基于 Strata 做的,把引擎改成了适配 GLM。
作者实测:
2 张 V100 32GB + 约 32GB 内存 + NVMe SSD,
生成速度最高 40 token/s。
原理还是把常用的模型专家放显存,其他的分散到内存和 SSD,按需调进来。
默认用约 90GB 的 Maya-S 量化模型。
自带网页聊天、图片理解,还兼容 OpenAI / Anthropic API,可以接编程 Agent,
全程本地运行。
目前支持 Linux,Windows / WSL2 还不支持。
有这套硬件、想在本地跑 GLM 的可以看看:
github.com/mw00/project-maya

drinkingtech retweeted

A Complete Overview of AI Data Movement: Scale-Up/Scale-Out Networks and Memory Tiers
siliconcodesign.com/p/why-mo…

drinkingtech retweeted

剑桥这次甩出来的简直是核弹级操作!!AI & ML 的经典教材全套直接开放免费获取,PDF 想下就下。
打算入门机器学习、又不想当冤大头去买天价课程的人,把这十本啃完,根基基本就扎实了。
1️⃣ 《机器学习理解》——理论算法一并覆盖,零基础起步的第一选择
🔗 cs.huji.ac.il/~shais/Underst…
2️⃣ 《机器学习数学基础》——数学功底薄弱的先拿这本补课
🔗 mml-book.github.io/book/mml-…
3️⃣ 《机器学习算法的数学分析》——往数学原理深处钻
🔗 tongzhang-ml.org/lt-book/lt-…
4️⃣ 《深度学习理论原理》——把 DL 底层的理论根子弄明白
🔗 arxiv.org/pdf/2106.10165
5️⃣ 《神经网络与机器学习》——对神经网络做系统性拆解
🔗 arxiv.org/pdf/1901.05639
6️⃣ 《图深度学习》——图神经网络入门的必读书目
🔗 yaoma24.github.io/dlg_book/d…
7️⃣ 《机器学习的算法视角》——换个算法角度重新吃透 ML
🔗 people.csail.mit.edu/moitra/…
8️⃣ 《概率论:理论与实例》——把概率的地基打结实
🔗 sites.math.duke.edu/~rtd/PTE…
9️⃣ 《应用概率基础》——概率论落到实战里怎么用
🔗 sites.math.duke.edu/~rtd/EP4…
🔟 《高级数据分析》——数据科学往高阶走的必备读物
🔗 stat.cmu.edu/~cshalizi/ADAfa…
实话实说,这些书没有一本是省油的灯,别想着躺着就能翻完。
可你只要能咬牙啃下两三本,比在群里听人吹一年 AI 有多牛都顶用。

drinkingtech retweeted

美版 iPhone 主要的特殊之处在于支持了 B14(700M段的应急网络, ATT 日常可以用, 执法和救援部门终端有超高功率的 HPUE)和 B71(600M TMO 专用, 解决了 TMO 长期野外覆盖差的问题), 加上 B12(VZW) B13(ATT) 这两个 700M, 以及 B5 这个 850M 构成了美国主要的低频.
因为美国人工贵、居民区比较散, 然后野外比较多, 所以低频对美国用户非常重要, 像砖木结构的商店进去, 很多时候就只能依靠 B12/13/71.
然后苹果在低频上用的都是 sykworks 的 FEM, 这家算是业界质量最好的, 而且美版的 LB FEM 是选择了支持 14/71 这些美国特殊低频的加强特供型号. 大多数海外机器到美国能连 B12 B13 这样的 VZW 和 ATT 主力低频其实就够了, 但如果是 TMO 的话缺了 B71 其实体验有些下滑.
而前些年很多国产旗舰基本是不配 B12 13 的, 这几年稍微恢复了点, 但是用的 FEM 就可能是次一档的 Qorvo, 包括缺亚太 700M的 B28b 也是老问题.
所以我认为这个故障更有可能是 B13/14 的特定 CA 组合导致了FEM损坏, 新的 ipcc 对相关低频的 CA 组合的功率进行了控制, 或者是修复了异常天线开关路径的 CA.
另外一个值得注意的是 iPhone 18 Pro 全系列的顶部副天线 ANT2 砍掉了 LB 以外的频段, 变成了一个纯 LB 天线, 换来了1-1.5个db的增强, 顶部的MHB天线 ANT4也是大加强, 然后 L1 GPS 调整到了凸台上更大的 ANT14 上, ANT14 也算是一个非常强的 MHB 天线, b1 的增益是最高的.


drinkingtech retweeted

为了看懂 DeepSeek 的论文
我准备先学 《Switch Transformer》
arxiv.org/html/2101.03961v3
结果一查发现:
跟《Attention Is All You Need》一样
竟然都是谷歌出来的
那为什么看 DeepSeek 论文需要先看这篇?
因为DeepSeek论文默认你已经懂MoE的基本框架
Switch Transformer把这套框架讲清楚了
DeepSeek是在这个框架上做改进,不是另起炉灶
不补这一课
直接看DeepSeek
容易卡在一堆默认你已经懂的术语上
想看懂Switch Transformer
前置建议是:
先读完Attention Is All You Need
再手动实现一把GPT-2

drinkingtech retweeted

想搞懂 GPU 存储层级,Cornell 这篇教程是免费里讲得最好的之一。
它拿 Blackwell B200 一层层拆开:每个 SM 有 256kB 寄存器堆、256kB L1/共享内存、64kB 常量缓存,所有 SM 共享 128MB L2 和 192GB 全局内存。
三个最值得记住的点:
GPU 寄存器比 CPU 多得多,但缓存更小——GPU 靠海量线程藏延迟,CPU 靠大缓存,哲学完全不同
缓存行 128 字节 = 32 线程 × 4 字节,正好喂饱一个 warp——这就是为什么内存合并访问(coalescing)这么重要
所有数据传输都经过 L2,L2 是 device memory 的代理
写 CUDA 之前先搞懂这张图,能少踩一半的坑。Cornell Virtual Workshop 整个 GPU 架构系列都值得刷。
cvw.cac.cornell.edu/gpu-arch…