


Poincaré retweeted

Want to Become a Strong Backend Engineer?
Solving LeetCode problems is only one part of the journey....
Here are 10 skills that a software builder needs:
— Concurrency & Multithreading: Thread safety, synchronization, race conditions, deadlocks, and asynchronous execution.
— System Design: Scalability, load balancing, API design, bottlenecks, and architectural trade-offs.
— Database Engineering: Indexing strategies, query optimization, transactions, normalization, and caching with Redis.
— Distributed Systems: Replication, leader election, consistency models, network failures, and distributed coordination.
— Fault Tolerance: Timeouts, retry policies, exponential backoff, circuit breakers, and graceful degradation.
— Event-Driven Architecture: Kafka, RabbitMQ, SQS, message ordering, idempotency, and delivery semantics.
— Application Security: OAuth 2.0, JWT validation, TLS/mTLS, access control, and secure API communication.
— Observability & Debugging: Logs, metrics, distributed tracing, OpenTelemetry, and production incident analysis.
— Practical Problem Solving: Implement an LRU cache, rate limiter, job scheduler, thread-safe queue, and producer-consumer pipeline.
— Performance Optimization: JVM memory usage, CPU profiling, database bottlenecks, connection pools, and N+1 query issues.
The real goal isn't just to write code that works.
It is to build software that remains secure, fast, and reliable under real. world conditions.
Save this roadmap for your backend engineering preparation.

Poincaré retweeted

System Design Interview — Ultimate Question Bank (SAVE NOW)!
├── 01 Interview Frame
│ ├── Clarify Functional vs Non-Functional Reqs
│ ├── Back-of-the-Envelope (QPS, Storage, Bandwidth)
│ ├── API & Data Model First
│ ├── High-Level Diagram, Then One Deep Dive
│ └── Trade-offs, Bottlenecks & Wrap-up
│
├── 02 Building Blocks (Asked as Mini-Designs)
│ ├── Design a Load Balancer
│ ├── Design a Rate Limiter
│ ├── Design a Unique ID Generator (Snowflake)
│ ├── Design a Distributed Cache
│ └── Design a Key-Value Store
│
├── 03 Read-Heavy Lookups
│ ├── Design TinyURL / Bit ly
│ ├── Design Pastebin
│ ├── Design a Typeahead / Autocomplete
│ ├── Design a Web Crawler
│ └── Design a CDN
│
├── 04 Social & Feeds
│ ├── Design Twitter / News Feed
│ ├── Fan-out on Write vs Fan-out on Read
│ ├── Design Instagram (Photos + Feed)
│ ├── Design Facebook / LinkedIn Timeline
│ └── Celebrity / Hot-Key Problem
│
├── 05 Realtime & Chat
│ ├── Design WhatsApp / Messenger
│ ├── Design Slack / Discord
│ ├── WebSockets vs Long Polling vs SSE
│ ├── Online Presence & Delivery Receipts
│ └── Design a Notification System
│
├── 06 Media & Streaming
│ ├── Design YouTube
│ ├── Design Netflix
│ ├── Design Spotify
│ ├── Upload, Transcode & Adaptive Bitrate
│ └── Design TikTok / Short Video Feed
│
├── 07 Location & Marketplaces
│ ├── Design Uber / Lyft
│ ├── Design Yelp / Nearby Search
│ ├── Design DoorDash
│ ├── Geohash, Quadtree & Matching
│ └── Design Airbnb / Hotel Reservation
│
├── 08 Storage & Sync
│ ├── Design Dropbox / Google Drive
│ ├── Design Google Docs (Collab Editing)
│ ├── Chunking, Dedup & Conflict Resolution
│ ├── Design S3-style Object Storage
│ └── Design a Distributed Message Queue
│
├── 09 Money & Contention
│ ├── Design a Payment System
│ ├── Design Ticketmaster (Hot Inventory)
│ ├── Design a Digital Wallet
│ ├── Idempotency, Ledger & Reconciliation
│ └── Design an Ad Click Aggregator
│
├── 10 Senior / Staff Depth
│ ├── Design a Stock Exchange / Leaderboard
│ ├── Design a Metrics & Monitoring System
│ ├── Design a Distributed Lock / Scheduler
│ ├── Design Dynamo-style Storage
│ └── Design an LLM / RAG Serving Path
│
└── 11 LLD Companions Often Paired With HLD
├── Design a Parking Lot
├── Design an Elevator System
├── Design a Chess / Card Game
├── Design an LRU Cache
└── Design a Rate Limiter (Class Design)
Start with TinyURL, rate limiter, news feed, chat, and YouTube if you're an absolute beginner.

Poincaré retweeted

很多模型标的 1M 上下文,真正训过的可能只有 256k 左右,剩下的是推理时外推出来的。
长上下文是分阶段训的。预训练大部分时间只用 4k 到 8k 的短序列,后期再单独加一段长文本训练,把窗口拉到 128k 或 256k,这才是模型真正见过的长度。再往上,很多靠 YaRN 这类位置编码插值,推理时把位置压缩一下,让模型能吃下比训练时更长的输入。开源模型看 config 最清楚,比如 Qwen3.8-27B 原生 262,144,官方写的是可以扩展到 1M。闭源模型基本不公开训练长度,只能看评测。
能塞进去和能用好是两回事。Google 发 Gemini 4 Argon 时自己跑了一张 GraphWalks 的表,在长文本里遍历图结构,128k 以内 → 256k 到 1M:
Gemini 4 Argon 99.7 → 84.2
GPT-6 Astra 98.7 → 71.8
Claude Opus 5.5 90.6 → 66.8
Claude Fable 5.1 91.4 → 65.0
128k 以内大家都很高,一过 256k 就拉开了。最稳的 Argon 也掉了 15 个点,Astra 和 Fable 都掉了 26 个点左右。
再看 OpenAI 的 MRCR v2 8-needle,在长文本里找回第 n 条指定内容。Astra 在 512k 到 1M 还有 96.3%,上一代 GPT-5.6 Sol 只有 73.8%。老模型就更惨了,GPT-5.4 到 512k 到 1M 只剩 36.6%,Gemini 3.1 Pro 128k 时 84.9%,到 1M 直接 26.3%。DeepSeek V4 256k 以内还有 82% 以上,到 1M 掉到 59%。
还有个挺有意思的点,同一个 Astra,MRCR 在 1M 有 96.3%,GraphWalks 在 256k 到 1M 只有 71.8%。在长文本里找东西和在长文本里推理是两种能力,标称 1M 只能说明它塞得进去。
Poincaré retweeted

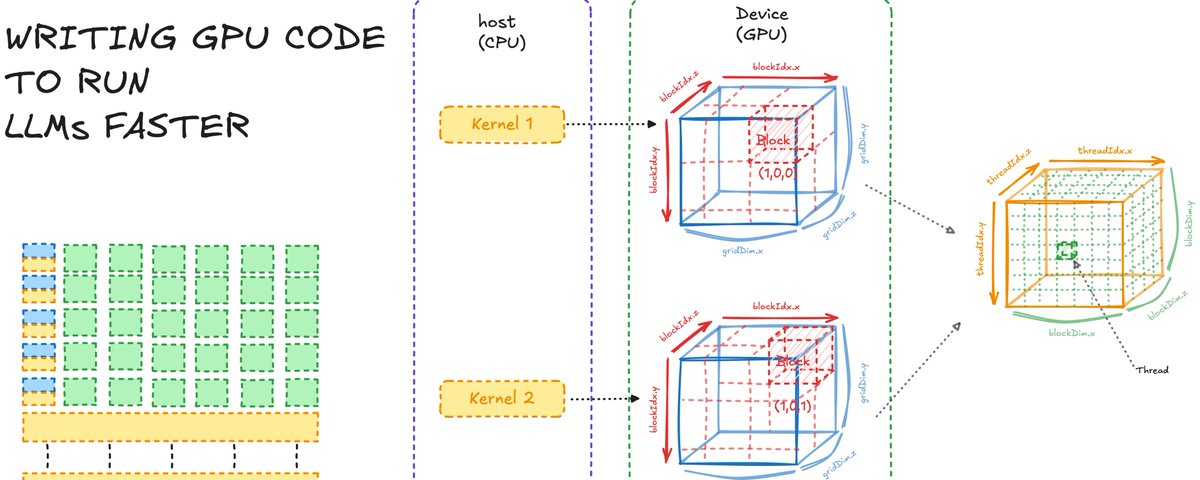
Took the time and wrote down everything I have been learning about GPUs and CUDA. Consider checking it out!
Poincaré retweeted

整理了 500+ 篇 ML 论文解析笔记:从 Transformer、BERT 到最新的推理模型,按主题分类,每篇一句话讲清核心思想,方便查阅 👇
注: 列表是中文版。具体文章是英文。
github.com/lukeTheNeuromance…


Poincaré retweeted

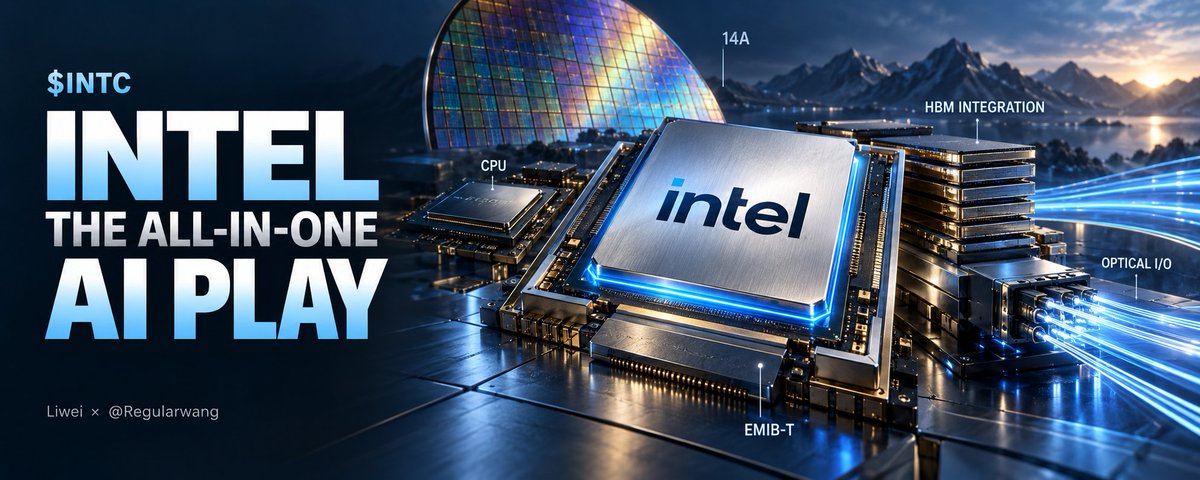
Meta’s Muse is reigniting the CPU trade. $TSM’s CoWoS bottleneck is opening a window for Intel’s EMIB-T.
Liwei and @regularwang break down the technology behind Intel’s all-in-one AI play, from CPUs and EMIB-T to 14A and optical I/O.



Poincaré retweeted

This is the part 2 of Everything About Memory Allocators, in this we are going to discuss about malloc and free

Poincaré retweeted

真的别迷信 io_uring 之前我测试过 io_uring 能否提升 udp 发送的吞吐量:发现延迟和吞吐其实和 sendmmsg 差不多,而 sendmmsg + GSO 还可以更快,可惜我网卡不支持打开 GSO 直接发不出去。


今天看了一篇极其精彩的性能翻车实战:
流媒体数据巨头 Conviva 把自研 Rust 引擎里的 mmap 换成 io_uring,结果直接慢了 60% 🤡
背景是他们每天跑数万亿事件分析,高并发下 mmap 导致 Linux 内核的 Page Cache 严重互掐,缺页异常(Page Fault)和锁竞争把 CPU 彻底耗尽。
大家都说 io_uring + O_DIRECT 是现代 Linux 的性能救星,理论上能吃满他们 32 块 NVMe 跑出 21GB/s 的极致吞吐。
结果他们团队实测下来,现实狠狠打了脸:
1. 主要缺页(Major fault)确实暴跌 35 倍,Page Cache 成功绕过去了。
2. 但总查询时间直接从 13 秒拉长到了 21 秒。
3. 罪魁祸首:次要缺页(Minor fault)暴涨 8 倍,冲到 860 万次!
mmap 虽然并发锁多,但它是惰性(Lazy)零拷贝;一旦换成异步 Direct I/O,应用层得提前在用户态分配大量缓冲区。在没有精细化内存池复用的情况下,光是频繁开辟内存和填零(Zeroing),开销就彻底把机器拖垮了。
最真实的系统工程教训:
别迷信所谓的技术“银弹”。你以为甩掉了内核帮做的事,其实只是把复杂度全转移回了应用层,擦屁股的成本可能更高。
你在生产环境里见过哪些“换上最牛架构,反而被反噬”的翻车现场?

Poincaré retweeted

今天看了一篇极其精彩的性能翻车实战:
流媒体数据巨头 Conviva 把自研 Rust 引擎里的 mmap 换成 io_uring,结果直接慢了 60% 🤡
背景是他们每天跑数万亿事件分析,高并发下 mmap 导致 Linux 内核的 Page Cache 严重互掐,缺页异常(Page Fault)和锁竞争把 CPU 彻底耗尽。
大家都说 io_uring + O_DIRECT 是现代 Linux 的性能救星,理论上能吃满他们 32 块 NVMe 跑出 21GB/s 的极致吞吐。
结果他们团队实测下来,现实狠狠打了脸:
1. 主要缺页(Major fault)确实暴跌 35 倍,Page Cache 成功绕过去了。
2. 但总查询时间直接从 13 秒拉长到了 21 秒。
3. 罪魁祸首:次要缺页(Minor fault)暴涨 8 倍,冲到 860 万次!
mmap 虽然并发锁多,但它是惰性(Lazy)零拷贝;一旦换成异步 Direct I/O,应用层得提前在用户态分配大量缓冲区。在没有精细化内存池复用的情况下,光是频繁开辟内存和填零(Zeroing),开销就彻底把机器拖垮了。
最真实的系统工程教训:
别迷信所谓的技术“银弹”。你以为甩掉了内核帮做的事,其实只是把复杂度全转移回了应用层,擦屁股的成本可能更高。
你在生产环境里见过哪些“换上最牛架构,反而被反噬”的翻车现场?
Poincaré retweeted
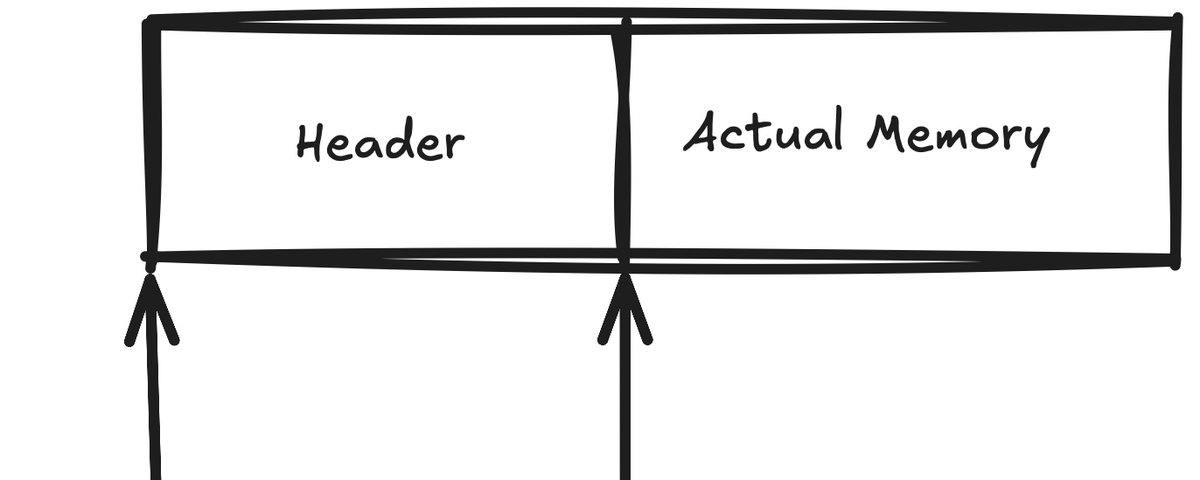
I wrote a walkthrough of implementing a basic memory allocator in C with headers, free lists, sbrk(), alignment, and follow up articles on the the core allocation functions.

Poincaré retweeted

最近有很多关于 RSI(Recursive Self-Improvement,递归自我改进)的讨论,也让大家开始担心,AI 会不会不断升级自己,最后超出人的控制
我周末集中看了一批 RSI 2026 年的论文和公开项目,想把几个问题讲清楚:现在到底发展到了哪一步,业界 popular 的讨论是什么,以及我们普通人能怎么用。最后我会给大家一个可以用来直接给 AI 实现初步 RSI 的 Prompt
这次按方向来聊,论文和项目放在对应段落,大家可以收藏下来慢慢看
1/ 先分清楚,大家说的“自我改进”,有三件不同的事
第一件,AI 根据反馈,把当前任务再做一遍。
第二件,它把有效经验、工具或工作流程留下来,下一次任务也能用上。
第三件,它进一步改进“下一轮怎么学习、怎么做实验、怎么选方案”这套方法。
越往后,接手的研发决策越多。9 月 10 日发表的的《The Last AI Built by Humans》把这些自主范围拆成了执行、策略、经验获取、环境适应和元改进几层,适合当阅读地图 arxiv.org/abs/2609.11873
2/ 今年一条很密集方向研究线,是让 AI 改自己的 Harness
Harness 可以理解为模型周围那套实际干活的系统:读哪些文件、给模型看什么上下文、怎么调用工具、失败后怎么恢复、什么时候算完成。
今年 3 月的 Meta-Harness,6 月首发、8 月更新的 Self-Harness,以及 7 月底的 DarwinX (Salesforce),都在研究怎样把这套系统交给自动实验来优化
3/ 另一条已经出现企业内部应用的路线,是把人的纠错变成持久经验
今年 1 月的 MemRL,把经验和“这条经验实际有多管用”一起保存。下次先找相关经验,再根据使用效果挑选,而不只是找文字最相似的记录
arxiv.org/abs/2601.03192
到了 9 月 2 日,Meta 公开了一个更贴近日常工作的内部案例:专家纠正 Agent 后,系统会判断错误来自知识缺口还是处理流程,把纠错转成文件修改,重放原来的问题、跑回归测试,再交专家审核。
通过后,这次失败还会进入以后的测试集。这是 Meta 在特定专业领域的内部实践
engineering.fb.com/2026/09/0…
对我们普通用户来说,这一条就很有用了, 人的一次纠错,开始有机会变成后续任务都能使用的改进
回到关键问题,我觉得今年这些工作的共同价值,是让我们开始认真维护一个会积累经验的系统。所以我们现在可以怎么用?
篇幅有限,我把一个我们都能用上的效仿 RSI 的基础 prompt 放在评论区里,
我最近也在观察,每次任务留下什么,每次纠错改到哪里,下一次能否因此做得更好,这些都已经可以在自己的工作里动手验证了。
为了防杠,我得说明一下:这三个方向只是工程向的,硅谷大佬们担心的更多是研究向的内容。
这些内容比较硬核,研究向 RSI我会在后面帖子里单独去聊


这个周末我认为最重要的一件事情:
OpenAI、Anthropic、xAI在同一个周末集体来了表态,一致同意并呼吁放慢 AI 的发展速度……
Dario 已经在原文里点名:AI 正在越来越多地参与研发下一代 AI。他担心这种加速,会超过人类理解和控制模型的速度
OpenAI 甚至说:“如果真到了那一步,为了拯救人类,我们愿意把自己的 GPU 都熔掉。”
通常这类 frontier lab 的管理层会比我们提前看到新一代模型的能力。显然,AI 已经突破了某个临界点,而且事情严重到把所有人都吓住了
这个或许是我们过度解读了。但有一点是肯定的,无论如何呼吁,整个世界这么多 lab 一定不会完全步调统一、暂缓步伐