奔赴世间无人踏足的旷野

Joined April 2026
最后联系了 AMD 售后后,获得了一块新的 9800X3D…更换后问题解决了 还是第一次遇到 CPU 问题🤔
于是乎尝试联系了主板的售后,换了个板子后发现依旧存在现象。 那么已经交替验证过内存,拆除了独显输出走集显,拔除了非必要外设,已经更换了主板… 最后问题的矛头应该指向是 AMD-9800X3D 内出了问题🤔
37
于是乎尝试联系了主板的售后,换了个板子后发现依旧存在现象。 那么已经交替验证过内存,拆除了独显输出走集显,拔除了非必要外设,已经更换了主板… 最后问题的矛头应该指向是 AMD-9800X3D 内出了问题🤔
好吧…看上去这个问题又出现了…..
1
115
好吧…看上去这个问题又出现了…..
这几天被接在独显输出到显示器上,启动时候卡 VGA 白灯 code 62 折腾有点麻了… 将 HDMI 接到主板走集显输出就没问题,如果是独显输出的情况下概率卡在这个节点,需要多次 reset 后,提示 POST failed 进 BIOS 才能正常启动 一开始以为是显卡坏了,但是集显启动的时候发现独显依旧正常…排查了一圈后锁定在 BIOS 启动里的 fastboot,这玩意儿切换到 normal boot 后看上去问题就解决了… 配置是 9800X3D + X870E +5070ti
1
126
这几天被接在独显输出到显示器上,启动时候卡 VGA 白灯 code 62 折腾有点麻了… 将 HDMI 接到主板走集显输出就没问题,如果是独显输出的情况下概率卡在这个节点,需要多次 reset 后,提示 POST failed 进 BIOS 才能正常启动 一开始以为是显卡坏了,但是集显启动的时候发现独显依旧正常…排查了一圈后锁定在 BIOS 启动里的 fastboot,这玩意儿切换到 normal boot 后看上去问题就解决了… 配置是 9800X3D + X870E +5070ti
1
116
Vibe Coding 多了,回头看代码发现怎么可读性那么差🥲
35
好友中午反馈 Peakmon 有一些使用体验的可优化项,晚上到家就马上更改出版本了... 超快的敏捷开发...
41
然后一天进步一点,比如说...从 0.3 t/s 提升到 3.0t/s!
先简单做个 qwen3.8-flash-next 的适配... 就是现在看上去性能还有待优化
1
43
先简单做个 qwen3.8-flash-next 的适配... 就是现在看上去性能还有待优化
1
2
161
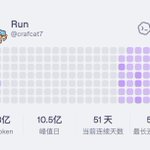
100 亿达成!
105
想适配 Kimi K3... 但是发现现有的盘空间都不够放完整模型了😢
2
232
我把 example 使用体验优化了下,现在它的交互体验更像是一个本地模型聊天器 可以复用上下文,配置启动时候资源分配(如果不会配置的话,默认会按照设备能力 Auto Tune) 同时也可以支持 /state 、/compact 等可配参数)
192
太好了,上周做的 DSV4 flash 的适配可以直接用在 DeepSeek V4 Flash 0731 的版本上 5070ti 跑 DeepSeek V4 flash )
3
1
10
3,269
这几天折腾了下 新适配了 qwen3.6-35b-a3b-support 并且引入了一堆的优化,例如:MXFP4 Expert Artifact、Eager Expert 驻留 在当前的设备环境上跑起来看上去表现还不错 这两天看下最近更新的 Deepseek v4 flash 0731 版本能不能在现有支持的 Deepseek v4 flash 适配器的场景下跑起来🤔
209
补充了下 DSpark 的支持,当前实现还没充分发挥 DSpark 的全部能力.... 可能是当前的矩阵测试内并没有让 DSpark 成功加速到任何 Token,但是又承担了 DSpark 带来的额外成本,同时在 4 Session 场景下还失去了 staged batching.... 后续可以考虑换换设备再重新评估下 我还是太菜了(
110
现已支持 DeepSeek-V4-Flash-DSpark! 在本轮工作中引入了很多很多的优化,也尝试了不少的方向来优化该架构,旨在能为边缘端跑起 MoE。 13B 的激活参数量确实跑起来有些吃力 虽然现在 5070ti + 9800X3D 在 DeepSeek-V4-Flash-DSpark 表现力有限,但能跑起来就是一大步)
1
187
ncnn-MoE-Runtime 周末总结(Codex 帮大忙...) 测试环境 R7 9800X3D / 31.14GiB 内存 / RTX5070Ti 16G 混合推理架构:Vulkan GPU 稠密 + Attention,CPU 执行 MoE Expert Hybrid Runtime 吞吐 (token/s): • 20B 32tok:cold 14.10 / warm 14.85 • 20B 256tok:cold 17.07 / warm 16.80 • 120B 32tok 2S:cold 5.28 / warm 10.92 • 120B 256tok 2S:cold 9.87 / warm 10.29 做了一堆的优化工作,看上去还有提升的空间 接下来将接入更多的 MoE 模型!
1
235