

01年 | AI 时代超级个体 | Dream Big 🧑🎓Tongji & HKUST & Fintech Phd 🚀 Building @NomosBuilder @PaperList_AI @seris_im
Joined January 2024
- Tweets129
- Following207
- Followers86
- Likes207


Pinned Tweet
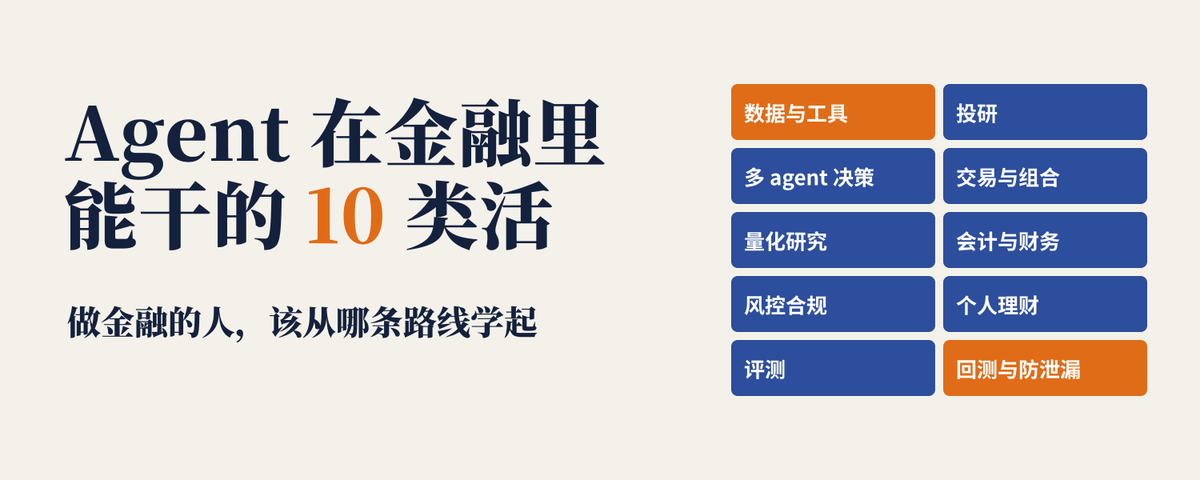
数据与工具是finance agent的核心壁垒之一,也是据我所知所有做finance agent的大公司都在做的事情。
为什么是所有大公司都在做?因为小公司可以做工具,但是不好做数据。我曾做过系统性的finance agent数据体系搭建,按照我的理解,这里面有两个核心难点:
1. 对于好的finance agent,数据不仅要新,更要全。
crypto/美股/港股/A股都要做吧。A/H/美行情 K 线以外;财务、基金、ETF、指数、期货、期权、可转债要看;宏观和资金流要关注;机构持仓、股东变动、权益披露也要做;研报观点,社媒舆情要包括;宏观指标 + 政策监管事件流、三大报表、公告全文 + 财报电话会文本肯定也要让agent知道;更进一步的,产业链、供应商联动信号也是很重要的信息
意味着包括但不限于这些数据都要懂、都要接:Tushare、Massive、Yahoo Finance、巨潮资讯 + 东方财富、AKShare、Finnhub、SEC EDGAR、Hang Seng Investment。。。
二流的agent看k线看价格,一流的agent看世界。当所有的finance agent在loop、工具、memory设计都趋同的时候,数据才是能体现出agent能力差距的核心壁垒。
2. 数据——到给agent用的工具——到支持大量agent并发使用的数据服务,每一步都有门槛。
把 Tushare、Massive、SEC。。。这些源采进来,写成可核对的标准事实,过了这一步,人可以查库,但 Agent 还不能用。
Agent 不会自己读表。它需要少量、语义清楚、结果有界的工具。不可以用人类的有限设计认知去限制agent的能力,不应该给agent修路,而是应该给agent造铲子。如何设计skill和工具是一门艺术。
一个 Agent 试通,和成千上万个 Agent 同时查同一天行情、公告、财务,不是同一个问题。上游有限频和授权,数据库有连接和查询成本,按需回源(比如美股分钟、逐笔)不能让每个 Agent 都打到供应商。意味着缓存、配额、隔离、审计都要做,不是把接口包成 function call 就结束。
工具层大家都会做,而且会越做越像。真正拉开差距的,是你能不能把又新又全的数据收成一套事实,再让大量 Agent 并发用,还用得稳、用得起。

aowang retweeted

Claude writes about 90% of Claude Code's code.
From June to September, merged PRs more than doubled while the share reverted fell by more than 40%.
We wrote about how we changed code review to get there, and how to adopt it:
claude.dev/blog/solving-code…


就大陆来说,社会对学生的评价体系可以转变(like 从论文数量为王,转变为评判工作的真实影响力)
但是教育体制对学校/教师的评价体系是很难短期转变的。
未来一定会出现一段时间的错配期。
未来科研的范式需要尽快被重新定义
原本的H2H模型已经快进到了H2A A2H A2A了
我们要怎么样去跟 AI 进行交互?AI 与 AI 之间又要怎么样进行交互?AI 和人之间又要进行怎么样交互?这些目前都没有标准,所以才会出现晓辉博士提到的这么几个问题
以前的古法科研模式是一定要进入历史的坟墓的,因为它已经不适应当代人工智能快速发展所需要所适配的要求,未来导师跟学生之间的价值是头脑风暴。只要做科研的人都知道头脑风暴的价值有多么的重要
很多时候推动人类社会进步的东西,往往来自于人类与人类之间的讨论交流。人工智能在这个领域里边是作为一个纠偏,避免人类思维过度跳跃导致出现的方向偏移。同时可以利用人工智能帮助我们去挖掘某些由于我们人类思维过分跳跃导致的遗漏的地方。
我个人的看法,未来整个科研模式的变化,会出现以下的趋势⬇️
今天被问了个问题:agent 写代码越来越多,代码屎山怎么办?
就去翻了翻 Anthropic、OpenAI、Stripe 这些大厂公开讲过的做法。供自己复盘,也供大家参考
简单来说,其实就三件事:规矩写成 lint,让 agent 自己验,合并后能撤回。
一、规矩写成 lint
agent 有个毛病,特别爱照抄现有代码。仓库里有一个烂写法,它就当范本,很快复制成十个。所以靠 review 时提醒它没用,得让烂代码根本过不了 CI。
同一条意见在 review 里写第二遍,就是自动化没做到位,该让 Claude 把它写成 lint。定死每个功能一个文件夹、一件事只有一种写法,违规的直接拦下。
二、让 agent 自己验
规矩只能拦住写法上的错,功能对不对还得有人验。以前这个人是工程师自己:看日志、看页面、再转述给 AI。Lauren 管这叫「人肉中转站」,她在 Cursor 写的第一个 skill 就是验证,让 AI 自己把程序跑起来,像用户一样点一遍。
Anthropic 做得更重:单测、浏览器、e2e、每天跑的 fuzzer、自动安全审查全配上。原型可以当黑箱,生产代码对 Agent 的要求应该比对人更高。
三、合并后能撤回
前两件做好了,才敢不逐个看 PR。让 agent 自己查、自己合,人只做抽查,不对就 revert,再补一条规矩。抽查主要是找新的错误模式,找到一种就用 lint 消灭一类。
能撤回的前提是隔离。每个 agent 跑在单独的环境里,改坏了也只坏它自己那一块。
能直接装的 skill:
pstack /correct 把你反复纠正的错固化成规则,/create-verification-skill 给项目生成验证 github.com/cursor/plugins/tr…
mattpocock/skills code-review 分两路,一路查规范,一路查需求 github.com/mattpocock/skills
addyosmani/agent-skills 专抓 agent 偷偷关检查 github.com/addyosmani/agent-…
Anthropic 官方 code-review 4 个 agent 并行审 github.com/anthropics/claude…
不 Review PR 不吓人。
吓人的是:测试、沙箱、回滚全没建好,就学人家晚上自动 merge。
那不叫 Agent,叫赌狗/许愿池。

我记得半年前我说自己不怎么 Review PR 了,评论区很多人不认同,觉得这样不靠谱。现在再看,不 Review PR 的人越来越多。比如我刚看的这期播客,在 SpaceXAI 做 Grok Bot 的 Lauren Tan,一个月合并 2500 个 PR,也是不逐个 Review 的:晚上让 AI 自己检查、自己合并,第二天早上她再抽查。
不 Review 不等于不管质量,她靠另外两个办法来保证:
一是让 AI 能像真人用户一样把程序用一遍,自己发现问题;
二是给代码定下很多规矩,让 AI 很难写出烂代码。
她把自己这套做法写成了一组 Skill,公开了出来,叫 pstack。
顺便说一下,这期播客的主持人 Matt Pocock 原本是知名的编程课讲师,他公开的技能库在代码托管网站 GitHub 上有二十多万个星标,是最受欢迎的技能库之一,所以这期算是两位同行对谈。Lauren 之前在 Meta 做网页开发框架 React,今年 3 月加入 AI 编程工具公司 Cursor;Cursor 今年 8 月被 SpaceX 收购,并入旗下的 AI 部门 SpaceXAI。
根据播客的内容,我把 Lauren 的这套做法简单总结一下,我自己的点评在结尾处。
一、先让 AI 能检查自己干的活
Lauren 说,就算不用她的 pstack,每个人最该有的一项技能也是“验证”:给 AI “手和眼睛”,让它能把自己写的程序跑起来,像普通用户一样点一遍,看看结果对不对。
这是她吃过亏之后得出的结论。今年 4 月她在 Cursor 解决一个窗口卡顿的问题,一开始全靠手工:她自己去看各种性能数据,再把看到的转述给 AI,AI 改完她再去看。她形容自己成了 AI 和检测工具之间的“人肉中转站”。她在 Cursor 写的第一个技能就是验证。在这之前,AI 看不到自己改动的效果,只能等她来回传话;有了验证,AI 可以自己改、自己看结果、不满意再改,一轮一轮往下做,不需要她守着。现在她所在的团队里每个产品都配有这样的验证技能,全团队都在用。
做这个技能时她还总结出一条原则:工作里有的部分需要动脑判断,有的部分只是照章办事,照章办事的部分应该写成固定的程序,只把需要判断的留给 AI。起因是她发现,每个 AI 在检查前都要自己从头写一遍检查用的小程序,各写各的,有的能用有的不能用,用完就扔,又慢又浪费。她把这部分做成一个现成的工具,所有 AI 直接调用。
二、AI 反复犯的错,去改规矩,不去改 AI
Lauren 不喜欢“软件工厂”这个流行说法,她更愿意把自己的工作比作经营一家米其林餐厅的后厨。主厨不用亲手做每道菜,但要安排好整个厨房:食材什么时候进、怎么存,每个人用什么工具,菜按什么流程出。工程师现在也一样,不再亲手写代码,却仍然要对结果负责。她认为工程师现在最重要的工作就是把这个“厨房”布置好。没花时间布置的人,信不过 AI 的产出,只能盯着它一步步干,忙到没空改进工具,就像一直拿钝刀切菜。
她举了自己的例子。Grok Bot 最早几版的代码挤在八个巨大的文件里,每个至少一万行,AI 加新功能时就接着往里塞,越塞越乱。她后来定了规矩:每个功能必须放在自己单独的文件夹里,做一件事只允许一种写法,不合规矩的代码会被自动检查拦下来。这样 AI 加功能时不用多想,按规矩放就行。她的习惯是一直观察 AI 在哪里出错,每看到一次就问自己:能不能加一条规矩,让这种错以后根本写不出来。
不逐个检查,靠的也是这套办法。她说,开了几家餐厅的老板不可能尝每一道菜,只能抽查。她每天挑一些改动仔细看,如果只是偶然出错就算了;如果好几个 AI 都在走同一条捷径,说明该改的是规矩和工具。她的 pstack 里有一个全自动模式:每次改动都会派出一批专门负责检查的 AI,把程序打开到处点,找出问题就自己修,反复到没问题再合并。早上她翻一遍改动记录,发现不对就撤回,再补一条新规矩。
她说第一次让 AI 整夜自己合并代码时很害怕,担心半夜把线上产品弄坏,现在反而睡得更好。她也提醒,走到这一步很难,要花大量时间观察和调整,装上 pstack 并不能直接做到。Matt 问,如果改动是没法撤回的,比如会丢数据,或者是医疗、金融这类领域怎么办?她说这取决于工作成果能不能被程序自动检查,软件大部分可以,很难自动检查的领域就很难这样做,她自己也没有答案。
三、2500 次改动从哪来:她不再当传话的人
这 2500 次改动并不是她发起了 2500 次对话。用户反馈的问题散落在聊天工具、邮件和社交媒体上,以前要靠她自己去看,再转述给 AI。现在她让 Grok Bot 来盯这些渠道。Grok Bot 是 SpaceXAI 今年 8 月推出的产品,是能登录邮箱、聊天工具等各种应用、替人办事的 AI 智能体。它一发现新的问题反馈,就转给一个负责“协调”的 AI。这个协调者自己不写代码,只负责拆分任务、分派给其他 AI、盯进度,相当于她的后厨主管。
为什么不直接一个问题派一个 AI 去修?她说,一批反馈往往出自同一个根源,分开修会重复劳动,也看不出真正的毛病在哪,放在一起看才看得出来。她现在同时开着十多个这样的协调者,各管一摊。她一直在问自己一个问题:哪一步还卡在我身上,AI 为什么非得来问我?然后想办法教 AI 自己去拿到真实的信息。
她也说明,2500 次改动里新功能不占多数,很多是整理代码这类维护工作。
四、懂行的人更吃香,哪怕不会写代码
Matt 问,大家都靠 AI 了,专业知识是不是不值钱了?Lauren 的看法相反。模型越来越强,卡住人的已经变成你能不能把自己想要什么讲清楚。所以她认为,医生、律师这类在某个领域懂得很深的人,只要稍微懂一点技术、会用 AI 智能体,就能做出很好的产品。
两人都认为,技能没有什么神秘的,就是把自己的做事流程写成文字。Lauren 建议回头翻自己和 AI 的聊天记录,找出那些自己反复纠正、反复插手的地方,把它们写成技能或规矩。别人的技能可以拿来拼着用,但每个人最后都该有一套自己的,就像厨师换了餐厅也会带着自己的刀。
五、最后
很多人看完这期访谈会觉得,以后自己也可以像 Lauren 那样不 Review PR 了,装上她的 Skill,让模型帮忙验证一下就行。我自己现在的做法和她差不多,每天也有大量 PR,也不 Review。但我的建议是先别急着学她怎么做,先弄明白她凭什么能这么做。
1. 你能不能用上最好的模型,Token 够不够
在用上 Fable 和 Opus 5.5 之前,AI 写的代码我是不太放心的;用上之后,我才真的敢让 AI 去写而不怎么 Review。模型能力很重要,能力没到,就先别想这件事。
还有成本。像我这样没有大公司可以依靠的,得自己掏钱买 2 个 Claude Max 20x 账号,还得省着用。Lauren 在大公司,不用考虑 Token 消耗,全程用最好的模型、开最快的模式都没问题。
不过也别着急。Fable 这个级别的模型,也许半年以后就能像现在的 DeepSeek V4.1 Flash 一样便宜,人人用得起。梁圣加油。
2. 不能完全依赖 AI 的验证
哪怕现在 GPT-6 操作电脑的水平已经超过真人了,让它去做验证,也只能替代一部分,不能真的全交给它,自己还是要看。
可以做的是把那些手动重复做的事情,一点点沉淀成 Skill 和自动化脚本,把体力活解放出去。
3. 方向得靠你自己的专业来指
再聪明的 AI,也没办法替你决定该往哪个方向走。就像给车子装上火箭发动机,也得你来告诉它往哪开,走偏了要及时调整,不然跑得再快也是南辕北辙。
做软件也一样。你不能指望一句提示词做出一个淘宝。你得先做一个能发商品、能浏览的小网站,再加上用户注册,还得区分买家和卖家,然后是支付和安全,功能做完了还要扛得住很多人同时用。稍微复杂一点的软件,都没法完全依赖 AI,要人去拆解、规划,分成一个个小版本、小里程碑,做完要验证,出现偏差要重新指方向。甚至做着做着,你自己的想法都变了,AI 不可能知道你真正想要的是什么。
所以就像播客里说的:模型越来越强,卡住人的已经变成你能不能把自己想要什么讲清楚。
4. 不一定要用他们的 Skill,但要学着把事情交给 Agent 去做
Matt 和 Lauren 的 Skill 都很受欢迎,但你不一定要用。
一方面,软件工程的基础知识,现在的模型已经学得很好了。Lauren 在播客里也说,去年的 Skill 还得写清楚具体该敲哪条命令,现在这些都可以删掉,只留流程步骤,Skill 会越写越短。
另一方面,他们的开发流程和环境,跟你的很可能不一样。Lauren 的 Skill 都是从她自己的工作里总结出来的:验证技能来自她当“人肉中转站”的那段日子;另一个叫 recall 的技能,来自她每次开新对话,都得把上一个对话里的背景再讲一遍。
所以更重要的是从你自己每天的开发流程出发。那些还要你手动操作的环节,尽可能交给 Agent 去做;Agent 做顺了,再把它的操作过程沉淀成 Skill,反复迭代优化。
如果不知道从哪里下手的话,可以参考 Lauren 的办法:翻自己和 AI 的聊天记录,找那些你反复纠正、反复插手的地方。这样迭代出来的 Skill 才真正适合你,用她的话说,每个厨师都该有一套自己的刀。
Jev is the one calling the trades, and it has to keep calling them.
Each round the desk hands it the tape: the book, the last prints, the position we're already in. Jev comes back with one typed call, long or short. The desk fills that on paper, then asks again. Call, fill, call, fill. Offline PnL stays on the same screen, so you can see what the decisions did to the money.
That's the test I wanted. A model can write you a view once. Trading only counts if it will decide again on the next print, and the one after that. I put Jev in that loop and left the result up.

After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI?
I’ve spent the last 2 years in stealth building a new way to train models (RLCD), and a new type of frontier AI model that we are releasing today: Jev
• 20-200x faster
• 40-400x cheaper (w/ output tokens free)
• Frontier composable intelligence optimized for decisions
AFAICT the shortest path to AI-based economic revolution


Thanks @jarrodwatts for open sourcing a Jev trader. Opening this desk too. Thin frontend around the same kind of loop: tape, typed call, fill. Read how the call is shaped, point it at another market, or change how often it decides.