



Maya是个好项目。

Getting this project out and about is extremely hard work, please consider sending some support via buymeacoffee.com/peasantsmit…

DHH批评中国app粗糙这件事,暴露了推特里科技圈的粉红程度。
我认为在中国的文化背景下,粉红,社达,皇汉男拳,登味,这些标签基本是可以划等号的。
平时讨论科技话题的时候很容易让人忘掉这些人底色的价值观。但就这么简单批评下中国的APP,科技圈一股子‘我可以骂我妈,但你不能骂’,‘不全然赞美我,真是不知好歹’的那种高中生小粉红劲就上来了。
最后一个暴论总结,推特简中团体标签的平均三观排位,有误伤,但不多。由最低级开始,币圈web3,川粉,金融美股,IT。
对于AI目前的硬件投资,有两个思路。
一是投资硬件本身。比如之前我觉得5090还有空间,4200美刀左右买了三个。目前看还是保守了。
另一个是投资自己。买M5 Ultra 256g*2,买pro 6000*4,哪怕买DGX Spark*4。资产角度大概率没有升值空间了。但是这些设备让人能有不同的体验和视角,让试验能轻松达到一般玩家达不到的门槛。这种经验是有价值的。能获得多大的回报,那个杠杆就看你自己了。
今天在家里长脸了。
妻子过两天参加一个workshop,担心语言问题。网上的实时翻译软件要么额度有限,要么动辄掉线。都不靠谱。
嘿嘿,直接5分钟vibe一个小app,5090架起来whisper+qwen 27b。体感非常不错。qwen27b在这种实时的场景下完全无压力,翻译延迟200毫秒左右,质量也交代的过去。
调整完几次小功能,妻子这边验收通过,还被夸了。本地LLM万岁!

Strata 出现的一个被undervalue的好处,就是减少了玩家的选择焦虑。
之前我反复在vllm,sglang,llamacpp几个引擎切换。不同的设备,不同的模型,不同的精度,都需要试验匹配的引擎。各种成本都挺高的。
现在就可以无脑用strata就行了。这玩意大有一统江湖之势。
我只说直觉,我对Sipeed有非常不好的感觉。
正式亮相不说报价,只是含糊的说是DGX Spark的一半,是DGX Spark首发4000美元的一半吗?
另外,对比速度的提升,20-30%的提升意义真的不大,太多干扰因素。
更重要的是,测试比较的模型居然是27b。这就像是说,我们生产了一个自行车,这个自行车在水里骑行的速度比另一家的自行车快喔。
从头到尾透漏着不透明,不真诚的宣传。我甚至不建议大家第一时间听评测的报告,大概率也是营销。慢慢看吧。

Please send this guy a Strix Halo, and preferably a couple of R9700s while you're at it. His Strata work really could help the AMD product community thrive. @AMD @ColbyCakesss @AzorFrank

Strix Halo is now officially supported 🥳
- AMD gpu improvements
- Multi GPU improvements (batching)
- Improvements on decode
- Turing improvements
- Intel Arc improvements
github.com/Niko1221/Strata/r…

我认真的觉得,与其把一些资金投入不可控的股票里,不如在这个时候投入到硬件上。
确实,现在的硬件贵的离谱。但试着这么想。我们现在就处在地理大发现的后期。我们已经发现了新大陆,我们已经看到真金白银被一船一船的运了回来。但这时候船变得非常贵。你会怎么办?
你可以等待,船价肯定不会一直走高,也非常有可能会暴跌。但一直等下去,就会错过这个黄金年代。所以,大胆的当一个船长,在你的能力范围内,选择自己喜欢的船只,组织自己的舰队。Explore the Uncharted Waters!
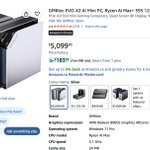
此时加拿大亚马逊的价格。dgx spark要9500刀。而395配上r9700,再加上额外的电源底座需要8000刀。后者有更好的性价比,表现,和有趣的玩法。
当然,更有性价比的是直接两个r9700配上128g内存,玩法搭配也非常丰富。跑qwen 27b可以玩tensor parallel,跑moe就可以玩strata。比单个5090有趣的多。


本Dgx Spark黑来还愿啦!
一直觉得Spark的钱远不如去买AI Max+ 395 外挂一个R9700。各种原因一直没能复现好lucebox的方案,但Starta这不就来了嘛!
R9700和395各自跑IQ3_S的量化,速度都是50+ t/s。哥俩挂在一起,一个负责快,一个负责大,直接干到80+ t/s。

Mac Studio Ultra M5,96g升级到256g,要4000美元。按之前M3估算,256g升级到512g就得要6000美元或者更多。狠狠心还是算了。打算买个256g的算了。认真搞技术,不需要最顶级的装备😭😭😭
Thanks @coldniko for taking my multi-GPU helper optimization codes, happy to contribute to the Strata community!
Here are a few observations from my testing.
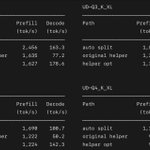
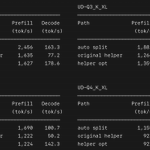
Strata offers several multi-GPU execution paths, with two main approaches: layer splitting and expert helpers. Auto split is a strong all-round option, especially for prefill. However, when more expert weights remain in system RAM, the optimized helper path can offer better decode throughput—but faster decode doesn’t always mean a faster total request.
Enable the optimized helper path with:
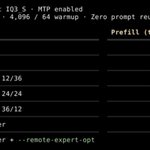
--expert-cache-device1 auto --remote-expert-opt
Use this instead of --layer-split auto.
Testing setup: Strata v0.1.39, 2× RTX 4090 with 24 GB VRAM each, 128GB RAM. All tests used MTP (--spec 4), --pcie-frac 0, and the same 31,400-token input with 2,048 output tokens. Results are medians of three runs after warmup, with zero prompt reuse.
Compared with auto split, helper opt’s decode advantage grew with the model’s weight footprint: from just +9% on IQ3_XXS to +25% on Q3_K_XL, reaching around +40% on bothnQ4 models. But prefill consistently favors auto split: it was 25–51% faster across all four models tested.
Overall, auto split is probably still the reliable choice for most everyday workloads. But personally, I prefer the heterogeneous helper approach—it’s just too much fun. LLM is great! Strata is great!
