

Software engineer building with AI Agents, LLMs, production code. Sharing what breaks along the way
Paris, France 🇫🇷
Joined July 2012
- Tweets8.6K
- Following102
- Followers9K
- Likes5.1K






RedOneX retweeted
وهنا بدأنا نشوف الـ Mods فعليا 😁
You Should Know يراقب مخرجات Claude وينبّهني للأشياء المهمة اللي ممكن تفوتني، خصوصًا في المهام الطويلة ( Mod رسمي من Anthropic )
● /plugin enable cc-plugin-you-should-know@builtin


شفت إعلان Anthropic عن الإضافات الجديدة في Claude Code، وأول سؤال جاء في بالي كان
"لحظة… Claude Code عنده أصلًا Skills وSubagents وHooks وCLAUDE.md وMCP وPlugins… فما الحاجة إلى Mods؟ 🤔"
وأعتقد أن كثيرًا منكم عنده نفس السؤال، لذلك هذا ما فهمته بعد البحث:
بشكل مبسط، كل واحدة من الأدوات الموجودة لها دور مختلف:
• CLAUDE.md
ملف تكتب فيه قواعد وتعليمات للمشروع، مثل طريقة كتابة الكود والقواعد التي يجب على Claude اتباعها.
• Skills
تعطي Claude طريقة جاهزة ومنظمة لتنفيذ مهمة معينة.
• Subagents
تسمح بتشغيل وكلاء متخصصين، مثل وكيل لمراجعة الأمان أو وكيل للاختبارات.
• Hooks
تسمح لك بتنفيذ كود عندما يحدث شيء معين، مثل قبل تشغيل أمر أو بعد تعديل ملف.
• MCP
يسمح بإضافة أدوات وخدمات خارجية يستطيع Claude استخدامها.
• Plugins
تجمع هذه الإضافات وتسمح بتثبيتها وتوزيعها.
طيب… ماذا تضيف Mods؟
هنا الفكرة تصبح مختلفة قليلًا.
الإضافات الجديدة تسمح لك ببناء ميزات تدخل في طريقة عمل Claude Code وواجهته نفسها، وليس فقط إعطاء Claude تعليمات أو إضافة أداة جديدة.
وهذا واضح جدًا من الأمثلة التي عرضتها Anthropic:
- Token Weather
يعرض لك مقدار ما استُخدم من مساحة السياق، وكيف تغير الاستخدام خلال آخر المحادثات.
- Blast Radius
إذا حاول Claude تنفيذ أمر خطير مثل:
rm -rf
git reset --hard
git push --force
يعترض الأمر ويعرض لك ما الذي يمكن أن يتأثر قبل تنفيذه.
وهنا ظهر لي الفرق:
الـ Hook يقول تقريبًا:
"عندما يحدث هذا الشيء، اسمح لي أن أنفذ كودًا."
أما الـ Mod فيمكن أن يقول:
"أريد أن أبني ميزة كاملة حول هذا الشيء."
يعني يمكن للإضافة أن تجمع مراقبة الأحداث + منطق خاص + حفظ معلومات + أوامر جديدة + واجهة جديدة، كلها في ميزة واحدة.
وهذا أيضًا جعلني أفكر في DeepSeek Harness
فكرته الأساسية أكثر اعتمادًا على أن أجزاء النظام نفسها قابلة للتركيب كإضافات، حتى أجزاء من تشغيل الوكيل نفسه.
Claude Code لم يتحول إلى نفس النموذج، لكن Mods تفتح طبقة جديدة ومهمة من التخصيص فوق النظام الموجود.
لذلك أراها تقريبًا هكذا:
CLAUDE.md ← ماذا يجب أن يعرف Claude عن المشروع
Skills ← كيف ينفذ مهمة معينة
Subagents ← وكلاء متخصصون لمهام معينة
Hooks ← ماذا أفعل عندما يحدث حدث معين
MCP ← ما الأدوات والخدمات التي يستطيع استخدامها
Plugins ← كيف أجمع هذه الإضافات وأثبتها
Mods ← كيف أبني ميزة جديدة داخل تجربة Claude Code نفسها
وهذا هو الجزء الذي وجدته مثيرًا فعلًا.
Mods ليست بديلًا عن Skills أو Hooks أو Subagents.
الفكرة أقرب إلى الانتقال من:
"كيف أستخدم Claude Code؟"
إلى:
"ماذا يمكنني أن أبني فوق Claude Code نفسه؟"

RedOneX retweeted
اشتراك Google AI صار مغري أكثر !
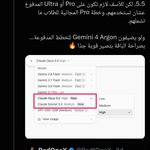
Antigravity أضاف Claude Opus 5.5 وSonnet 5.5، لكن للأسف لازم تكون على Pro أو Ultra المدفوع عشان تستخدمهم، وخطة Pro المجانية للطلاب ما تشملهم.
ولو يضيفون Gemini 4 Argon للخطط المدفوعة… بصراحة الباقة بتصير قوية جدًا 🔥


RedOneX retweeted
في شيء لاحظته الفترة الأخيرة وأعتقد كثير من الناس عندهم نفس السؤال:
ليش فجأة كل شركات الـ AI صارت تبني Agents 🚨؟
Grok عنده Bots، Meta عندها Muse، OpenAI عندها Dots، وغيرهم داخلين في نفس الاتجاه.
طيب... إذا عندك Model قوي، ليش ما تركز على تطوير الـ Model وخلاص؟ ليش كل هذا التركيز على الـ Agents؟
فكرت فيها، وأعتقد أن السبب أعمق بكثير من مجرد "ترند".
الـ AI بدأ ينتقل من "اسألني وأنا أجاوبك" إلى "أعطني هدف، وأنا أنجزه لك".
وهذا فرق ضخم !
الـ Chatbot يساعدك في الشغل، بينما الـ Agent ممكن يعمل الشغل نفسه
مثلاً، بدل ما تقول: "كيف أصلح هذا الـ bug؟" وتأخذ جوابًا، تقول: "صلح الـ bug."
والـ Agent يقرأ الـ repo، يفهم الكود، يشغل الـ tests، يعدل الملفات، ويفتح PR.
هنا تبدأ تفهم لماذا الشركات كلها تتحرك بهذا الاتجاه
لأن امتلاك أفضل Model لم يعد بالضرورة كافيًا.
اليوم عندك GPT، Claude، Gemini، Grok، Llama... وكلهم يتحسنون بسرعة....
إذا كان Model أفضل قليلًا من Model آخر، قد لا يكون هذا الفرق مهمًا جدًا للمستخدم العادي.
لكن لو أصبح عندي Agent يعرف طريقة شغلي، عنده access إلى أدواتي، يتذكر الـ context، يستطيع استخدام التطبيقات، ويتابع المهام معي... هنا الموضوع مختلف تمامًا.
لأنه لن يكون شيئا أستخدمه فقط عندما أريد إجابة.
سيصبح جزءًا من طريقة عملي.
وهنا تظهر اللعبة الأكبر:
من سيكون الـ interface بين الإنسان والـ internet؟
اليوم أنت تفتح Gmail بنفسك، تدخل Calendar بنفسك، تفتح GitHub بنفسك، تذهب إلى Amazon بنفسك، تبحث في Google بنفسك، وتفتح Slack بنفسك.
لكن تخيل أن تقول فقط:
"رتب لي اجتماعات الأسبوع."
أو: "راجع الـ PRs."
أو: "ابحث عن أفضل رحلة جوية واحجزه."
والـ Agent هو الذي يذهب ويتعامل مع كل هذه الخدمات نيابةً عنك.
هنا الـ AI لم يعد مجرد Application.
يصبح طبقة بينك وبين التطبيقات نفسها.
وأعتقد أن هذا أحد أهم الأسباب التي تجعل الشركات كلها تتحرك الآن في نفس الاتجاه.
وفيه سبب تجاري مهم جدا أيضًا.
لو كنت تستخدم ChatGPT فقط للأسئلة، الانتقال إلى Claude أو Gemini سهل نسبيًا
لكن إذا أصبح الـ Agent هو الذي يدير جزءًا من workflow الخاص بك، ويعرف الـ tools والـ context والـ memory والـ preferences... تركه يصبح أصعب بكثير.
وهذا يعطي الشركة position أقوى بكثير.
وفيه شيء آخر مهم:
الـ Chatbot يعرف غالبا ماذا سألت.
لكن الـ Agent يمكن أن يعرف كيف تعمل.
يعرف الـ workflows، الأدوات التي تستخدمها، المهام التي تتكرر، الـ preferences، والـ context.
وهذه طبقة مختلفة تمامًا من العلاقة مع المستخدم.
لكن هذا لا يعني أن الـ Models لم تعد مهمة.
بالعكس.
الـ Model هو الـ engine، والـ Agent هو النظام الذي يستخدم هذا الـ engine لكي يعمل في العالم الحقيقي.
لذلك المنافسة بدأت تتحول من:
"مين عنده أفضل Model؟"
إلى:
"مين عنده أفضل system يجعل الـ Model ينفذ الأشياء فعلًا؟"
وهنا تدخل أشياء كثيرة: Reasoning، Planning، Memory، Tool use، Coding، Computer use، Permissions، Reliability، Latency، Cost، Integrations، وDistribution.
ولهذا أعتقد أن موجة الـ Agents الحالية ليست مجرد hype جديد فوق الـ LLMs.
هي محاولة لنقل الـ AI من "AI يساعدني" إلى "AI يعمل معي".
وربما في النهاية:
"AI يعمل نيابةً عني."
وهذا، بالنسبة لي، هو الرهان الحقيقي.
ليس فقط: من لديه أذكى Model؟
بل: من سيصبح الـ Agent الذي نعتمد عليه فعلًا؟
لأن القيمة في النهاية قد لا تكون في أن يكون عندك أذكى AI...
بل في أن يكون عندك AI تستطيع أن تقول له:
"خذ هذا الهدف... ودبّر الباقي."

RedOneX retweeted
جوجل أعلنت للتو عن Gemini 4 Argon 🔥
بصراحة الإعلان مثير للاهتمام، خصوصا أن Google داخلة بقوة في موضوع الـcoding والـagents والـcomplex workflows...
حسب Google، Argon يحقق أرقام قوية جدًا على مجموعة من الـbenchmarks، ويقولون إنه مستخدم داخليًا في Google في أشياء مثل software engineering وحتى quantum computing.
وأنا بصراحة متحمس أجربه بنفسي
لكن أول شيء لفت انتباهي هو حجم الأرقام والـbenchmarks اللي حاطينها 😂
هل فعلًا عندنا model جديد قوي جدًا؟
ولا كالعادة الـbenchmarks تحكي قصة، والاستخدام الحقيقي يحكي قصة ثانية؟
خلونا نشوفه أول، وبعدها نحكم.
Gemini 4 داخل المنافسة رسميًا 🔥


Lots of discussion out there about our next model(!), so I wanted to give an early look as soon as possible. Introducing Gemini 4 Argon!
It shows frontier performance in complex workflows, cyber defense and software engineering. Teams are using it extensively at Google, from coding to quantum computing, great feedback.
Here’s a look at the benchmarks:

RedOneX retweeted
هل الـbenchmarks فعلًا تقول لي أي model أفضل في الواقع؟
بصراحة: لا، مو بشكل كافي.
هي مفيدة جدا كـsignal، لكنها تقيس أشياء محددة وتحت شروط محددة: coding، reasoning، long context، computer use… إلخ.
لكنها ما تقيس بالكامل أشياء مثل:
هل يفهم قصدي؟ هل يظل consistent؟ هل يتعامل مع errors؟ هل يعرف يستخدم الـtools؟ هل يضيع في task طويل؟ وهل يحتاج مني أراقبه كل شوي؟
وهنا المشكلة: ممكن model يتصدر الـleaderboard، وبعد ساعة استخدام تقول: "وين راحت الـ92%؟ 😂"
لذلك أنا أشوف الـbenchmarks مهمة قبل التجربة، لكنها ما تكفي للحكم على تجربة النموذج نفسها.
Benchmark يعطيك إشارة. الاستخدام الحقيقي يعطيك الصورة.
جوجل أعلنت للتو عن Gemini 4 Argon 🔥
بصراحة الإعلان مثير للاهتمام، خصوصا أن Google داخلة بقوة في موضوع الـcoding والـagents والـcomplex workflows...
حسب Google، Argon يحقق أرقام قوية جدًا على مجموعة من الـbenchmarks، ويقولون إنه مستخدم داخليًا في Google في أشياء مثل software engineering وحتى quantum computing.
وأنا بصراحة متحمس أجربه بنفسي
لكن أول شيء لفت انتباهي هو حجم الأرقام والـbenchmarks اللي حاطينها 😂
هل فعلًا عندنا model جديد قوي جدًا؟
ولا كالعادة الـbenchmarks تحكي قصة، والاستخدام الحقيقي يحكي قصة ثانية؟
خلونا نشوفه أول، وبعدها نحكم.
Gemini 4 داخل المنافسة رسميًا 🔥
RedOneX retweeted
قد إيش مرة استخدمت iLovePDF؟ 😅
المضحك إنك ممكن تستخدمه من غير ما تفكر أصلًا مين وراه !
iLovePDF يحقق تقريبًا €18.8M إيرادات سنويًا، وجزء كبير من البزنس جاي من أدوات الـPDF والتحويل والمعالجة.
وهنا الشيء اللي دايم يلفتني في المنتجات الناجحة
مو لازم تبني شيء معقد عشان تبني بزنس كبير.
أحيانا كل اللي تحتاجه هو تاخذ مشكلة مزعجة جدًا، تحلها بشكل أبسط من الموجود، وتخلي الناس ترجع لك كل يوم
لا تدور على التعقيد… دور على المشكلة اللي الكل متعود يعاني منها

RedOneX retweeted
بصراحة Dots و Grok Bot و Muse نفس الـ agent، ثلاث شركات تبيع لكم موظف cloud على شكل كرة فرو.
ما راح أدفع عشان blob يقرأ Slack ويعتذر قبل ما يضغط زر. عندي VPS يشتغل وما يطلب مني أسمّيه وألبّسه نظارة
هذي مو مستقبل الشغل، هذي Netflix subscription لناس زهقوا من فتح الـ terminal.

RedOneX retweeted

التقرير الثالث
من 53.6 إلى 110.78 توكن بالثانية
كيف تغير أداء Qwen3.8-27B بعد إعادة هندسة MTP على 16GB VRAM
في التقريرين السابقين انتهيت إلى نقطة واضحة
بعد تجربة Qwen3.8-27B بإصدارات مختلفة من التكميم أصبحت نسخة UD-IQ3_XXS هي الإعداد العملي الذي اعتمدته للتشغيل المحلي
لم يعد السؤال بالنسبة لي:
هل يمكن تشغيل نموذج 27B على بطاقة 16GB؟
ولا
هل IQ3 أفضل من IQ4 على هذا الجهاز؟
هذه النقاط حُسمت في الاختبارات السابقة
السؤال الجديد أصبح
هل يمكن استثمار المساحة التي وفرها IQ3 ليس فقط في إبقاء النموذج على الـGPU بل في مضاعفة سرعة التوليد نفسها؟
ومن هنا بدأت المرحلة الجديدة من التجربة
━━━━━━━━━━━━━━━━━━
1. نقطة البداية
━━━━━━━━━━━━━━━━━━
الإعداد الذي انتهيت إليه سابقًا كان يحقق تقريبًا
التوليد: 53.6 توكن
مع تشغيل طبقات FFN على الـGPU وعدم الاعتماد على CPU FFN Offload
هذه أصبحت نقطة الأساس الجديدة
وبدل العودة إلى تغيير التكميم أو التضحية بالسياق ركزت هذه المرة بالكامل على مسار التوليد نفسه وتحديد
الـMTP (Multi Token Prediction)
الفكرة ببساطة أن النموذج لا يحاول اعتماد توكن واحد فقط في كل دورة بل يمكنه اقتراح عدة توكنات مستقبلية والتحقق منها دفعة واحدة
نظريًا هذه الطريقة تستطيع رفع سرعة فك الرموز بشكل كبير
لكن الاختبار الحقيقي أثبت أن المسألة أصعب من مجرد رفع قيمة Draft Tokens
━━━━━━━━━━━━━━━━━━
2. أول مشكلة: نتائج البنش مارك لم تنتقل إلى هيرمس
━━━━━━━━━━━━━━━━━━
في الاختبارات المنفصلة ظهرت نتائج MTP مرتفعة جدًا
لكن عند نقل نفس الفكرة إلى استخدام وكيل هيرمس على التيرمنال ظهرت مشكلة كبيرة
مع MTP11 على البناء القديم من llama.cpp انخفضت نسبة قبول Draft Tokens في بعض الجلسات إلى حدود
18–21%
وبدل أن ترتفع السرعة أصبحت الاستفادة من MTP ضعيفة وغير مستقرة في تلك المرحلة كانت السرعات الواقعية في أجزاء كثيرة من الجلسة تدور حول
41–53 توكن بالثانية
أي أن الأرقام العالية التي ظهرت في الاختبارات البنش مارك لم تكن تعكس أداء الوكيل الحقيقي
وهذه كانت نقطة مهمة جدًا في التجربة
بنش مارك ناجح لا يعني بالضرورة أن نفس الإعداد ناجح داخل وكيل فعلي
هيرمس يرسل سياقات طويلة System Prompts، أدوات، وسجل محادثة متغير باستمرار
وهذا يغير سلوك MTP جذريًا
━━━━━━━━━━━━━━━━━━
3. الـMTP6 كان أكثر استقرارًا… لكنه لم يكن النهاية
━━━━━━━━━━━━━━━━━━
بعد تقليل عمق MTP إلى 6 Draft Tokens تحسن الاستقرار
في الاستخدام الفعلي داخل هيرمس وصل الأداء إلى متوسط يقارب: 59.5 توكن بالثانية
وهذا كان بالفعل أسرع من نقطة الأساس السابقة البالغة 53.6 توكن بالثانية لكن الزيادة كانت محدودة نسبيًا
لذلك لم أعتبر MTP6 نهاية التجربة
المشكلة لم تكن في فكرة MTP نفسها بل في أن العمق الأعلى لم يكن يعمل بكفاءة كافية على البناء الذي كنت أستخدمه
━━━━━━━━━━━━━━━━━━
4. تغيير المحرك غيّر النتيجة
━━━━━━━━━━━━━━━━━━
بدل الاستمرار في تعديل النموذج أو إعادة التكميم إنتقلت إلى نسخة أحدث من upstream llama.cpp وبنيت نسخة CUDA جديدة مخصصة لـBlackwell SM120
وهنا ظهر الفرق الحقيقي.
بعد تحديث البناء MTP11 الذي كان يعاني سابقًا من انهيار كبير في Draft Acceptance بدأ يحقق نسب قبول مرتفعة جدًا على وكيل هيرمس
في أجزاء متعددة من الجلسة ظهرت نسب
80%
90%
وأكثر من 94%
وهذا كان التحول الأساسي في المرحلة الجديدة
لم يتغير النموذج
ولم يتغير التكميم
الذي تغير هو كفاءة مسار التنفيذ نفسه
━━━━━━━━━━━━━━━━━━
5. البحث عن نقطة استقرار لـMTP11
━━━━━━━━━━━━━━━━━━
بعد ذلك اعتمدت إعدادًا أكثر تحفظًا بدل السماح لـMTP11 بالعمل بدون حدود
الـMaximum Draft
11
الـMinimum Draft
3
الـMinimum Probability
0.70
الـBackend Sampling
الـON
الفكرة كانت أن MTP لا يحتاج أن يجبر نفسه على إنتاج 11 توكن في كل مرة إذا كانت الثقة منخفضة يستطيع الاكتفاء بسلسلة أقصرالنتيجة كانت تحسنًا واضحًا في الاستخدام الحقيقي.
ومع إعداد
الـBatch 1024
الـUBatch 256
وصلت إحدى استجابات هيرمس إلى
90.28 توكن بالثانية
لأول مرة أصبحت المسافة إلى حاجز 100 توكن بالثانية صغيرة جدًا
━━━━━━━━━━━━━━━━━━
6. التغيير الذي كسر حاجز 100
━━━━━━━━━━━━━━━━━━
في المرحلة التالية لم أغير إعدادات MTP
غيرت عاملًا واحدًا فقط
الـBatch
1024 → 2048
الـUBatch
256 → 512
وهنا حصلت أكبر قفزة في التجربة
داخل وكيل هيرمس تم تسجيل
101.94 توكن بالثانية
مع:
الـDraft Acceptance
88.46%
الـMean Draft Length
8.36
ثم جاءت أفضل نتيجة حتى الآن
110.78 توكن بالثانية
مع:
الـDraft Acceptance
94.15%
الـMean Draft Length
10.19
وفي استجابة أخرى وصلت السرعة إلى
99.03 توكن بالثانية
مع نسبة قبول تقارب
94.15%
وبذلك تم كسر حاجز 100 توكن بالثانية 💪
فعليًا داخل وكيل هيرمس على التيرمنال وليس داخل بنش مارك
━━━━━━━━━━━━━━━━━━
7. ماذا يعني رقم 110.78 فعلًا
━━━━━━━━━━━━━━━━━━
من المهم هنا عدم تقديم الرقم بطريقة مضللة
110.78 توكن بالثانية هو
الـPeak كامل لاستجابة حقيقية داخل وكيل هيرمس وليس متوسطًا ثابتًا لكل الاستجابات
السيرفر كان مضبوط على Context Capacity قدره 81.920 توكن لكن الاستجابة التي حققت 110.78 توكن بالثانية كانت تعمل عند سياق فعلي يقارب 28.3 ألف توكن
وهذا فرق مهم
الأهم من رقم القمة نفسه أن الاختبارات كشفت علاقة واضحة جدًا بين MTP Acceptance والأداء
عندما وصل Draft Acceptance إلى قرابة
94%
ومع Mean Draft Length قريب من
9–10 توكنات
أصبح الأداء في نطاق
99–111 توكن بالثانية
أما عندما ينخفض Acceptance إلى حدود
55–65%
وتصبح سلاسل Draft أقصر، في حدود
4–5 توكنات
فإن السرعة تعود غالبًا إلى نطاق
40–50 توكن
بمعنى آخر:
الـMTP11 لا يمنح سرعة ثابتة
إنه يرفع السقف الأعلى للأداء بشكل ضخم عندما يستطيع التنبؤ بسلسلة طويلة وصحيحة من التوكنات.
━━━━━━━━━━━━━━━━━━
8. من 53.6 إلى 110.78
━━━━━━━━━━━━━━━━━━
لو قارنت أعلى نتيجة بالسرعة الأساسية التي إنتهيت إليها في التقرير السابق
53.6 توكن بالثانية
→
110.78 توكن بالثانية
فالقفزة في Peak Performance بلغت تقريبًا
+106.7%
أي
2.07× تقريبًا
على نفس النموذج ونفس التكميم وهذا بالنسبة لي هو أهم ما في النتيجة الزيادة لم تأتِ من الانتقال إلى GPU أكبر
ولا من نموذج أصغر
ولا من تقليل حجم النموذج مرة أخرى
بل من تحسين طريقة تنفيذ Decode والاستفادة من MTP.
━━━━━━━━━━━━━━━━━━
9. هل النتيجة مرتبطة بـهيرمس
━━━━━━━━━━━━━━━━━━
بعد الوصول إلى أكثر من 100 توكن بالثانية داخل هيرمس أردت اختبار واجهة مختلفة على نفس llama server
لهذا استخدمت Open WebUI
الهدف لم يكن معرفة أي واجهة "أسرع" بشكل سطحي
بل معرفة هل الأداء الذي حققناه مرتبط بهيرمس نفسه أم أن نفس Backend يستطيع الحفاظ على أدائه مع عميل آخر
━━━━━━━━━━━━━━━━━━
10. الـOpen WebUI بدون وكيل هيرمس
━━━━━━━━━━━━━━━━━━
بعد تشغيل Open WebUI بصورة معزولة وإعادة تشغيل llama server بحالة نظيفة سجلت ثلاث استجابات طويلة متتالية
56.86 توكن بالثانية
55.91 توكن بالثانية
58.22 توكن بالثانية
المتوسط
56.997 توكن بالثانية
أي تقريبًا
57 توكن بالثانية
واللافت أن السياق استمر في النمو خلال المحادثة
561 برومت توكن
ثم:
3.057
ثم:
5.844
ومع ذلك بقي متوسط Decode قريبًا جدًا من 56–58 توكن بالثانية
وهذا أعطى إستقرار
كما ظهر أثناء إحدى الاستجابات Peak لحظي لثلاث ثوانٍ بلغ
111.16 توكن بالثانية
لكن متوسط الاستجابة الكاملة بقي
58.22 توكن بالثانية
وهنا يظهر مرة أخرى الفرق بين
الـInstantaneous Throughput
وبين:
الـFull response Average
━━━━━━━━━━━━━━━━━━
11. لماذا كان Open WebUI أحيان أبطأ؟
━━━━━━━━━━━━━━━━━━
في أول استجابة نظيفة لـOpen WebUI وصلت السرعة إلى
37.24 توكن بالثانية
لكن Draft Acceptance كان منخفضًا
49.14%
وعندما ارتفع Acceptance في الاستجابات التالية إلى قرابة
63–65%
إستقر الأداء حول
56–58 توكن بالثانية
وهذا يعزز النتيجة التي ظهرت داخل هيرمس
نوع النص وشكل برومت يؤثران مباشرة على نجاح MTP
لذلك لا يمكن أخذ رقم واحد من هيرمس ورقم واحد من أوبن ويب يو إيِ والقول إن إحدى الواجهتين أسرع من الأخرى
الواجهة تغير
الـSystem Prompt
الـConversation History
الـTool Definitions
الـFormatting
وكل ذلك يغير احتمالية نجاح Draft Tokens
━━━━━━━━━━━━━━━━━━
12. المفاجأة الحقيقية تشغيل وكيل هيرمس وأوبن ويب يو إيِ معًا
━━━━━━━━━━━━━━━━━━
أثناء الاختبار ظهر اكتشاف لم أكن أبحث عنه أصلًا
لاما سيرفر المستخدم في التجربة يعمل بـ
الـ1 Slot
الـParallel = 1
عندما كان أوبن ويب يو إيِ يعمل بدون وكيل هيرمس
≈57 توكن بالثانية
لكن بعد إعادة تشغيل Hermes Gateway واستخدام Hermes وOpen WebUI على نفس السيرفر حدث انخفاض حاد
ظهر أولًا طلب Hermes بسياق يقارب
الـ26,022 Prompt Tokens
وكان Prompt Processing لا يزال سريعًا
≈1,381 توكن
بعده مباشرة جاء طلب Open WebUI
والنتيجة:
15.86 توكن
ثم ظهر طلب صغير إضافي من Open WebUI وانخفض إلى
11.51 توكن
مقارنة بمتوسط Open WebUI المنفرد
≈57 توكن
فالانخفاض في الاستجابة الرئيسية بلغ تقريبًا
72%
أو:
3.6× أبطأ
━━━━━━━━━━━━━━━━━━
13. الغريب أن MTP لم يكن المتهم هذه المرة
━━━━━━━━━━━━━━━━━━
هذه النتيجة كانت مثيرة لأن طلب Open WebUI الذي انخفض إلى
15.86 توكن
كان لديه Draft Acceptance
69.8%
أي أعلى من بعض الاستجابات التي كانت تعمل أسرع بكثير لذلك لا يمكن تفسير هذا الانخفاض بمجرد ضعف MTP Acceptance كما أن فحص WSL وقت المشكلة أظهر
الـSwap Used
0
والذاكرة المتاحة داخل WSL كانت كبيرة
لذلك لا يوجد دليل على أن النظام دخل Swap أو نفدت منه RAM الرئيسية في المقابل كان llama server يعمل على سلوت واحد فقط وكانت الواجهتان ترسلان أنماط سياق مختلفة جدًا إلى نفس Runtime
كما ظهر أن Open WebUI يرسل طلبات صغيرة إضافية بعد بعض الردود على الأرجح لمهام خلفية مرتبطة بالواجهة.
حتى الآن لا أعتبر السبب الجذري محسومًا بشكل نهائي
لكن التجربة أثبتت شيئًا عمليًا بوضوح:
تشغيل Hermes وOpen WebUI بالتناوب على نفس llama server ذا سلوت واحد قادر على إدخال السيرفر في حالة أداء سيئة جدًا وبمجرد عزل الخدمات وإعادة تشغيل السيرفر عاد Open WebUI إلى نطاقه الطبيعي قرب 57 توكن
━━━━━━━━━━━━━━━━━━
14. ماذا تعلمت من هذه المرحلة؟
━━━━━━━━━━━━━━━━━━
التجربة بدأت كسؤال عن كيفية تجاوز 53.6 توكن بالثانية
لكنها انتهت إلى نتيجة أوسع بكثير
أولًا:
أداء نموذج محلي لا يحدده حجم النموذج والتكميم فقط
طبقة Runtime نفسها تستطيع تغيير النتيجة بأكثر من الضعف
ثانيًا:
نتائج Speculative Decoding يجب اختبارها داخل workload حقيقي
الـMTP11 كان رائعًا في الاختبارات بنش مارك وفشل في أول تجربة مع وكيل هيرمس ثم تحول بعد تحديث المحرك وضبطه إلى أسرع إعداد اختبرته
ثالثًا:
الـDraft Acceptance وحده لا يكفي
الـMean Draft Length مهم جدًا أيضًا
نجاح عشر توكنات تقريبًا في الدورة الواحدة هو ما جعل الوصول إلى أكثر من 100 توكن بالثانية ممكن
رابعًا:
الـPeak Performance وSustained Performance رقمان مختلفان
أفضل نتيجة
110.78 توكن
لكن الأداء المستمر يتغير حسب طبيعة النص ونجاح MTP
خامسًا:
الـClient نفسه ليس مجرد واجهة رسومية
طريقة بناء برومت وإدارة السياق والطلبات الخلفية يمكن أن تغير حالة Backend وسلوكه بصورة ملموسة
━━━━━━━━━━━━━━━━━━
15. أين وصلت التجربة الآن؟
━━━━━━━━━━━━━━━━━━
في التقرير السابق كانت النتيجة الأساسية
الـQwen3.8-27B IQ3
≈53.6 توكن بالثانية
اليوم أصبحت النتيجة
الـReal Hermes Peak
110.78 توكن بالثانية
الـ 100+ توكن بالثانية
تم تحقيقها
الـOpen WebUI isolated:
≈57 توكن بالثانية مستقرة
الـPrompt Processing في السياقات الكبيرة
≈1.300–1.500 توكن بالثانية
والأهم:
تم تحديد مشكلة أداء منفصلة تظهر عند مشاركة Hermes وOpen WebUI لنفس llama server ذا سلوت واحد
━━━━━━━━━━━━━━━━━━
الخلاصة
━━━━━━━━━━━━━━━━━━
بعد التقريرين السابقين لم أعد أحاول إثبات أن نموذج 27B يمكن تشغيله على بطاقة 16GB
هذه المرحلة انتهت
التحدي أصبح
كم يمكن استخراج أداء إضافي من نفس النموذج ونفس العتاد؟
والنتيجة الحالية هي أن سرعة التوليد التي بدأت عند
53.6 توكن بالثانية
استطاعت الوصول في استجابة حقيقية داخل هيرمس إلى
110.78 توكن بالثانية
أي زيادة في Peak Performance تقارب
106.7%
بدون تغيير النموذج أو الانتقال إلى تكميم أصغر
لكن النتيجة الأهم من رقم 110.78 نفسه هي أن الاختبارات كشفت أين أصبح عنق الزجاجة الجديد
لم يعد السؤال
هل النموذج يدخل في VRAM؟
بل أصبح:
كيف نحافظ على MTP Acceptance مرتفعًا؟
كيف نحافظ على Draft Length طويلًا؟
كيف ندير KV/runtime بين أنواع السياقات المختلفة؟
وكيف نمنع عميلًا من التأثير في حالة العميل الآخر؟
بمعنى آخر:
بعد أن كانت المرحلة السابقة عبارة عن هندسة ذاكرة وتشغيل النموذج داخل 16GBأصبحت المرحلة الحالية هندسة لمسار الاستدلال نفسه وهذا بالنسبة لي هو التطور الحقيقي في التجربة
#تقنية
🤖 Made with AI

RedOneX retweeted

أكثر منتج متحمس لاقتناءه!
أول منافس حقيقي لنظارات ميتا الذكية
نظارة سامسونج X جوجل الذكية 😎
نظارة بكاميرا + سماعات + جيميناي!
جربتها في Google IO


RedOneX retweeted
شركة Cloudflare نشرت اليوم تجربة مرعبة 👀
Anthropic بنوا مودل سري للأمن السيبراني اسمه Mythos، ما اطلقوه للعامة لانه "خطر جدًا"، أعطوه لشركات محدودة للاختبار. Cloudflare من ضمنهم، وجهوه على ٥٠+ من اكوادهم
ايش لقى؟
تخيل عندك ٣ اخطاء صغيرة في كودك، كل وحدة لحالها ما تشكل خطر، كل وحدة قاعدة في قائمة "نصلحها لاحقًا"
Mythos يقرأهم، يربطهم بطريقة عبقرية، ويبني منهم هجوم متكامل يخترق نظامك
مب بس يكتب كود الهجوم، يجربه بنفسه، لو فشل يعدل طريقته ويحاول من جديد
النقطة اللي شدتني: الاخطاء "الصغيرة" اللي كل فريق برمجة يأجل اصلاحها = هذي بالضبط اللي بنى منها Mythos اخطر الهجمات
الـbacklog اللي مكتوب فيه "نصلحه الشهر الجاي" صار قنبلة موقوتة
ايش يعني هذا لك: اذا مشروعك يستعمل لغات قديمة (C، C++) انت في خطر مضاعف. Rust و Go صاروا حماية وقائية مب رفاهية
التحذير اللي اخفى منه Cloudflare: نفس الادوات اللي تكتشف ثغراتهم، نفسها اللي راح تستعمل لمهاجمتك قريبًا


Cloudflare's security team spent the last few weeks testing Anthropic's Mythos against fifty of our own repositories. What we learned about offensive AI, why faster patching is the wrong reaction, and what the architecture around vulnerabilities has to look like next. cfl.re/49BRUqW

RedOneX retweeted
منصة Cline اطلقوا SDK كامل مفتوح المصدر اليوم 🔥
https://xitter.cf/t.co/AokdnZllop
اللي يفرق:
في benchmark Terminal-Bench 2.0 (يقيس مهام تيرمنل حقيقية):
Claude Opus 4.7:
- Cline ← ٧٤.٢٪
- Claude Code ← ٦٩.٤٪
Claude Opus 4.6:
Cline ← ٧١.٩٪
Claude Code ← ٦٥.٤٪
اللي يجي معاه 👇:

RedOneX retweeted
صار تقدر تشغل Codex داخل Claude Code 💀
xitter.cf/i/status/2054617730104…
اقولها مرة ثانية: OpenAI نزلت plugin يشغل Codex... جوا Claude Code... منتج Anthropic 😅
/plugin install codex@openai-codex
٢٠٢٥: كل شركة تبني جدار حول مودلها
٢٠٢٦: OpenAI تركب نفسها في بيت Anthropic
الـAI industry وصل لمرحلة "ما عاد فيها كرامة" 😂
RedOneX retweeted
قصة Anthropic اللي طفّت حسابات شركة كاملة +60 موظف بإيميل واحد.. درس مجاني لكل مؤسس
سنة كاملة من الشغل، الـ integrations، والـ workflows.. راحت في ثانية، والاعتراض عبر Google Form 🤦♂️
نصيحتي لأي واحد يبني منتج على LLMs:
1. اعمل abstraction layer فوق الـ API، عشان تبدّل المزوّد في دقائق مو أسابيع
2. Multi-provider من أول يوم.. Claude + GPT + Gemini مع fallback تلقائي
3. خزّن كل المحادثات والـ prompts في database تملكها انت، مو محفوظة عند الشركة
الوظائف الحساسة شغّلها على open-source models محلياً (Llama, Qwen) ولو كـ backup
الاعتماد على مزوّد واحد مو مشكلة تقنية.. مشكلة وجودية لمشروعك !


Anthropic decidió dar de baja a toda nuestra organización por una supuesta infracción de sus condiciones de uso. Qué política específica infringimos no tengo ni la menor idea: simplemente recibimos un mail y listo, adiós Claude. Si querés apelar la medida hay que completar un Google Form, así de ridículo como suena.
De golpe más de 60 personas se quedaron sin una herramienta fundamental para trabajar. Integraciones, skills, historial de conversaciones: todo perdido o, en el mejor de los casos, parado por tiempo indeterminado.
Enorme aprendizaje para cualquier empresa de software que dependa de herramientas de IA en procesos críticos. Nunca hay que poner todos los huevos en una canasta.
RedOneX retweeted
أخيرا Ollama ضاف دعم لـ Hermes Agent من Nous Research، وهذي إضافة تستاهل الانتباه لو تتابع موضوع الـ local agents مثل OpenClaw.
باختصار: Hermes عبارة عن agent يشتغل محليًا على جهازك، يجي معه أكثر من ٧٠ skill جاهزة، ويقدر يضيف مهارات جديدة لنفسه مع الوقت، وفيه cross-session memory يعني يتذكر الشغل بين الجلسات وما يبدأ من الصفر كل مرة.
التشغيل بأمر واحد:
ollama launch hermes
Ollama يتكفل بالباقي: يثبته لك لو مو مثبّت، تختار الموديل (سحابي أو لوكال)، ويربطه تلقائي على الـ endpoint الخاص فيه
http ://127 .0.0.1:11434/v1.
بالنسبة للموديلات، عندك خيارين:
• سحابية مثل kimi-k2.5:cloud أو qwen3.5:cloud أو glm-5.1:cloud مناسبة لو جهازك مو قوي أو ما تبي تستهلك موارده.
• محلية مثل gemma4 (يبي ~16GB VRAM) أو qwen3.6 (~24GB VRAM) . أفضل من ناحية الخصوصية والاستقلالية، بس تحتاج GPU محترم 👀
تقدر تربطه بتطبيقات المراسلة : تيليقرام، ديسكورد، سلاك، واتساب، سقنل، أو حتى الإيميل عشان تكلم الـ agent من الجوال بدون ما تفتح الترمنال:
hermes gateway setup
ملاحظة لمستخدمي ويندوز: الأداة تبي WSL2، ثبته بـ wsl --install وشغّل Hermes من داخل الـ WSL shell مو من PowerShell مباشرة ⚠️
ولو تفضل تتحكم بالإعدادات يدويًا بدل ما Ollama يسويها لك، فيه install script مباشر، والـ setup wizard يعطيك Quick setup أو Full setup حسب الحاجة.


ollama launch hermes
Ollama 0.21 includes supports Hermes Agent, the self-improving AI agent built by @NousResearch.

ALT ollama now has hermes agent support
RedOneX retweeted
منصة Unsloth نزلوا نوتبوك على Google Colab يشتغل على كرت T4 اللي قوقل يوفّره بالطبقة المجانية، وتقدر تدرب فيه أكثر من 500 موديل Open source 👌🏻
xitter.cf/i/status/2041177756848…
ال Notebook يسوي كل شي تلقائي
يحمّل الريبو، يضبط البيئة، ويفتح لك واجهة الاستوديو كاملة داخل الكولاب بدون ما تفتح شي ثاني. وحاطين loop يخلي الجلسة ما تنقطع عليك وأنت تشتغل.
من الاستوديو تجهز بياناتك، تسوي fine-tuning لموديلات مثل Llama و Mistral و Gemma، تدردش مع الموديل، وتصدره لـ Ollama أو vLLM جاهز للاستخدام
ميزة Unsloth إن استهلاك الذاكرة أقل بكثير، فموديلات كانت تحتاج كروت غالية الحين تقدر تشغّلها على T4.
⚠️ بس خلك واقعي:
الكولاب المجاني عنده حدود بالوقت والذاكرة، فيناسب أكثر الموديلات الأصغر والتجارب.
لو تبي تدرّب شي كبير أو لوقت طويل، ممكن تحتاج Colab Pro أو تشغّله Local.
👇

You can now train and run 500+ models in our free notebook!✨
GitHub repo: github.com/unslothai/unsloth
Colab Notebook: colab.research.google.com/gi…
RedOneX retweeted

هل سيحذف الذكاء الاصطناعي 50% من الوظائف؟
في حوار عميق بين @StevenBartlett و الاقتصادي البارز البروفيسور ستيف كين @ProfSteveKeen (الذي تنبأ بأزمة 2008)
يحذر من أن الذكاء الاصطناعي والروبوتات يُعيدون كتابة سوق العمل بسرعة مخيفة
هل نستعد لعصر لا يحتاج فيه معظم الناس إلى وظيفة تقليدية؟
أم أننا نتجه نحو عدم مساواة غير مسبوقة؟