

Banny|嗯哌AI 主理人 · AI 工作流搭建者 NotebookLM 教程全网 50 万播放|开源 Dify 工作流 GitHub 2.7k⭐ 白天搭能直接抄的 AI 工作流,晚上吐槽被 AI 坑的日常
Joined August 2023
- Tweets1.6K
- Following841
- Followers1.3K
- Likes1.9K





Pinned Tweet
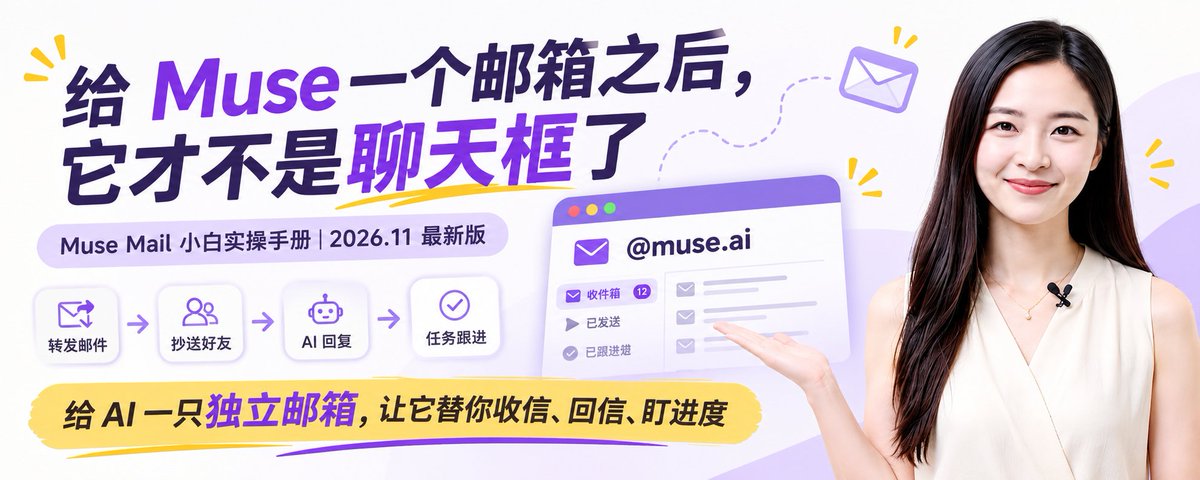
🚨Muse Mail 开始向所有已支持地区的用户推送,免费用户也能开了! @muse.ai 用户名全网唯一、先到先得、注册后改不了,先抢再说。 这份小白操作手册讲清:开通步骤、8个实操场景+指令模板、权限设置、避坑和隐私👇
DeepSeek Harness 今天发了 v0.2.3-alpha.1,我翻了一下更新日志。
印象最深的是新加的连接器:飞书、钉钉、企业微信、腾讯文档、腾讯会议都能接了,另外还有 Linear 和 Notion。去插件页授权一次,之后就能在对话里直接调用。国内团队日常用的就是这几个软件,这次加得挺实在。
其他几个我觉得有用的:
• 新增了代码审阅页,和自己有关的 PR 都放在一个地方看,GitLab 的 MR 现在也能审、能合并
• MCP 支持 OAuth 了,token 会自动刷新,不用再隔几天手动换一次
• MCP 工具改成用到的时候才加载,不会一开始就把上下文占满
• 加了时间线插件,能看到 agent 的任务做到哪一步、卡在哪(实验性)
• Windows 上也能用 Computer Use 了(实验性)
要注意这还是 alpha 版。插件和自定义配置有一部分要迁移,Python PTC 也去掉了。生产环境在用的,最好先看完升级说明再升。
你们最想先接哪个?
github.com/deepseek-ai/deeps…


1个多小时前,DeepSeek Harness 更新到 v0.2.3-alpha.2,我随即将 dsh web 从 v0.2.2-rc.5 升级到 v0.2.3-alpha.2。
升级完成后体验新功能时,我发现在 v0.2.3-alpha.1 预发行版里提到的:新增可选的 Linear、Notion、腾讯文档、飞书、企业微信、腾讯会议和钉钉连接器插件,可在插件页连接或授权后在对话中使用。
可我怎么都找不到连接的地方。
我把 README 一个个打开逐条读了,才发现这些连接器默认没有装。它们在官方仓库 packages/connector/ 下面,是单独发布的 npm 包,得先装上,插件页才会出现对应的账号连接区域。不是我这一台的问题,升级的人默认都看不到。
安装方法:插件页点「添加插件」,填完整包名:
@deepseek-ai/dsh-linear
@deepseek-ai/dsh-notion
@deepseek-ai/dsh-tencent-docs
@deepseek-ai/dsh-tencent-meeting
@deepseek-ai/dsh-feishu
@deepseek-ai/dsh-wecom
@deepseek-ai/dsh-dingtalk
还有个坑:npm 上的连接器目前是 0.2.3-alpha.1,跟 alpha.2 本体差一个版本。腾讯文档我已经装上了;腾讯会议因为版本不兼容被拒绝安装,飞书、企业微信、钉钉是同一类,估计也一样,只能等官方发新版。
github.com/deepseek-ai/deeps…
138
1个多小时前,DeepSeek Harness 更新到 v0.2.3-alpha.2,我随即将 dsh web 从 v0.2.2-rc.5 升级到 v0.2.3-alpha.2。
升级完成后体验新功能时,我发现在 v0.2.3-alpha.1 预发行版里提到的:新增可选的 Linear、Notion、腾讯文档、飞书、企业微信、腾讯会议和钉钉连接器插件,可在插件页连接或授权后在对话中使用。
可我怎么都找不到连接的地方。
我把 README 一个个打开逐条读了,才发现这些连接器默认没有装。它们在官方仓库 packages/connector/ 下面,是单独发布的 npm 包,得先装上,插件页才会出现对应的账号连接区域。不是我这一台的问题,升级的人默认都看不到。
安装方法:插件页点「添加插件」,填完整包名:
@deepseek-ai/dsh-linear
@deepseek-ai/dsh-notion
@deepseek-ai/dsh-tencent-docs
@deepseek-ai/dsh-tencent-meeting
@deepseek-ai/dsh-feishu
@deepseek-ai/dsh-wecom
@deepseek-ai/dsh-dingtalk
还有个坑:npm 上的连接器目前是 0.2.3-alpha.1,跟 alpha.2 本体差一个版本。腾讯文档我已经装上了;腾讯会议因为版本不兼容被拒绝安装,飞书、企业微信、钉钉是同一类,估计也一样,只能等官方发新版。
github.com/deepseek-ai/deeps…
别急着换更大的模型——先把活拆小,模型自己就变强了。
这不是空话,是有论文验证过的,Zhang 等人那篇讲脚手架组合泛化的论文《Language Model Harnesses Can Be Compositional Generalizers》,做了个实验:同样是 27B 的模型,只换拆活这一个办法。
它的办法就两句:长材料不往提示词里塞,存在外面一个能跑代码的地方,模型写代码去查;大任务拆成小活,一次只让模型干一件它练过的。
效果怎么样呢?在 8 个训练时没见过的长任务上,同样是 27B 的模型,用合成数据按拆活办法训出来的,平均 58.5 分;同一套脚手架里没这么训的,46.1 分。只换一个变量,分数差了 12.4 分——拆活这个变量说了算。另一组实验只在短任务上练,拿到长 8 到 32 倍的任务上,效果照样在。
省在哪也测出来了:一件事要来回几轮,从 18.4 轮降到 6.5 轮,总 token 从约 72 万降到 38.5 万;但输出 token 从约 1.5 万涨到 6.5 万。省的是来回的轮数和总 token,不是输出的字数。
但能全信吗?这只是个解释,不是定论。为什么拆活有效,论文给的说法是“每次调用都落在模型熟悉的范围里”——这个说法有侧面证据,没被直接证实;换个任务,迁移效果也不一样;省的是 token 和轮数,不是实测耗时。
所以我的判断是:模型不够用时,先改脚手架再换模型——把大任务拆成模型见过的小调用,前提是拆法本身可复用、且你能量出拆完是不是真省了。
落到我自己身上,我让 agent 干长活,也是先拆再干:
第一,长材料先移出提示词:存到文件里,让模型写代码去查,用到了再拿,别整段往提示词里贴。
第二,大任务先拆成小活:每一步只让模型做一件它练过的活(查一段、改一处、验一次),别一次喂整个任务。
第三,拆完量两笔账:来回轮数和总 token 降没降、输出 token 涨了多少——只看一头会误判。
模型没变强,是每次见到的问题都变熟了。
你最近一次觉得模型不够用,是先换了模型,还是先拆了活?


1
3
225

26.4B 参数的模型,装进笔记本只要 20GB——中间 12 层被循环用了 3 遍。
先说它省在哪:11 月 20 日,Thinking Machines 发布 Inkling 2 Mini,开源权重(Apache 2.0 协议)。26.4B 总参数,每次只激活 3.4B(循环重复算进去,是 5.4B 有效激活);24 层里中间 12 层每生成一个词跑 3 遍,算下来是 48 次层运算——存 24 层的权重,干 48 层的活。NVFP4 格式约 20GB,32GB 以上统一内存的 Mac 就能跑,上下文 100 万 token。
所以便宜是算出来的:在 Artificial Analysis 智能指数上它拿 20 分,和 Qwen3.8-27B 持平,但按 5.4B 有效激活算,少约 5 倍;每道题 0.59 美元、9 分钟,对 Qwen3.8 的 3.53 美元、38.2 分钟——约 6 倍便宜、4 倍快。代价也写在同一处:输出 token 多约 38%,省的是算力钱,不是 token 数。
再说它对口什么活:按 Thinking Machines 自家的对比,它在 DeepSWE 这类 agent 写代码的基准上赢了 Qwen3.8-27B;HLR 的判断是它长处在 agent 写代码,不在背知识——这是厂商自报加 newsletter 判断,不是独立实测。
论点:模型不拼谁存得多,拼谁把存的用得多——循环是用算力换深度,前提是你的活吃深度(多步推理、写代码),不吃背下来的知识。
我的做法是这样:
第一,先看内存门槛:32GB 以上统一内存再试,不够别硬上。
第二,再看活对不对口:写代码、跑 agent 这类活优先试;要背知识、答冷知识的活,先拿自己的题测,别默认它行。
第三,算一笔账:同样一道题,对比输出 token 和耗时——它输出多 38%,省的是算力钱,不是 token 数。
一句话:存得少不是弱,同一层多跑几遍,深度就长出来了。
你的笔记本内存多少?会拿它跑本地 agent 吗?
2
1
225

一直觉得 Dia 挺好用,这次 v1.57 更新把它从“读取工具”推进到“能动手创作”。
以前 Dia 只能读 Figma 文件,现在可以创建、编辑、读取,从聊天直接出成品:生成 Figma Slides、用 FigJam 白板整理头脑风暴、按最新反馈修改设计。
我觉得最实用的是:在 Figma 里放一个现成模板,Dia 会从 Slack 聊天、文档或日历里找出相关信息,填到模板里对应的位置。比如让它用 Slack 里的讨论内容做一张活动海报,不用自己复制粘贴。而且它在你的 Figma 里创建任何东西前都会先问你。
这次还有:嵌套标签组(最多 8 层)、聊天里直接附加 Excel/Word/PPT、Notion/Slack/GitHub 搜索增强。

3
4
312
你们用 T3 Code 是直接下载官方 Desktop App,还是自己拉源码部署?🤔
为了深度魔改 UI 和调整 Agent 编排/任务调度逻辑,我硬是在 Mac 上搞了一套源码部署。
虽然自由度拉满,但这一通环境配置和调试折腾下来,是真耗时耗力啊!
有人也是源码党吗?来聊聊踩过啥坑 👇

5
3
231
有多少人跟我一样用X的:交着订阅费,一分钱没赚到?
本想指望原创内容奖励,让老马开点工资,结果90天要50万已验证曝光,我这才4.67万,连门槛的零头都够不着,这工资看来是领不到了。
每次扣月费的时候,唯一能安慰自己的,大概也就是能第一时间刷到点真正的前沿信息了。
好奇问一句,同样没拿到变现的,
你们每天在X上发推、刷推的动力到底是啥?

5
3
139
Docker 和 Kubernetes,从来不是二选一。
一个负责打包,一个负责管一大群打包好的东西。
先说结论:它俩分工不同。
Docker 是打包工具:把代码、要用的库、运行环境、配置,打成一个叫镜像的包,笔记本、服务器、云上都能跑。平时一台机器上跑几个容器,用 Docker Compose 一起管就够了。
Kubernetes 是管家:管的不是一个容器,是一大群跑在多台机器上的容器。流量大了能多开几个,闲了能少开几个,挂了能自动拉起来,更新也能帮你推上去。
那什么时候该用谁?
这一步的判断已经打通了:只看规模。
一台机器、几个服务、自己跑着玩,先用 Docker 就够了,上 Kubernetes 反而是给自己加活。
多台机器、要扛流量、挂了不能停,这时候才轮到 Kubernetes 出场。
所以照着这 3 步判断,就不会选错:
1. 数机器:只有 1 台,直接 Docker。
2. 问后果:挂了能不能等?能等就 Docker,不能等再谈 Kubernetes。
3. 问规模:要不要跨多台机器跑?不用就 Docker,要跨机器再谈 Kubernetes。
我的判断是:先把 Docker 用熟,再问要不要 Kubernetes。
顺序反了,学到的不是架构,是运维的苦。
你现在是只用 Docker,还是已经在用 Kubernetes 了?

B2A 来了:互联网的主要用户,已经不是人类了。
a16z(Andreessen Horowitz)最近提出了 B2A(Business-to-Agent)的概念——商家不再只卖货给人,而是直接卖给替你做决定的 AI agent。
agent 是怎么买的?付钱这一步已经打通了:上上周五(11 月 13 日),OpenAI 推出了 ChatGPT Wallet。绑定信用卡后,助手 Dot 就能替你下单;每次扣款走虚拟替代卡号,安全有保障,最后只需你用 Face ID 或指纹确认一下。
数据也在疯涨:8 到 10 月,agent 浏览流量涨了 8 倍;Shopify 的 AI 搜索订单一季度同比暴涨近 13 倍。
但问题来了:AI 挑东西,其实比人更容易被“带节奏”。
Every 评估负责人 Mike Taylor 做过一个测试:面对同一件商品,写给人看的夸张文案,Claude Sonnet 的购买率只有 4%;而换上专门写给 AI 看的规整参数文案,购买率直接飙到 97%。
这意味着:钱包解决的只是“付钱”,而不是“挑东西”。
只有那些“随便买个能用就行、不用货比三家”的东西,才适合真正放手;只要需要精挑细选,就得自己把关。
这是我给自己定的 4 条防坑原则:
第一,权限分三档:补货、改签等标准化需求,全权交给 agent;日常高频采购,让它装好购物车我来点;挑礼物等需要审美品味的,必须自己来。
第二,建一份“家里库存清单”:冰箱缺什么、常用什么型号,写成文档喂给它,防买重。
第三,死守人工确认:永远保留最后一步的 Face ID/指纹确认,看清总价再放行。
第四,每周复盘错单:买重、买错规格的,直接记录下来写进它的系统提示词里。
未来商家会越来越懂怎么“讨好”你的 AI,而你的任务是管好它的权限边界。
你敢让 agent 帮你花钱吗?如果已经试过,它帮你买对过,还是翻车过?
3
2
160

等Agent跑任务的间隙,我生成了个deepseek harness插件,把「读」和「记」都装进了Agent里
今天,我们都成了 Yes 工程师。
Agent 在跑,你在点确认。
手伸向手机,又停在半空—— 刷手机是碎的,发呆是空的。
所以我做了这个插件:澄境 | Limina 装在 DeepSeek Harness 侧栏里,不离开 Agent:
📖 订阅 RSS,播客边听边看字幕;
📚 PDF / EPUB 电子书,本地目录、百度网盘都能读;
📄 论文输入 arXiv 编号或 DOI,先看速读卡再决定读不读;
💬 读不懂的地方,右侧 AI 伴读就地问;
🔒 私密日记单独加密,模型也看不到 不注册账号,一切留在本机。 (目前仅在 macOS 上实测)
🧡 插件已开源(MIT),代码和说明都在 GitHub: github.com/BannyLon/dsh-npie…
你等 Agent 的时候,都在干嘛?评论区聊聊 👇
用飞书接上 dsh-superagent,把本地文档一键写成飞书文档。
虽然这活"豆包工作"干起来更丝滑、更便捷,但豆包要充钱啊!最便宜的会员都要 68 块,免费那点积分几下就造光了。
自己折腾一个工作流,自由多了,还省钱。
刚才我把本地写好的一篇 Markdown 长文直接丢进飞书群,艾特了一下机器人。它自己跑去检查,发现少 3 个权限,直接把要开的权限列出来发我。我在后台点一下,回句“已开通”,它立马接着干活。等了几分钟,不仅文档建好了,连原文件里乱码的格式都顺手修干净了。
不得不夸一句 DeepSeek 开源的 dsh-superagent,这架构拿来改办公流太顺手了。
原本是写代码用的原型,接进飞书后,前台派活、后台隔离干活,想切哪个模型就切哪个模型,丰俭由人。
照这个路子玩下去,只要给后台配上不同的工具和指令,完全能捏出各种岗位的数字员工——一人在群里随手派单,一支 AI 团队在后台并行干活,这才是个人玩家该有的玩法。
wcnlxr63g8kg.feishu.cn/docx/…


2
2
281

它的价值在哪里
1. 邮箱是 Muse 自己的,不是你的
地址以 muse.ai 结尾,和你的个人邮箱是分开的。
它只看得到你转给它、抄送给它的邮件,你的 Gmail 和 Outlook 它看不到。
供应商、餐厅的回信都进它的邮箱,你的收件箱保持清净,个人邮箱也不用给出去。
2. 交代任务,就像抄送一个同事
三种用法:把它拉进邮件往来,把邮件转给它,或者在聊天里让它替你发。
官方举的例子:订餐厅、约行程、追退款。
3. 它会把往来跑完
重点不是能发邮件,是能接住对方的回复,接着跟进。
Meta AI 产品副总裁 Vishal Shah 的原话:
“Add it to a thread or forward it an email, and it’ll handle the replies and follow-ups for you.”
比如找三家供应商询价,报价都发到 Muse 的邮箱,它整理成一份对比给你,你只看结论。
4. 不打开 App 也能派活
先在设置里验证你自己的邮箱。
之后从这个邮箱转给 Muse 的邮件,它会认作你本人的指令。
官方例子:转发一封活动邀请,写一句”帮我报名,加到日历”。
5. 发信前会请你批准
Muse 要发邮件时会弹出确认,你看完内容再决定同意还是拒绝。
涉及财务、健康、账号密码的邮件指令,它可能直接拒绝执行。

1
90
观察了一圈,发现一个很真实的规律:
我身边那些真正把 AI 玩明白、靠它赚到钱或者做出牛逼产品的人,英语居然全都特别溜。
不是那种应付考试的哑巴英语,是能直接看懂老外在聊什么、能顺畅交流的那种。
本来以为有了 AI 翻译,英语好不好无所谓了。结果接触的圈子越深越发现,那些真正把 AI 玩出花、每天都在进化的人,英语基本都是母语级的流畅。
倒不是说中文不能用 AI,而是最前沿的玩法全在英文环境里。
不管是 Karpathy 的长文访谈、大佬在 X 上随手发的几句思考,还是 GitHub 刚冒出来的开源项目、Discord 里的开发者社区,全是一手英文。等中文圈把教程嚼烂了喂给你,黄花菜都凉了。
而且用过就知道,跟大模型沟通也是讲究“语感”的。英文语料多,直接用英文提需求,AI 的理解就是更准、推理更深,完全是两个维度的体验。
用翻译软件倒腾来倒腾去,永远慢半拍。
英语 + AI = 降维打击。
中文 + 翻译器 + AI = 永远慢半拍。
想在 AI 时代真正 All in 的人,先把英语捡起来吧。
你认同这个观点吗?👇
4
1
186