



Mark retweeted

//地址证明集合,适用kyc以及U卡申请//
(运气成分很大,实在没有真实地址可以尝试下)
1/账单地址生成
1stbills.com
2/地址证明文件,可以用加密货币支付
1poa.org/
3/PDF制作,地址文件
addrs.xyz/
4/可生成香港、澳洲、加拿大、英国、新加坡的地址证明
docs.mimicland.click
5/美国地址生成器
meiguodizhi.com
——————————————————
⚠️最后白嫖core,貌似“政策”宽松了,抓紧时间
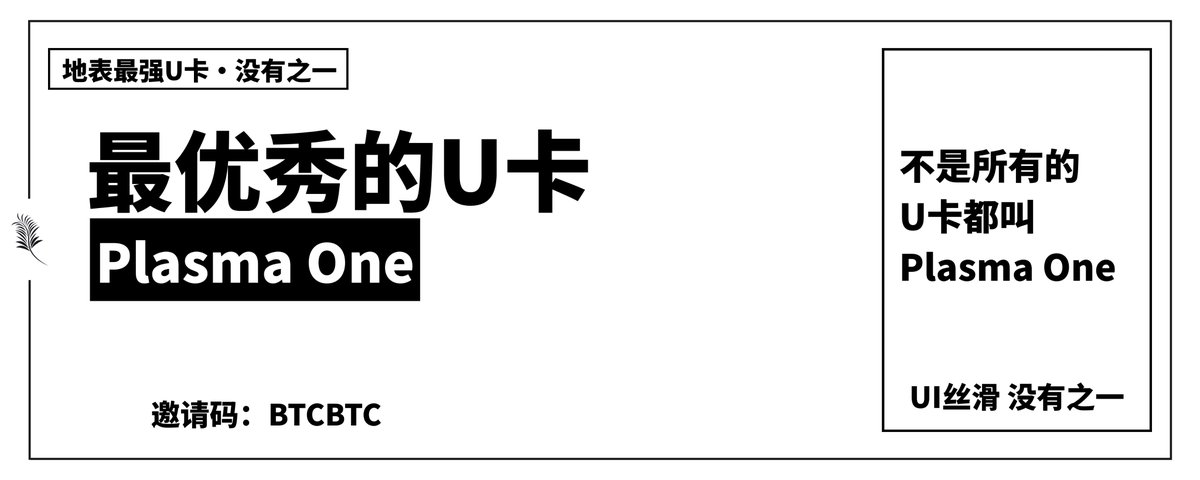
新用户填写专属邀请码:BTCBTC
消费100u,可以奖励20u
优点:
可以直接绑定美团消费,以及微信,滴滴,Apple Pay,覆盖日常消费了
在使用 Plasma One 卡首次消费满 100 U时,可获得 10 U奖励(系统自动奖励的)
如果是使用BTCBTC注册的联系我,提供自己的账户名,我再奖励10U
——————————————————
下载链接:
plasma.org/download/BTCBTC
邀请码:BTCBTC
注:有需要教程的可以看下面文章


Mark retweeted

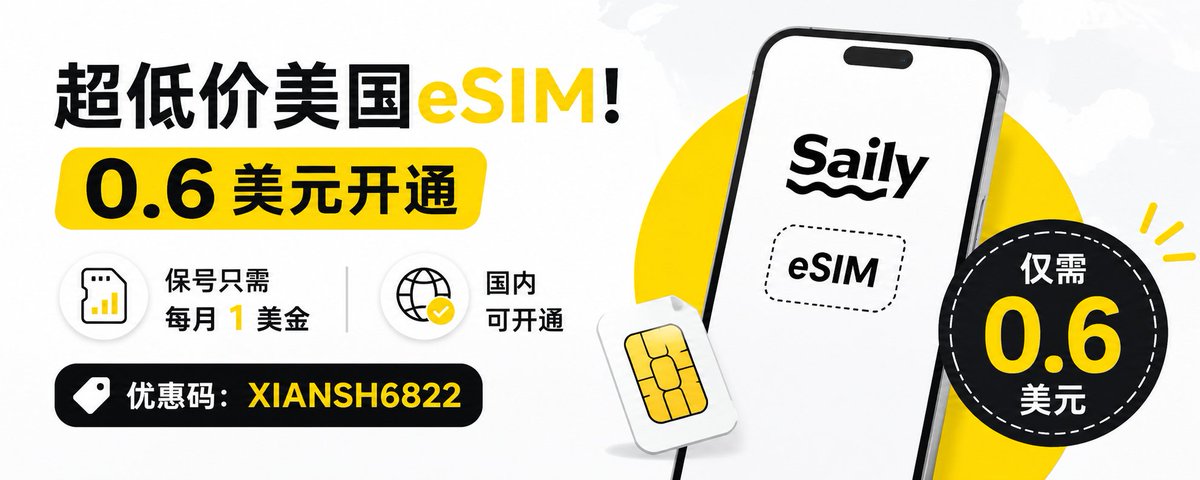
Saily eSIM依旧是最便宜的美国手机号
我用这个注册了美区 PayPal,E卡,P1,WhatsAPP,tg等应用
叠加礼券代码:XIANSH6822
只需0.99U 开卡,0.99 美金/月保号
现在身份证也可过 KYC,国内 VISA或者 U 卡支付即可
建议有美卡需求的可以试试,不用不续费即可。

Mark retweeted

郭宇在这场分享中关于「高级打工仔」与读书的核心观点,可以概括为以下三层:
一、传统路径已经失效
他明确提出,东亚社会长期推崇的“读书—考名校—成为高级知识打工人”路径,在AI时代已经逐渐失去可行性。
2025年10月Claude Code推出代码生成能力后,医生、律师等依托智力获取超额收益的知识类职业优势被大幅削弱,依靠个人智力做“高级打工人”已经不再是一个可以稳定追求的目标。
背后的逻辑是:你能使用到的智力,和你自己能获取到的智力,已经完全不成比例。
人类花十年读书只能学到皮毛,不可能每天不睡觉学完ChatGPT预训练的所有知识,而且AI还能边做边学,获取前人知识的速度远超人类。
二、读书本身的价值需要重新定义
他并没有否定读书或知识的价值,而是认为读书的目标不能再是“成为高级打工人”。
传统东亚教育的底层逻辑是“读书=不做体力劳动=阶层跨越/经济自由”,这套逻辑在工业时代成立,但在AI时代需要转向,知识不再是用来卖时间、换薪资的筹码,而是用来构建叙事、撬动智能复利的杠杆。
三、AI时代的替代方向:用智能赚复利
他提出的新方向是掌握叙事(narrative)能力,用智能赚取复利,而不是靠单次劳务换取报酬。
核心论据是:
1. AI当前尚不具备自主决定叙事方向的能力,这是人类独有的核心竞争力。
2. JK·罗琳靠《哈利·波特》叙事体系获得的长期收益,远超过影片中小演员的短期劳务收入——这就是智能复利的典型形态。
3. 叙事能力不只是写书,打造服装品牌、运营亚马逊爆款、做AI生成内容、经营个人IP,本质都是讲好故事触达用户,获取长期复利。
AI时代最关键的转变,是把自己从工业革命时代的“螺丝钉”,拔高到能够主导叙事的创造者。





Mark retweeted

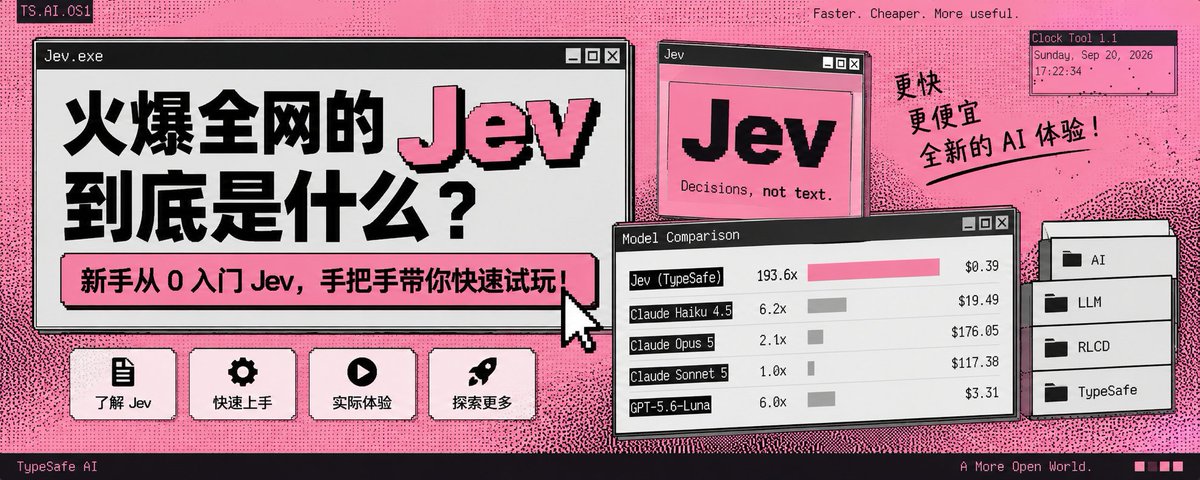
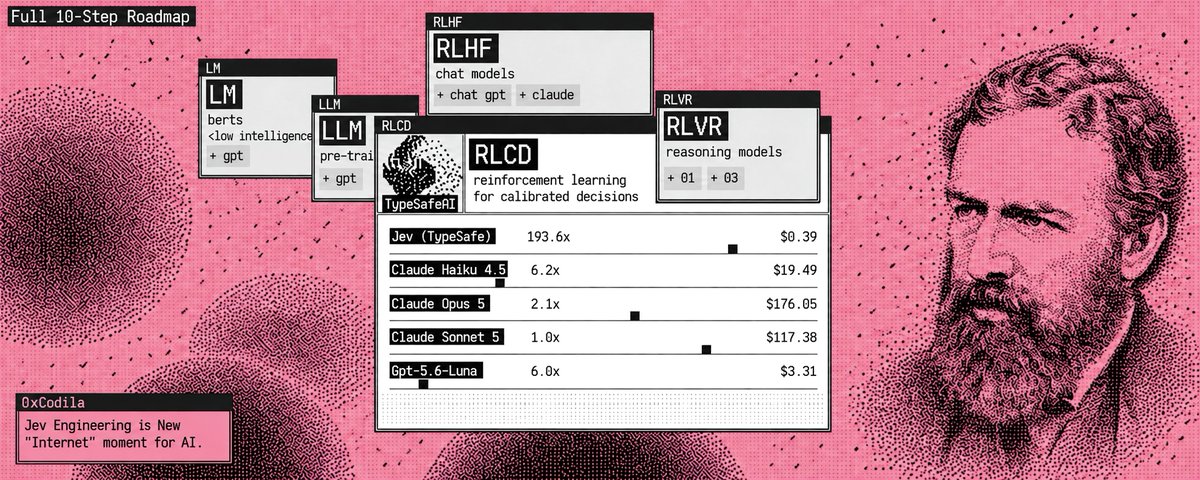
Jev is "Internet" moment for AI: up to 193x faster and 444x cheaper in tests with Claude Fable 5.1 and GPT-6 Astra
Whar is Jev, how to use and unlock its real 100х advantage in my 10-page research:
step 1 → meet Jev: LLM writes, agents act, Jev chooses the next move - split intelligence from execution
step 2 → turn every agent fork into three primitives: Choice selects one route, Score measures a defined scale, Noul returns the probability of yes
step 3 → build before getting access: use TypeSafe’s official adapter with OpenAI, Anthropic or xAI, then swap in Jev without rebuilding the graph
step 4 → setup first Jev: one state, three parallel decisions, risk-based thresholds and a real queue your agents can execute
step 5 → batch decisions instead of serializing them: 13 questions in one call ran 10x faster and 12.2x cheaper than 13 sequential calls
step 6 → place Jev at every bounded fork: choose the agent, model, tool, browser action or human escalation, then read fresh state
step 7 → benchmark the entire loop: Browser Use hit Google Flights in 7.1s, Every ran 777 checks in under 0.7s, Mobile Jev completed 9 actions in 21s
step 8 → rank wide, read narrow: Jev cut wrong Hermes skill loads from 16.8% to 7.3% and pushed legal Top-10 retrieval from 38% to 62%
step 9 → steal a system, not a prompt: Chief of Staff, model router, inbox firewall, research feed, browser controller and safety gate all use State → Questions → Action → Verify
step 10 → keep Jev out of math, writing and irreversible execution: code computes, LLMs create, Jev decides, fresh state proves the result
the result: one slow, expensive agent becomes an always-on decision machine that routes, scores and escalates in milliseconds
Copy the complete 10-page Jev blueprint - then read full 10-step roadmap below ↓


Mark retweeted

卧槽!找了半天终于找到一个能读微信聊天记录的工具了,Github 上 400 多星的 wx-cli
接入 Codex 等 AI 直接原地起飞了,想读什么都行!
➢ 全库搜索。输入关键词可以搜所有历史消息,不用微信自带的搜索框,几百条几万条都能搜。
➢ 聊天记录总结。我把微信里三百多个客户咨询的记录导出来交给 AI 让它统计分析,直接给了我很多后续改进的建议。
➢ 群聊记录分析。多个社群可以分别沉淀成文档,非常适合做私域运营需要总结群聊内容的,毕竟很多群友分享的经验都是精华啊。
➢ 本地运行。它全程只读你硬盘上的数据库文件,从头到尾不碰微信这个软件,目前自测没有封号风险。
Github 链接我放评论区了 ⬇️ 记得提前保存下

Mark retweeted

卧槽,这不就是 AI 时代的合法印钞机吗???
几分钟复刻任何!!任何!!爆款广告片,视频,街头采访……等等
换个脸换个话题,批量出 100 条同类爆款视频??你这让苦苦研究选题脚本的编导还活不活了?
项目竟然还开源了,这是什么赛博活佛啊😭
先说这玩意儿到底干了什么——
它让你的 Coding Agent(Claude Code、Codex …)真正意义上的学会了做视频
不是那种“输入一句话生成一段模糊的 AI 视频”,是真正的、完整的、带脚本带配音带字幕带 B-roll 带特效的成品视频
而且最核心的能力是:Clone!(克隆)
你丢一条爆款视频进去,一行命令,它把这条视频的整套结构拆出来
——镜头怎么切、台词怎么写、字幕什么风格、B-roll 在哪插、特效怎么触发、节奏怎么编排——全部变成可编辑的组件
然后你可以像换皮一样改:
主持人从真人换成 banana cat,话题从足球换成科技圈,语言从英文换成中文,产品从肌酸换成护肤品
同一套爆款结构,无限换壳,批量出片!!
先说传统做法有多痛
想复刻一条 20 秒的爆款短视频,正常路径是这样的:
看完原视频,手动拆解结构 → 半天 写脚本、改台词 → 半天 找素材、生成 AI 画面 → 1-2天 配音、加字幕、做特效 → 1天 剪辑、调节奏、渲染 → 半天
来回改 → 再加两天
一个人全干,最快也要 3-5 天出一条,如果你是 MCN 要批量出片,1个剪辑师一天也就出 3-5 条
而且最要命的是:每条都要从零开始,爆款结构在你脑子里,但没法复用,没法自动化
我试了一下
我随便找了一条产品推广的广告片,丢进 Claude Code,输入一行命令:
/hypit clone this video
十来分钟,成片出来了。脚本、配音、字幕、B-roll、特效,全部自动生成,直接能用
然后我做了一件更离谱的事——我说:把人物换一个
它只重新生成了人物相关的素材,其他全部复用,几分钟又出了一条
同一条广告片,换了个人物,一条新的广告就出来了
两条视频,同一套爆款结构,不同的壳,成本只有生图生视频的钱!!
这意味着什么?
作为一个做过产品的人,我看到的不只是“能复刻视频”,而是一整条内容生产线被重构了:
1、做 AI 短视频的:看到一条爆款,clone 一下,换个人设换个话题就是你的,一天能出几十条
2、MCN 和内容团队:同一套 workflow 生成不同语言、不同画幅、不同 CTA 的版本,一个人干一个团队的活
3、做知识付费的:课程视频、引流视频,定义好一套模板,批量生成变体
4、接广告的:客户给一条参考视频,你 clone 完改改就能交付,以前报价几千块的活现在成本几块钱
以前做短视频是手艺活,靠的是剪辑师的经验和时间
现在变成了工程化的事——爆款结构可以被代码化、组件化、版本管理、批量复制
你可能会问:这和其他 AI 视频工具有什么区别?
说几个关键的:
它不是视频生成模型
Seedance、Sora 这些是生成素材的,但“生成素材”不等于“完成一支视频”
完整视频还需要脚本、配音、字幕、剪辑、B-roll、特效、编排和渲染
这个项目解决的是后面这一整套
它不是传统剪辑工具,不拖时间线,用代码控制视频。所有元素不是钉在时间线的某一秒上,而是挂在对应的台词文字上——改一句话,整段视频跟着变
它不是套模板的一键生成。你可以修改任何组件,甚至从零构建自己的 workflow
而且,开源的,免费的,代码全在 GitHub 上
这个项目叫 Hypit
一句话说就是:给 AI Agent 做视频的开源语言和编译系统
Clone any viral video with AI agents
一定不要忘了去 GitHub 给它点个 Star,毕竟这波确实是赛博活佛了,咱们拿走成果也得留个star上去!👇
github.com/hypit-ai/hypit
🤝 Paid partnership
Mark retweeted

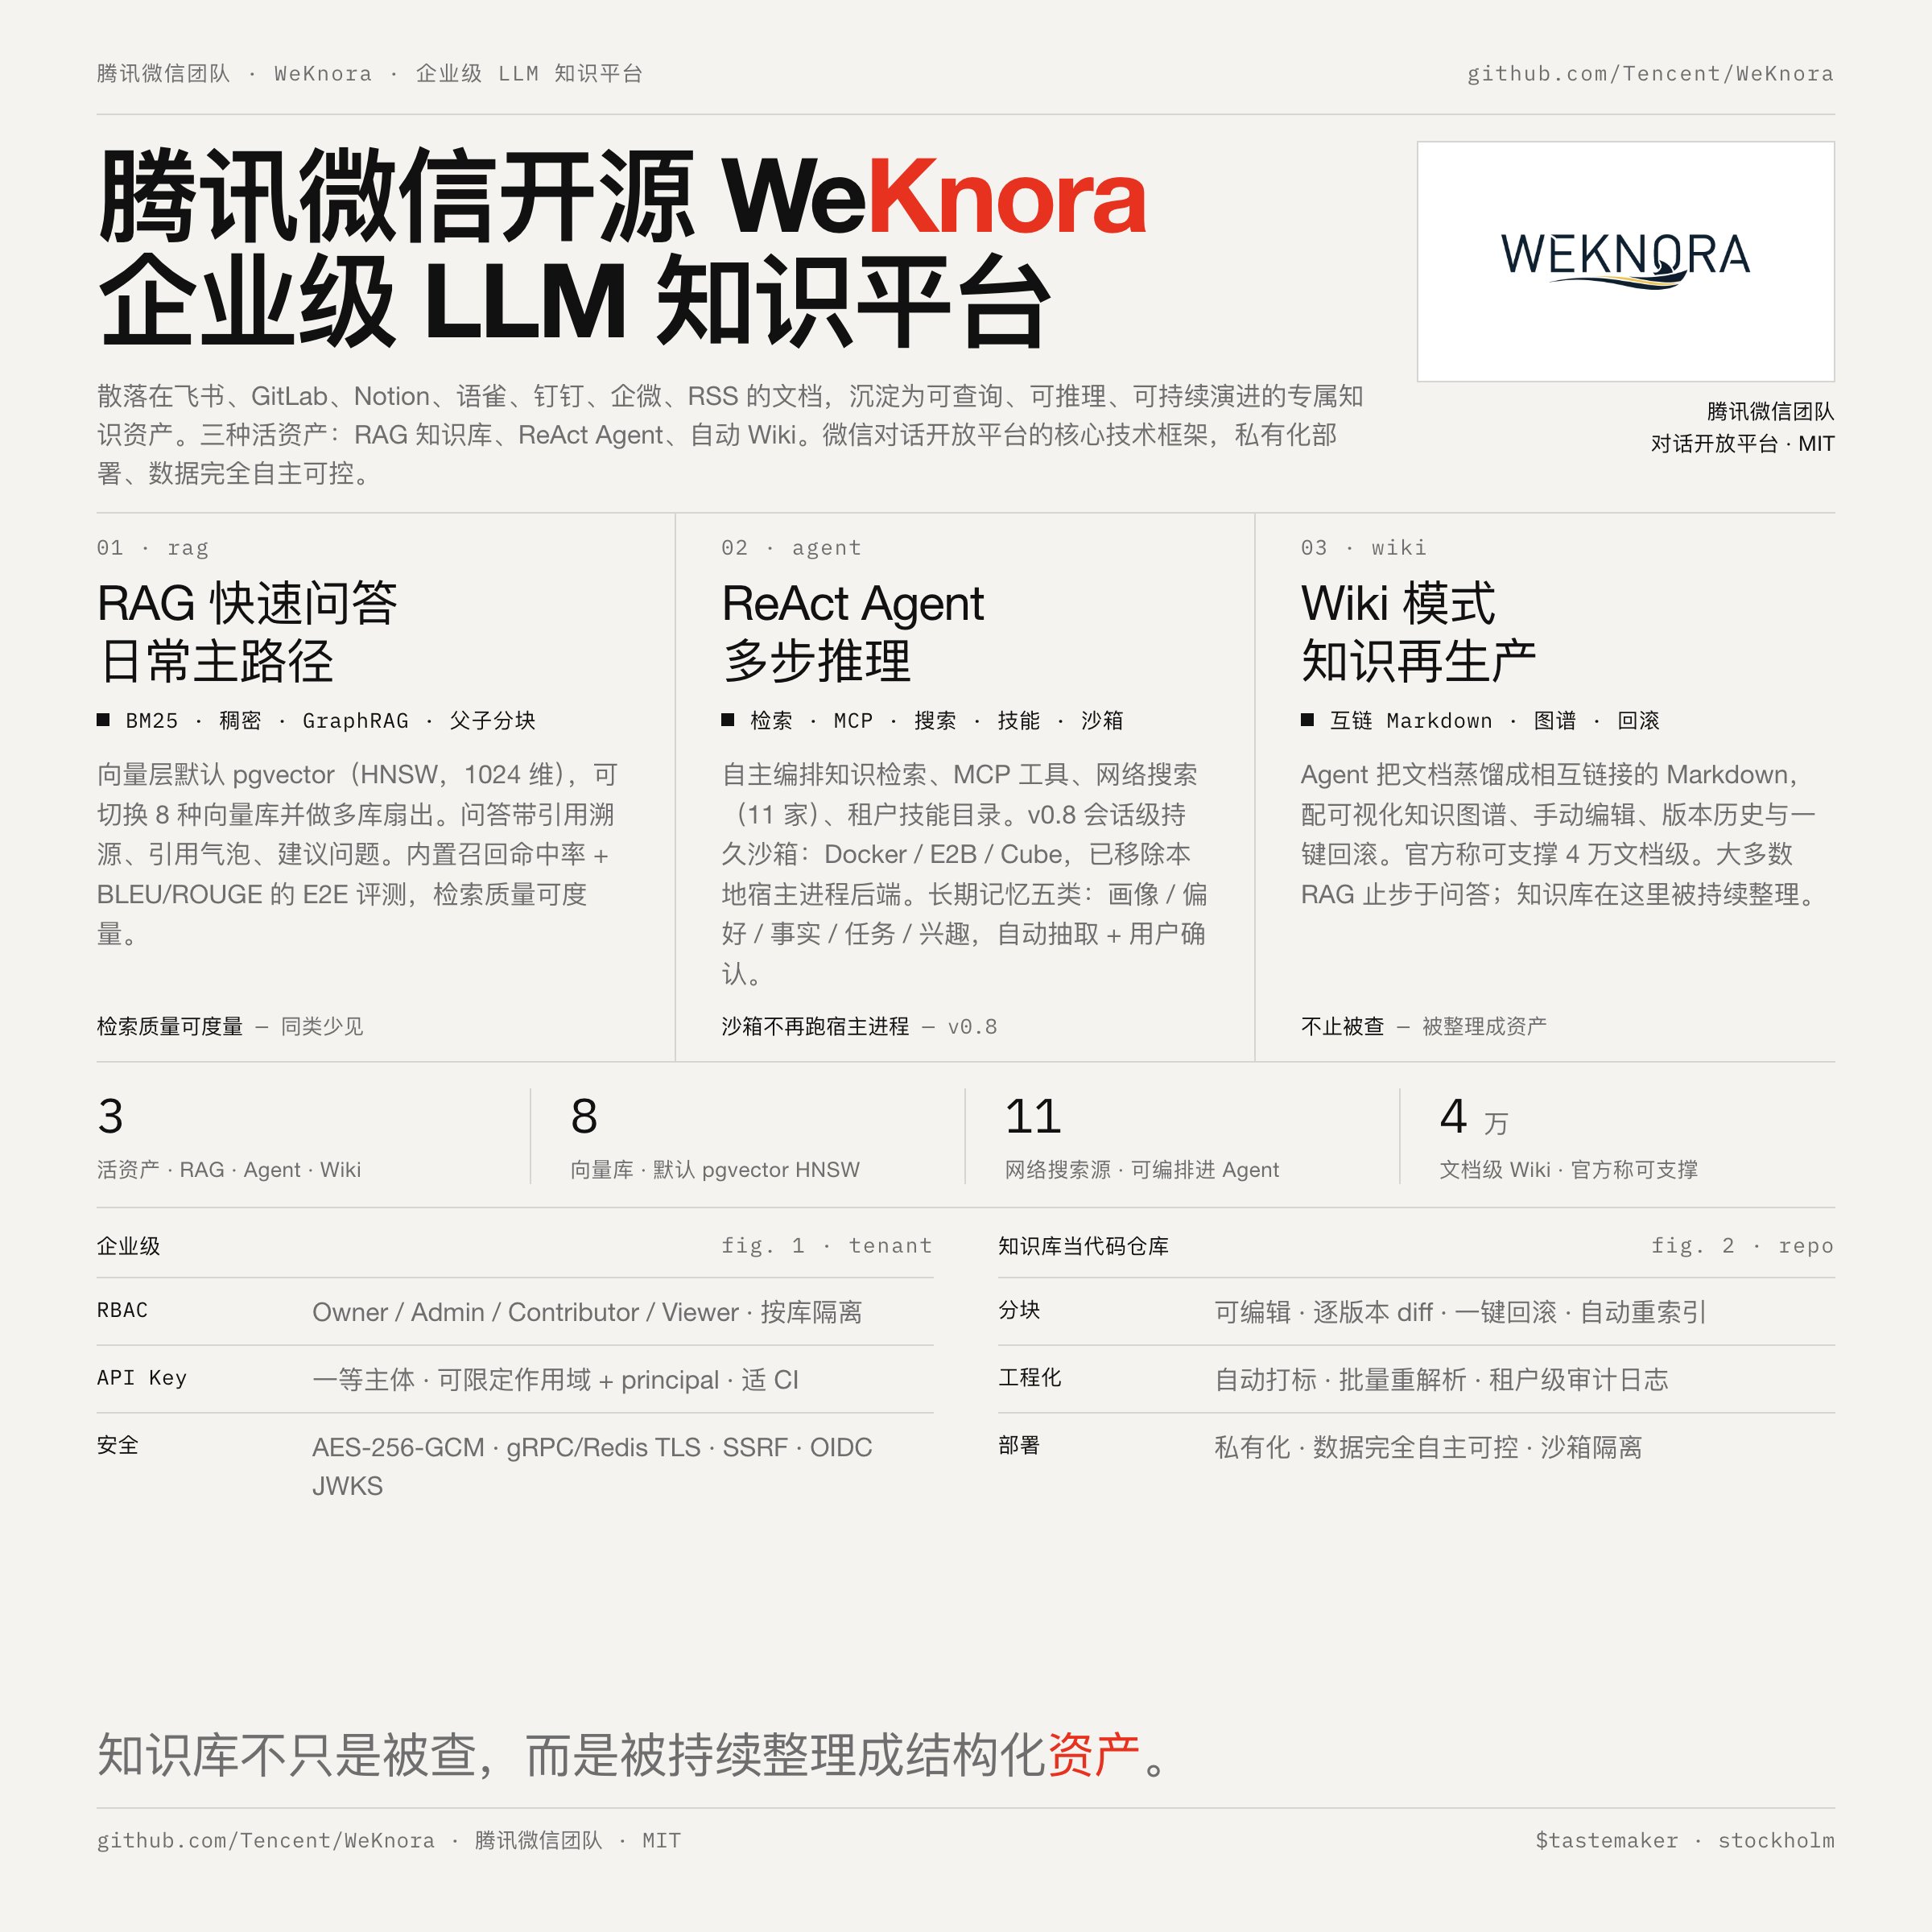
腾讯微信团队开源了「企业级 LLM 知识平台」:WeKnora
WeKnora 把散落的原始文档转化为三种知识库资产:可问答的 RAG 知识库、可自主推理的 ReAct Agent、可持续演进的自动 Wiki。并且它是微信对话开放平台的核心技术框架,有真实生产背书。
项目地址:github.com/Tencent/WeKnora
WeKnora 解决什么问题?
企业知识天然是碎片化的:文档散落在飞书、GitLab、Notion、语雀、钉钉、企微、RSS 等各处。WeKnora 的答案是把这些内容“沉淀为可查询、可推理、可持续演进的专属知识资产”,同时强调私有化部署、数据完全自主可控。
# 三个核心能力
1. RAG 快速问答:日常查询的主路径。检索上支持 BM25 稀疏检索、稠密向量、GraphRAG、父子分块等策略组合;向量层默认用 pgvector(HNSW 索引,1024 维),可切换 8 种向量库并做多库扇出检索。问答带引用溯源、引用气泡、建议问题,还内置了用召回命中率 + BLEU/ROUGE 做 E2E 效果评测的工具——这在同类项目中少见,说明团队认真对待“检索质量可度量”这件事。
2. ReAct Agent 智能推理:面向复杂多步任务。Agent 可自主编排知识检索、MCP 工具、网络搜索(11 家搜索源)、租户技能目录,以及 v0.8 新增的会话级持久沙箱(Docker / E2B / Cube 三种后端,v0.8 起移除了本地宿主进程后端,安全上更收紧)。配套跨会话长期记忆(画像/偏好/事实/任务/兴趣五类,自动抽取 + 用户确认)。
3. Wiki 模式:WeKnora 最差异化的能力。Agent 自动把文档蒸馏成相互链接的 Markdown 知识库,配可视化知识图谱、手动编辑、版本历史与一键回滚,官方称可支撑 4 万文档级的知识库。大多数 RAG 项目止步于“问答”,WeKnora 额外给出了“知识再生产”的输出形态;知识库不只是被查,而是被持续整理成结构化资产。
企业级能力
· 多租户 + 四级 RBAC(Owner / Admin / Contributor / Viewer),按知识库的 ownership 隔离,租户级审计日志;
· API Key 作为一等主体:可限定作用域的密钥 + principal 模型,适合 headless/CI 集成;
· 安全:凭据 AES-256-GCM 加密、gRPC/Redis TLS、SSRF 加固的 HTTP 客户端、OIDC JWKS 验证、沙箱隔离;
· 知识库工程化:分块可编辑、带逐版本 diff 与回滚、自动重索引,自动打标、批量重解析——把知识库当“代码仓库”来管理,这个思路成熟。

Put your team’s knowledge to work.
Developed by Tencent’s Weixin team, WeKnora is an open-source, LLM-powered knowledge framework built for enterprise-grade document understanding, semantic retrieval, and autonomous reasoning.
Build assistants that find answers in your docs, show their sources and use skills to create files you can preview and download.
Keep useful context across chats with opt-in long-term memory. You approve suggested memories before they’re used. Self-host it and run skills in a sandbox with network limits you set.
Explore WeKnora: github.com/Tencent/WeKnora
Have a project in mind? Join our community to share ideas and build with us: github.com/Tencent/WeKnora/i…

Mark retweeted

GPT 6 Astra最正确的打开方式
Prompt:
基于你对我过去所有对话、经历、能力、职业处境、资源、行为模式和风险偏好的了解,对我做一次系统性诊断,并给出一组真正可能显著改变我未来 3–5 年轨迹的建议。
要求:
- 不要安慰、迎合,也不要给泛泛而谈的正确废话。
- 找出我当前最关键的 3–5 个瓶颈、风险和机会,按重要性排序。
- 重点指出我自己没有意识到的盲点,以及哪些事情我应该立刻停止。
- 建议必须基于我的真实现状,考虑现实约束、机会成本和可执行性。
- 对每条核心建议说明:为什么重要、为什么适合我、具体怎么做、不做的代价是什么。
- 给出未来 30 天、90 天和 1 年的行动重点。
- 如果只能让我做一个改变,请明确告诉我是什么。
- 最后给出我未来 3 年最重要的一条主线,以及判断工作、投资、创业和学习机会时应遵循的决策原则。
请严格、冷静、具体地回答。宁可只给 5 条真正重要的建议,也不要给 20 条正确但无用的建议。
请大家记住,
带来物理现实世界的改变,是最有价值的
Mark retweeted

🚨 ÚLTIMA HORA: CHATGPT ahora puede crearte un canal completo de YouTube con IA, como una agencia que genera $10,000 al mes.
Gratis.
Aquí tienes 7 prompts para pasar de 0 → canal monetizado en 90 días:


Mark retweeted

做自媒体必备的7 个 Agent Skills
从拆选题、找对标、写稿、起标题、做配图,到最后落进飞书,基本覆盖了博主的一整套工作流。
我把它整理了一份公开合集👇
1、DBS / dbskill
我用得最多的一套。商业诊断、内容、Hook、AI 味、对标和小红书标题都有。
平时直接用 /dbs,或者单独调用 /dbs-hook、/dbs-ai-check。
作者是 dont 哥:@dontbesilent
github.com/dontbesilent2025/…
2、小红书标题 Skill
我自己研究的“8 个模板+情绪叠加+字词推敲”,和 DBS 的 75 个公式是两套思路,但其实本质上差不多,大家可以都试试,哪个适合用哪个。
github.com/ren644/xhs-title-…
3、Blogger Distiller
拆解小红书、抖音博主,还能生成一套创作 Skill。
github.com/otter1101/blogger…
4、小黑配图 Skill
来自 @ianneo_ai ,适合把文章做成白底手绘正文图。我每篇公众号必备的配图 skill,属于最佳配图 skill。
github.com/helloianneo/ian-x…
5、藏师傅的材质插画
更适合解释图、机制图和图表美化,作者 @op7418
github.com/op7418/guizang-ma…
6、小红书关键词 Skill
我整理的关键词工作流:确定搜索意图和主关键词,再把标题、封面、正文和标签对齐。
github.com/ren644/xhs-title-…
7、飞书官方 Skills
文档、Base、任务、日历和消息都能直接操作。
github.com/larksuite/cli
这 7 个基本就是我的内容工作流:
DBS 拆问题 → Blogger Distiller 找对标 → 写稿和标题 → 小黑、归藏做图 → 关键词布局 → 飞书落地。
甚至我看现在还有剪辑视频的 Chatcut,等我单独出一期内容,我测一下效果再跟大家分享。


Mark retweeted

刚开源就冲到 9000 Star,GPT-Image2 这个提示词库的涨星速度确实少见。
它核心就干两件事:一套工业级的提示词引擎,加一个持续扩充的模板库,而且还在每天更新。
不用自己反复试错 prompt,直接拿现成的结构去套,出图稳定不少。
我翻了几天,至少省下了以前用来试参数的大把时间。
🔗 github.com/freestylefly/awes…
另外还有GPT images 2 提示词合集。
这批提示词跑出来的图,质感跟细节确实有点东西,普通人根本想不到还能这么玩。
整包 3.9GB 爆款素材,全是市面上热度最高的那批,拿来直接用。
🔗pan.quark.cn/s/9c4acb543dce

Mark retweeted

最近 X 上好多大神开源自己的视频工作流
站在巨人的肩膀上
很多 Skill 都可以拿去制作视频变现了
161个视频动效 Skill:
1️⃣@VincentWei93 :Vincentwei1021 / video-shotcraft
小红书穿搭变装 Skill:
1️⃣@liyue_ai :liyue-aigc/female-outfit-director
漫画视频 Skill:
1️⃣@GeekCatX :gnipbao / story-to-handdrawn-video
Vox 视频 Skill:
1️⃣@alisaqqt :Alisa0808/vox-director
2️⃣@pyang1235005 : pyang5166 / gbro-collage-broll
国风古诗词视频 Skill:
1️⃣@Hamburgerai :Mr-funny / hbg-classical-poem-silk-video
图书号视频 Skill:
1️⃣@Bytec99 :bytec-ai / book-video-factory
2️⃣@endless1936:Endless1936 / book-video
欢迎评论区补充更多的视频 Skill~