

reserve@irc, 9bow@github. 넓은 오지랖과 짧은 인내심, 그리고 채워지지 않는 지적 허영을 가진 게으름뱅이 INTP. 키보드와 주둥이로 먹고 삽니다.
Korea
Joined June 2009
- Tweets1.7K
- Following494
- Followers727
- Likes670






Junghwan Park retweeted

Hey @Zai_org , why does ZCode silently pack entire workspaces + full .git history and upload to Aliyun OSS on login?
- Server holds the only decryption key
- No UI toggle to disable
- Zero disclosure in privacy policy
Full forensics & fix:
blog.ferstar.org/en/posts/zc…

Legalize-KR 업데이트 소식 #1
Chrome Viewer를 추가하고, 행정규칙과 자치법규 이력, 누락 감사, 정부조직 이력을 보강했습니다. 입법 저장소 및 문서 간 관계도 준비 중입니다.
- 홈페이지: legalize.kr/
- Viewer: legalize.kr/viewer.html
#legalize_kr #korean_law

#5. 감사드립니다
Viewer의 HWP/HWPX 미리보기용 rhwp 개발자 Edward Kim님께 감사드립니다: github.com/edwardkim/rhwp
그 외 첨부 원본 보존과 법령 내 이미지 처리 방식은 아직 고민 중입니다. 댓글이나 contact@legalize.kr로 의견/아이디어 부탁드립니다!
#legalize_kr #korean_law #rhwp

#4. 향후 계획: 입법 저장소(bill-kr)과 문서 간 관계 정리
먼저 제22대 국회 의안 19,616건과 정부입법 자료를 정리 중이며, 법령 연결 부분이 고민입니다.
문서 간 관계는 먼저 약 899만 개 항목과 115만 개 관계를 생성했는데, 저장소 관리 방법 변경이 고민됩니다. 의견 부탁드립니다!
#3. 데이터와 이력
행정규칙(과거 발령본) 및 자치법규(개정 및 폐지 이력) 저장소를 Git History로 보강했습니다. 누락, 경로 이동, 일시적인 API 오류, 폐지 문서 반영도 매일 검사합니다.
정부조직 이력 저장소도 추가했습니다:
github.com/legalize-kr/gov-o…

#2. Chrome Viewer
법령, 판례, 행정규칙, 자치법규를 검색하고 Markdown 본문과 개정 이력을 비교할 수 있는 Chrome Extension입니다. HWP, HWPX, PDF, 이미지 첨부 미리보기도 제공합니다.
읽기 전용이며 토큰과 설정은 브라우저에만 저장됩니다:
chromewebstore.google.com/de…

Junghwan Park retweeted

PyTorch Day Korea 2026! 올해 슬로건과 일자를 공개합니다!
🌟 “Torch YAHO!” 🌟
2026.10.31 - 센터필드 이스트 18층 AWS 코리아 교육장
PyTorch를 사용하는 연구자, 엔지니어, 개발자들이 모여
모델 개발부터 최적화, 서빙, AI Application까지 이어지는 다양한 경험을 함께 나눕니다.
(1/3)
🤖 Made with AI

Junghwan Park retweeted
Liquid AI, 엣지용 350M 모델 LFM2.5와 다국어 검색 리트리버 LFM2.5 Retrievers 공개
(by 9bow님)
d.ptln.kr/10808
#llm #ondevice #embedding #productlaunch #retrieval #liquidai #colbert #lfm

PyTorchKR의 새로운 글 알람을 받아보실 수 있는 채널입니다:
- Telegram: t.me/pytorchkr
- Slack, Discord, MS Teams, Google Chat 등: discuss-noti.pytorch.kr
- X: @PyTorchKR
개선 또는 앞으로 더 다루었으면 하는 주제에 대한 의견이 있으시면 댓글 부탁드립니다! 🙏 #PyTorchKR


10. EvolveMem: 장기 기억 시스템에서 저장 내용뿐 아니라 검색 점수 함수와 융합 전략까지 함께 진화시키는 자기진화형 메모리 아키텍처를 제안합니다.
arxiv.org/abs/2605.13941

9. Lost in Tokenization: 그래프 토큰화 방식이 트랜스포머의 표현력과 깊이 요구를 근본적으로 바꾼다는 이론을 제시하며, 랜덤 워크·스펙트럴 토큰화의 한계를 분석합니다.
arxiv.org/abs/2605.22471

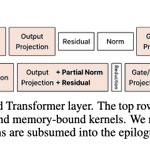
8. CODA: 트랜스포머의 비어텐션 연산을 GEMM의 epilogue로 재작성해, 메모리 이동 병목을 줄이고 학습 커널을 더 효율적으로 만드는 GPU 커널 추상화를 제안합니다.
arxiv.org/abs/2605.19269

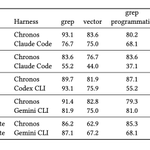
7. Is Grep All You Need?: 에이전트 검색에서 벡터 검색보다 grep 같은 렉시컬 검색이 더 잘 작동할 수 있음을 보이며, 검색기보다 하네스와 결과 전달 방식이 성능을 좌우할 수 있음을 강조합니다.
arxiv.org/abs/2605.15184

6. Agentic Discovery of Neural Architectures: LLM 에이전트가 트랜스포머를 넘어 새로운 신경망 아키텍처와 학습 메커니즘을 자율적으로 발견할 수 있음을 보입니다.
arxiv.org/abs/2605.15871


5. Code as Agent Harness: 코드를 단순한 출력물이 아니라 에이전트의 추론, 행동, 메모리, 검증을 연결하는 운영 기반으로 보는 관점을 정리한 서베이입니다.
arxiv.org/abs/2605.18747

4. Embedding by Elicitation: 시스템 프롬프트를 점수 기반 블랙박스 최적화 문제로 보고, LLM이 해석 가능한 특징 공간을 유도하도록 해 베이지안 최적화를 수행합니다.
arxiv.org/abs/2605.19093

3. SlimQwen: 대규모 혼합 전문가(mixture-of-experts, MoE) 모델의 사전학습 단계에서 구조적 가지치기와 지식 증류가 어떻게 가장 효과적으로 결합되는지 체계적으로 분석합니다.
arxiv.org/abs/2605.08738

2. Billion-Scale Graph Foundation Models: 대규모 이종 그래프를 위한 그래프 파운데이션 모델(Graph Foundation Model, GFM) 레시피를 제시하며, 스케일링 법칙과 안정적인 학습·파인튜닝 전략을 보여 줍니다.
arxiv.org/abs/2602.04768

1. Multi-Stream LLMs: 읽기, 사고, 행동을 하나의 단일 스트림에 묶던 기존 LLM 구조의 병목을 분리해, 병렬 스트림 기반 에이전트 추론 구조를 제안합니다.
arxiv.org/abs/2605.12460